


 Дом
Volcano Engine представляет Doubao Audio Model 1.0: кинематографическое звуковое сопровождение на основе одного предложения и единообразные голоса персонажей на 10 минут
Вчера компания Volc Engine официально представила модель генерации аудио Doubao 1.0 (Doubao-Seed-Audio 1.0), которая принимает текстовый или аудиоввод и создает полноценные аудиопроизведения от начала до конца. Её ключевым прорывом является то, что один-единственный запрос позволяет одновременно обрабатывать диалоги, звуковые эффекты и фоновую музыку, избавляя от необходимости ручного многодорожечного монтажа.
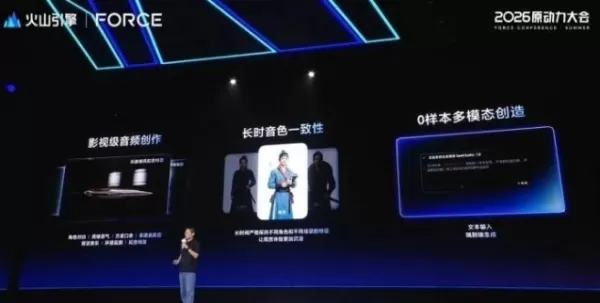
Превратите предложение в аудиорежиссёра — без необходимости постобработки.
Ранее для создания высококачественного аудио требовалось отдельно генерировать диалоги, звуковые эффекты и музыку, а затем вручную синхронизировать и микшировать дорожки — сложный процесс, зависящий от опыта в области постпродакшна. Модель генерации аудио Doubao 1.0 объединяет все это в одном запросе: пользователи могут определить реплики нескольких персонажей, их интонацию и эмоциональный ритм в одной инструкции, добавить такие детали, как смех, вздохи, паузы и диалектные акценты, а также одновременно сгенерировать фоновую музыку и окружающие звуковые эффекты, получая готовый продукт напрямую. Создатель контента может ввести описание и сразу же получить готовый к выпуску подкаст, аудиокнигу или фирменный аудиоролик.
Стабильные голоса персонажей на протяжении всего длинного аудиозаписи без потери качества.
Самая большая сложность при создании длинных аудиозаписей — это обеспечение стабильности: необходимо, чтобы персонаж звучал одинаково как на первой, так и на десятой минуте. Модель генерации аудио Doubao 1.0 глубоко интегрирует преобразование текста в аудио с эталонным аудио, поддерживая стабильное качество голоса на протяжении длинных отрезков, благодаря чему авторам не приходится сравнивать и корректировать каждую часть. Текущая версия модели поддерживает генерацию аудио продолжительностью до 2 минут за один цикл, а благодаря функции расширения она сохраняет стабильность голоса в более длинных записях, что подходит для аудиокниг, подкастов и длинных сериалов.
Кроме того, модель предлагает раздельное управление голосом и стилем, позволяя одному и тому же голосу адаптироваться к различным эмоциям и контекстам — и даже давая возможность одному голосу озвучивать несколько ролей с разными интонациями. Это значительно повышает гибкость при озвучивании персонажей и творческом производстве аудиоконтента. В настоящее время Volc Ark открыл тестирование API, и отдельные пользователи могут получить квоту на создание контента объемом 30 минут в Experience Center. Модель генерации аудио Doubao 1.0 также будет запущена в таких продуктах, как CapCut, Jiemod и Tomato.
Связанная статья
 Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,
Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Рекомендации по связанным специальным темам
SEO
 Лучшие инструменты для анализа результатов поиска с помощью ИИ при разработке поисковой стратегии
XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
 13 инструментов
 xix.ai
Анализ данных
Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

 Комментарии (1)
![StevenNelson]()
Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊
Вчера компания Volc Engine официально представила модель генерации аудио Doubao 1.0 (Doubao-Seed-Audio 1.0), которая принимает текстовый или аудиоввод и создает полноценные аудиопроизведения от начала до конца. Её ключевым прорывом является то, что один-единственный запрос позволяет одновременно обрабатывать диалоги, звуковые эффекты и фоновую музыку, избавляя от необходимости ручного многодорожечного монтажа.
Превратите предложение в аудиорежиссёра — без необходимости постобработки.
Ранее для создания высококачественного аудио требовалось отдельно генерировать диалоги, звуковые эффекты и музыку, а затем вручную синхронизировать и микшировать дорожки — сложный процесс, зависящий от опыта в области постпродакшна. Модель генерации аудио Doubao 1.0 объединяет все это в одном запросе: пользователи могут определить реплики нескольких персонажей, их интонацию и эмоциональный ритм в одной инструкции, добавить такие детали, как смех, вздохи, паузы и диалектные акценты, а также одновременно сгенерировать фоновую музыку и окружающие звуковые эффекты, получая готовый продукт напрямую. Создатель контента может ввести описание и сразу же получить готовый к выпуску подкаст, аудиокнигу или фирменный аудиоролик.
Стабильные голоса персонажей на протяжении всего длинного аудиозаписи без потери качества.
Самая большая сложность при создании длинных аудиозаписей — это обеспечение стабильности: необходимо, чтобы персонаж звучал одинаково как на первой, так и на десятой минуте. Модель генерации аудио Doubao 1.0 глубоко интегрирует преобразование текста в аудио с эталонным аудио, поддерживая стабильное качество голоса на протяжении длинных отрезков, благодаря чему авторам не приходится сравнивать и корректировать каждую часть. Текущая версия модели поддерживает генерацию аудио продолжительностью до 2 минут за один цикл, а благодаря функции расширения она сохраняет стабильность голоса в более длинных записях, что подходит для аудиокниг, подкастов и длинных сериалов.
Кроме того, модель предлагает раздельное управление голосом и стилем, позволяя одному и тому же голосу адаптироваться к различным эмоциям и контекстам — и даже давая возможность одному голосу озвучивать несколько ролей с разными интонациями. Это значительно повышает гибкость при озвучивании персонажей и творческом производстве аудиоконтента. В настоящее время Volc Ark открыл тестирование API, и отдельные пользователи могут получить квоту на создание контента объемом 30 минут в Experience Center. Модель генерации аудио Doubao 1.0 также будет запущена в таких продуктах, как CapCut, Jiemod и Tomato.








 Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
 Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три

XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊












