


 Heim
Volcano Engine bringt „Doubao Audio Model 1.0“ auf den Markt: Filmreifer Sound für einen einzigen Satz, einheitliche Charakterstimmen für 10 Minuten
Gestern hat Volc Engine offiziell das „Doubao Audio Generation Model 1.0“ (Doubao-Seed-Audio 1.0) vorgestellt, das Text- oder Audioeingaben verarbeitet, um von Anfang bis Ende vollständige Audiowerke zu erzeugen. Der entscheidende Durchbruch besteht darin, dass eine einzige Eingabeaufforderung Dialoge, Soundeffekte und Hintergrundmusik gemeinsam verarbeiten kann, wodurch die manuelle Mehrspurbearbeitung entfällt.
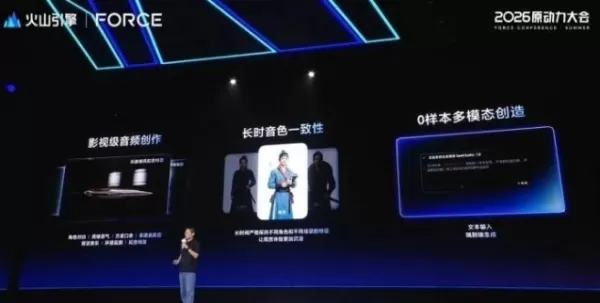
Verwandeln Sie einen Satz in einen Audio-Regisseur – ganz ohne Nachbearbeitung.
Bisher erforderte die Erstellung hochwertiger Audioinhalte die separate Generierung von Dialogen, Soundeffekten und Musik sowie das anschließende manuelle Abgleichen und Abmischen der Spuren – ein komplexer Prozess, der Fachwissen in der Postproduktion erforderte. Das Doubao Audio Generation Model 1.0 fasst all dies in einer einzigen Eingabe zusammen: Nutzer können die Zeilen, den Tonfall und den emotionalen Rhythmus mehrerer Charaktere in einer einzigen Anweisung definieren, Details wie Lachen, Seufzer, Pausen und dialektale Akzente einbetten sowie gleichzeitig Hintergrundmusik und Umgebungsgeräusche generieren, wodurch direkt ein fertiges Produkt ausgegeben wird. Ein Creator kann eine Beschreibung eingeben und erhält sofort einen Podcast, ein Hörbuch oder ein Markenaudio, das zur Veröffentlichung bereit ist.
Konsistente Charakterstimmen über die gesamte Länge des Audios hinweg, ohne an Qualität einzubüßen.
Die größte Herausforderung bei der Erstellung langer Audioinhalte ist die Konsistenz – sicherzustellen, dass eine Figur in der ersten Minute genauso klingt wie in der zehnten. Das Doubao Audio Generation Model 1.0 integriert die Text-zu-Audio-Umwandlung tiefgreifend mit Referenzaudio und gewährleistet so eine gleichbleibende Stimmqualität über lange Abschnitte hinweg, sodass Kreative nicht jeden Teil einzeln vergleichen und überarbeiten müssen. Das aktuelle Modell unterstützt bis zu 2 Minuten Audio pro Generierung und bewahrt dank der Erweiterungsfunktion die Stimmkonsistenz auch bei längeren Ausgaben, was sich besonders für Hörbücher, Podcasts und lange Serien eignet.
Zudem ermöglicht das Modell eine entkoppelte Steuerung von Stimme und Stil, sodass sich dieselbe Stimme an verschiedene Emotionen und Kontexte anpassen lässt – sogar so, dass eine einzige Stimme mehrere Rollen mit unterschiedlichen Ausdrucksweisen darstellen kann. Dies erhöht die Flexibilität bei der Sprachausgabe von Charakteren und der kreativen Audioproduktion erheblich. Derzeit hat Volc Ark den API-Testbetrieb eröffnet, und einzelne Nutzer können im Experience Center ein Erstellungskontingent von 30 Minuten erhalten. Das Doubao Audio Generation Model 1.0 wird außerdem in Produkten wie CapCut, Jiemod und Tomato eingeführt.
Verwandter Artikel
 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
Empfehlungen zu verwandten Spezialthemen
SEO
 Die besten KI-Tools zur SERP-Analyse für die Suchstrategie
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
 13 Tools
 xix.ai
Datenanalyse
Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

 Kommentare (1)
![StevenNelson]()
Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊
Gestern hat Volc Engine offiziell das „Doubao Audio Generation Model 1.0“ (Doubao-Seed-Audio 1.0) vorgestellt, das Text- oder Audioeingaben verarbeitet, um von Anfang bis Ende vollständige Audiowerke zu erzeugen. Der entscheidende Durchbruch besteht darin, dass eine einzige Eingabeaufforderung Dialoge, Soundeffekte und Hintergrundmusik gemeinsam verarbeiten kann, wodurch die manuelle Mehrspurbearbeitung entfällt.
Verwandeln Sie einen Satz in einen Audio-Regisseur – ganz ohne Nachbearbeitung.
Bisher erforderte die Erstellung hochwertiger Audioinhalte die separate Generierung von Dialogen, Soundeffekten und Musik sowie das anschließende manuelle Abgleichen und Abmischen der Spuren – ein komplexer Prozess, der Fachwissen in der Postproduktion erforderte. Das Doubao Audio Generation Model 1.0 fasst all dies in einer einzigen Eingabe zusammen: Nutzer können die Zeilen, den Tonfall und den emotionalen Rhythmus mehrerer Charaktere in einer einzigen Anweisung definieren, Details wie Lachen, Seufzer, Pausen und dialektale Akzente einbetten sowie gleichzeitig Hintergrundmusik und Umgebungsgeräusche generieren, wodurch direkt ein fertiges Produkt ausgegeben wird. Ein Creator kann eine Beschreibung eingeben und erhält sofort einen Podcast, ein Hörbuch oder ein Markenaudio, das zur Veröffentlichung bereit ist.
Konsistente Charakterstimmen über die gesamte Länge des Audios hinweg, ohne an Qualität einzubüßen.
Die größte Herausforderung bei der Erstellung langer Audioinhalte ist die Konsistenz – sicherzustellen, dass eine Figur in der ersten Minute genauso klingt wie in der zehnten. Das Doubao Audio Generation Model 1.0 integriert die Text-zu-Audio-Umwandlung tiefgreifend mit Referenzaudio und gewährleistet so eine gleichbleibende Stimmqualität über lange Abschnitte hinweg, sodass Kreative nicht jeden Teil einzeln vergleichen und überarbeiten müssen. Das aktuelle Modell unterstützt bis zu 2 Minuten Audio pro Generierung und bewahrt dank der Erweiterungsfunktion die Stimmkonsistenz auch bei längeren Ausgaben, was sich besonders für Hörbücher, Podcasts und lange Serien eignet.
Zudem ermöglicht das Modell eine entkoppelte Steuerung von Stimme und Stil, sodass sich dieselbe Stimme an verschiedene Emotionen und Kontexte anpassen lässt – sogar so, dass eine einzige Stimme mehrere Rollen mit unterschiedlichen Ausdrucksweisen darstellen kann. Dies erhöht die Flexibilität bei der Sprachausgabe von Charakteren und der kreativen Audioproduktion erheblich. Derzeit hat Volc Ark den API-Testbetrieb eröffnet, und einzelne Nutzer können im Experience Center ein Erstellungskontingent von 30 Minuten erhalten. Das Doubao Audio Generation Model 1.0 wird außerdem in Produkten wie CapCut, Jiemod und Tomato eingeführt.








 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
 Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek

Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊












