


 Дом
Политика Cloudflare вынуждает компании, работающие с ИИ, платить издателям за использование их контента.
Cloudflare установила новый срок для индустрии ИИ, требуя отделить веб-краулеры, используемые традиционными поисковыми системами, такими как Google Search, от тех, что предназначены для агентов ИИ и процесса обучения. Как сообщила компания в среду, начиная с 15 сентября 2026 года стандартные настройки Cloudflare будут блокировать краулеры смешанного назначения на всех страницах, отображающих рекламу.
Это означает, что краулеры, объединяющие функции поиска, работы агентов и обучения, по умолчанию не смогут получать доступ к таким сайтам, если только владельцы сайтов не скорректируют настройки вручную. По словам компании, это изменение будет применяться к новым клиентам Cloudflare, к новым сайтам, создаваемым существующими клиентами, а также ко всем пользователям бесплатного тарифа.
Этот шаг может повлиять на то, как поставщики моделей ИИ получают доступ к веб-контенту для обучения и для функционирования своих сервисов на основе агентов.
Cloudflare отмечает, что большинство владельцев сайтов хотят, чтобы их контент был доступен через поисковые системы, а также через сервисы ИИ, но в то же время они нуждаются в защите от бесплатного распространения своей интеллектуальной собственности.
Cloudflare конкретно указывает на «самую крупную поисковую систему в мире» (явно имея в виду Google), у которой есть доступ примерно к «в два раза большему объёму информации», чем у других компаний ИИ, поскольку этот гигант поиска затрудняет для клиентов сохранение видимости без одновременного использования их контента в целях развития технологий ИИ.
Ранее Google оспаривала такое обобщение, отмечая, что предлагает бот под названием Google Extended, позволяющий владельцам сайтов отказаться от использования их контента для обучения и создания продуктов ИИ, таких как Gemini Apps и Vertex API. Использование этого инструмента не влияет на то, будет ли сайт включён в поисковые результаты Google. Однако основной бот Googlebot продолжает сканировать контент для поиска, включая функции ИИ, такие как AI Overviews и AI Mode.
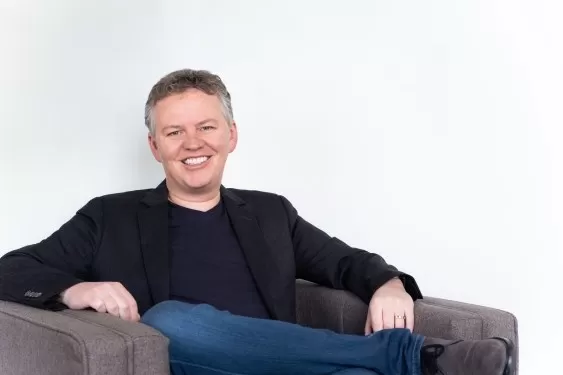
«Теперь, когда большая часть трафика в Интернете приходится на нечеловеческие источники, мы должны действовать ещё активнее и быстрее, чтобы сформировать устойчивую экосистему», — заявил в своём объявлении сооснователь и генеральный директор Cloudflare Мэтью Принс, отсылая к недавнему этапу, когда боты впервые превзошли по численности человеческий трафик в сети — сдвиг, который ранее ожидался только в следующем году.
«Новые инструменты и партнёрства Cloudflare обеспечивают владельцам сайтов большую видимость и коммерческие возможности, а также приносят пользу компаниям ИИ, у которых боты имеют чёткую и прозрачную цель. Мы надеемся, что предложенные стандартные изменения побудят краулеры смешанного назначения разделять функции поиска, работы агентов и обучения», — сказал Принс.
Хотя Cloudflare предлагает ряд продуктов, помогающих пользователям создавать собственные системы ИИ, компания также выпустила набор инструментов, позволяющих издателям больше контролировать свой контент в эпоху ИИ. В последние годы Cloudflare создала инструменты для борьбы с ботами ИИ, включая рынок, где сайты могут взимать плату с ботов за скрапинг контента — сервис под названием Pay Per Crawl.
По словам компании, этот инструмент теперь развивается в модель «Pay Per Use», которая позволит издателям взимать плату с компаний ИИ тогда, когда их контент создаёт ценность, а не только при его получении.
Это изменение также может помочь сэкономить у издателей пропускную способность и вычислительные ресурсы для поставщиков моделей ИИ, поскольку данные Cloudflare показывают, что более 50% трафика от краулеров ИИ тратится на повторное получение неизменных страниц.
Для реализации этого Cloudflare в первую очередь сотрудничает с двумя партнёрами — Ceramic.ai и You.com. Когда издатель соглашается участвовать, он получает оплату, если его контент появляется в результатах поиска ИИ от Ceramic или когда You.com запрашивает его премиум-контент.
По словам Cloudflare, другие компании ИИ могут адаптировать эту модель под свою работу.
Связанная статья
 Google запускает функцию обнаружения поддельных звонков для защиты от мошенничества с использованием ИИ-дипфейков, имитирующих личность
Во вторник компания Google объявила о запуске в Android функции обнаружения поддельных звонков, призванной защитить пользователей от мошенничества с использованием технологии «дипфейк» на базе искусст
Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи
На конференции IO 2026 компания Google представила «умные» очки с аудиофункциями, повторив стратегию Meta
Google стратегически возвращается на рынок умных очков.Во вторник на конференции Google I/O технологический гигант объявил о сотрудничестве с Warby Parker и Gentle Monster с целью запуска новой линейк
Рекомендации по связанным специальным темам
Дизайн и искусство
 Инструменты искусственного интеллекта для создания визуальных стилей, предназначенные для создания характеристик персонажей, мудбордов и презентаций
2026: лучшие современные инструменты на базе ИИ для создания визуальных стилей персонажей, мудбордов и презентаций — уже доступны на XIX.AI! В этом тщательно подобранном списке самых высокооцененных инструментов представлены мощные решения, способные кардинально изменить ваш подход к работе и прошедшие строгие тесты в реальных условиях. Здесь вы найдёте сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы повысить творческий потенциал и оптимизировать рабочий процесс. Ознакомьтесь с ним прямо сейчас, чтобы найти идеальный инструмент для повышения продуктивности!
 11 инструментов
 xix.ai
SEO
Лучшие инструменты для анализа результатов поиска с помощью ИИ при разработке поисковой стратегии
XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai
Анализ данных
Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

 Комментарии (0)
Cloudflare установила новый срок для индустрии ИИ, требуя отделить веб-краулеры, используемые традиционными поисковыми системами, такими как Google Search, от тех, что предназначены для агентов ИИ и процесса обучения. Как сообщила компания в среду, начиная с 15 сентября 2026 года стандартные настройки Cloudflare будут блокировать краулеры смешанного назначения на всех страницах, отображающих рекламу.
Это означает, что краулеры, объединяющие функции поиска, работы агентов и обучения, по умолчанию не смогут получать доступ к таким сайтам, если только владельцы сайтов не скорректируют настройки вручную. По словам компании, это изменение будет применяться к новым клиентам Cloudflare, к новым сайтам, создаваемым существующими клиентами, а также ко всем пользователям бесплатного тарифа.
Этот шаг может повлиять на то, как поставщики моделей ИИ получают доступ к веб-контенту для обучения и для функционирования своих сервисов на основе агентов.
Cloudflare отмечает, что большинство владельцев сайтов хотят, чтобы их контент был доступен через поисковые системы, а также через сервисы ИИ, но в то же время они нуждаются в защите от бесплатного распространения своей интеллектуальной собственности.
Cloudflare конкретно указывает на «самую крупную поисковую систему в мире» (явно имея в виду Google), у которой есть доступ примерно к «в два раза большему объёму информации», чем у других компаний ИИ, поскольку этот гигант поиска затрудняет для клиентов сохранение видимости без одновременного использования их контента в целях развития технологий ИИ.
Ранее Google оспаривала такое обобщение, отмечая, что предлагает бот под названием Google Extended, позволяющий владельцам сайтов отказаться от использования их контента для обучения и создания продуктов ИИ, таких как Gemini Apps и Vertex API. Использование этого инструмента не влияет на то, будет ли сайт включён в поисковые результаты Google. Однако основной бот Googlebot продолжает сканировать контент для поиска, включая функции ИИ, такие как AI Overviews и AI Mode.
«Теперь, когда большая часть трафика в Интернете приходится на нечеловеческие источники, мы должны действовать ещё активнее и быстрее, чтобы сформировать устойчивую экосистему», — заявил в своём объявлении сооснователь и генеральный директор Cloudflare Мэтью Принс, отсылая к недавнему этапу, когда боты впервые превзошли по численности человеческий трафик в сети — сдвиг, который ранее ожидался только в следующем году.
«Новые инструменты и партнёрства Cloudflare обеспечивают владельцам сайтов большую видимость и коммерческие возможности, а также приносят пользу компаниям ИИ, у которых боты имеют чёткую и прозрачную цель. Мы надеемся, что предложенные стандартные изменения побудят краулеры смешанного назначения разделять функции поиска, работы агентов и обучения», — сказал Принс.
Хотя Cloudflare предлагает ряд продуктов, помогающих пользователям создавать собственные системы ИИ, компания также выпустила набор инструментов, позволяющих издателям больше контролировать свой контент в эпоху ИИ. В последние годы Cloudflare создала инструменты для борьбы с ботами ИИ, включая рынок, где сайты могут взимать плату с ботов за скрапинг контента — сервис под названием Pay Per Crawl.
По словам компании, этот инструмент теперь развивается в модель «Pay Per Use», которая позволит издателям взимать плату с компаний ИИ тогда, когда их контент создаёт ценность, а не только при его получении.
Это изменение также может помочь сэкономить у издателей пропускную способность и вычислительные ресурсы для поставщиков моделей ИИ, поскольку данные Cloudflare показывают, что более 50% трафика от краулеров ИИ тратится на повторное получение неизменных страниц.
Для реализации этого Cloudflare в первую очередь сотрудничает с двумя партнёрами — Ceramic.ai и You.com. Когда издатель соглашается участвовать, он получает оплату, если его контент появляется в результатах поиска ИИ от Ceramic или когда You.com запрашивает его премиум-контент.
По словам Cloudflare, другие компании ИИ могут адаптировать эту модель под свою работу.








 Google запускает функцию обнаружения поддельных звонков для защиты от мошенничества с использованием ИИ-дипфейков, имитирующих личность
Во вторник компания Google объявила о запуске в Android функции обнаружения поддельных звонков, призванной защитить пользователей от мошенничества с использованием технологии «дипфейк» на базе искусст
 Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи
 На конференции IO 2026 компания Google представила «умные» очки с аудиофункциями, повторив стратегию Meta
Google стратегически возвращается на рынок умных очков.Во вторник на конференции Google I/O технологический гигант объявил о сотрудничестве с Warby Parker и Gentle Monster с целью запуска новой линейк

2026: лучшие современные инструменты на базе ИИ для создания визуальных стилей персонажей, мудбордов и презентаций — уже доступны на XIX.AI! В этом тщательно подобранном списке самых высокооцененных инструментов представлены мощные решения, способные кардинально изменить ваш подход к работе и прошедшие строгие тесты в реальных условиях. Здесь вы найдёте сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы повысить творческий потенциал и оптимизировать рабочий процесс. Ознакомьтесь с ним прямо сейчас, чтобы найти идеальный инструмент для повышения продуктивности!
11 инструментов
xix.ai

XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai












