


 Дом
Исследование показало, что производительность кода ИИ в реальных условиях завышена
Исследование института METR показывает, что широко используемый тестовый набор SWE-bench Verified, предназначенный для оценки возможностей ИИ в области программирования, может значительно завышать показатели эффективности ИИ-агентов в реальных условиях разработки программного обеспечения. Исследование выявило, что примерно половина решений в виде кода, сгенерированных ИИ и отмеченных тестовым набором как «пройденные», скорее всего, была бы отклонена реальными разработчиками проекта в ходе рецензирования кода, что свидетельствует о существенном разрыве между результатами автоматизированной оценки и реальным качеством кода.
SWE-bench Verified долгое время считался ключевым стандартом для оценки программной инженерии с помощью ИИ, позволяющим проверить, могут ли модели решать реальные задачи программирования в проектах с открытым исходным кодом, и удостовериться, что изменения в коде проходят набор автоматических тестов проекта. Несколько компаний, занимающихся ИИ, включая Anthropic и OpenAI, часто ссылаются на результаты этого теста, чтобы продемонстрировать прогресс моделей.
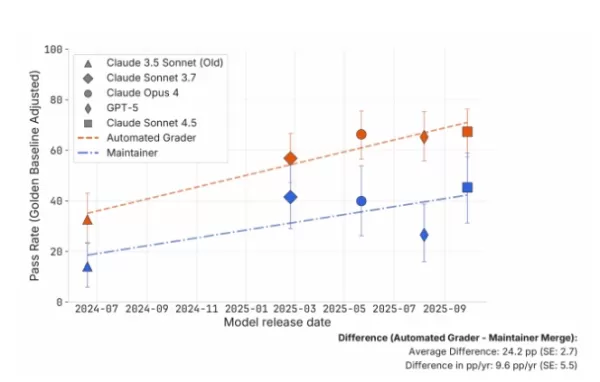
В рамках данного исследования команда METR привлекла четырех опытных разработчиков, поддерживающих проекты с открытым исходным кодом scikit-learn, Sphinx и pytest, для ручной проверки 296 фрагментов кода, сгенерированного ИИ. Эти образцы кода были созданы пятью различными моделями: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet и GPT-5. Результаты показали, что фактический показатель принятия со стороны разработчиков был в среднем примерно на 24 процентных пункта ниже, чем автоматические оценки SWE-bench — это статистически значимая разница.
Исследование также показало, что отклонение кода, сгенерированного ИИ, было вызвано не столько стилистическими проблемами, сколько более существенными техническими недостатками. Разработчики разделили проблемы на три основных типа: качество кода, не соответствующее спецификациям проекта; нарушение существующей структуры кода; и фундаментальные функциональные ошибки. Значительная часть случаев касалась функциональных ошибок, когда, несмотря на прохождение автоматических тестов, код не решал намеченную задачу правильно.
Что касается сравнения моделей, исследование показало, что переход с Claude 3.5 Sonnet на Claude 3.7 Sonnet значительно улучшил показатель прохождения тестов, но количество функциональных ошибок, отмеченных разработчиками, также увеличилось. Переход с Claude 3.7 Sonnet на Claude 4 Opus привел к увеличению количества проблем с качеством кода, в то время как Claude 4.5 Sonnet продемонстрировал улучшение качества кода. Напротив, GPT-5 в целом показал заметно худшие результаты, чем серия моделей Anthropic, в ходе этой ручной оценки.
Исследовательская группа также провела оценочный анализ «времени выполнения задачи»: согласно результатам автоматической оценки SWE-bench, для выполнения задач с успешностью 50% Claude 4.5 Sonnet потребовалось бы примерно 50 минут человеческого труда. Однако, исходя из оценок разработчиков, расчетное время сокращается до всего лишь 8 минут, что позволяет предположить, что тест может переоценивать возможности системы в семь раз.
Тем не менее, исследователи также подчеркнули, что данное исследование не подразумевает фундаментального ограничения возможностей программных агентов ИИ. С помощью усовершенствованных стратегий подсказок, большего количества обратной связи от человека или нескольких циклов итераций разрыв между автоматической оценкой и ручной проверкой можно сократить. Кроме того, экспериментальная постановка отличается от реальных процессов разработки — например, у агентов ИИ была только одна попытка подачи, тогда как разработчики-люди обычно могут итеративно модифицировать код на основе обратной связи.
В целом, исследование приходит к выводу, что опора исключительно на результаты тестов при оценке практической полезности программных агентов ИИ может привести к систематическому смещению. По мере быстрого развития моделей кодирования на базе ИИ разработка систем оценки, которые лучше отражают реальные среды разработки, стала важным направлением исследований в области программной инженерии ИИ.
Связанная статья
 Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в
Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
 9 инструментов
 xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai
Образование и обучение
Платформы для создания викторин с ИИ для учителей, репетиторов и программ обучения в группах
2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai
код
Инструменты на базе ИИ для проверки пулл-реквестов в командах GitHub, занимающихся рефакторингом, устранением ошибок и устранением уязвимостей
2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

 Комментарии (2)
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
Исследование института METR показывает, что широко используемый тестовый набор SWE-bench Verified, предназначенный для оценки возможностей ИИ в области программирования, может значительно завышать показатели эффективности ИИ-агентов в реальных условиях разработки программного обеспечения. Исследование выявило, что примерно половина решений в виде кода, сгенерированных ИИ и отмеченных тестовым набором как «пройденные», скорее всего, была бы отклонена реальными разработчиками проекта в ходе рецензирования кода, что свидетельствует о существенном разрыве между результатами автоматизированной оценки и реальным качеством кода.
SWE-bench Verified долгое время считался ключевым стандартом для оценки программной инженерии с помощью ИИ, позволяющим проверить, могут ли модели решать реальные задачи программирования в проектах с открытым исходным кодом, и удостовериться, что изменения в коде проходят набор автоматических тестов проекта. Несколько компаний, занимающихся ИИ, включая Anthropic и OpenAI, часто ссылаются на результаты этого теста, чтобы продемонстрировать прогресс моделей.
В рамках данного исследования команда METR привлекла четырех опытных разработчиков, поддерживающих проекты с открытым исходным кодом scikit-learn, Sphinx и pytest, для ручной проверки 296 фрагментов кода, сгенерированного ИИ. Эти образцы кода были созданы пятью различными моделями: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet и GPT-5. Результаты показали, что фактический показатель принятия со стороны разработчиков был в среднем примерно на 24 процентных пункта ниже, чем автоматические оценки SWE-bench — это статистически значимая разница.
Исследование также показало, что отклонение кода, сгенерированного ИИ, было вызвано не столько стилистическими проблемами, сколько более существенными техническими недостатками. Разработчики разделили проблемы на три основных типа: качество кода, не соответствующее спецификациям проекта; нарушение существующей структуры кода; и фундаментальные функциональные ошибки. Значительная часть случаев касалась функциональных ошибок, когда, несмотря на прохождение автоматических тестов, код не решал намеченную задачу правильно.
Что касается сравнения моделей, исследование показало, что переход с Claude 3.5 Sonnet на Claude 3.7 Sonnet значительно улучшил показатель прохождения тестов, но количество функциональных ошибок, отмеченных разработчиками, также увеличилось. Переход с Claude 3.7 Sonnet на Claude 4 Opus привел к увеличению количества проблем с качеством кода, в то время как Claude 4.5 Sonnet продемонстрировал улучшение качества кода. Напротив, GPT-5 в целом показал заметно худшие результаты, чем серия моделей Anthropic, в ходе этой ручной оценки.
Исследовательская группа также провела оценочный анализ «времени выполнения задачи»: согласно результатам автоматической оценки SWE-bench, для выполнения задач с успешностью 50% Claude 4.5 Sonnet потребовалось бы примерно 50 минут человеческого труда. Однако, исходя из оценок разработчиков, расчетное время сокращается до всего лишь 8 минут, что позволяет предположить, что тест может переоценивать возможности системы в семь раз.
Тем не менее, исследователи также подчеркнули, что данное исследование не подразумевает фундаментального ограничения возможностей программных агентов ИИ. С помощью усовершенствованных стратегий подсказок, большего количества обратной связи от человека или нескольких циклов итераций разрыв между автоматической оценкой и ручной проверкой можно сократить. Кроме того, экспериментальная постановка отличается от реальных процессов разработки — например, у агентов ИИ была только одна попытка подачи, тогда как разработчики-люди обычно могут итеративно модифицировать код на основе обратной связи.
В целом, исследование приходит к выводу, что опора исключительно на результаты тестов при оценке практической полезности программных агентов ИИ может привести к систематическому смещению. По мере быстрого развития моделей кодирования на базе ИИ разработка систем оценки, которые лучше отражают реальные среды разработки, стала важным направлением исследований в области программной инженерии ИИ.








 Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в
 Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
 Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai

2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












