


 家
研究によると、実環境でのテストにおいてAIコードの性能が過大評価されていたことが判明した
METR研究所の研究によると、AIのプログラミング能力を評価するために広く利用されている「SWE-bench Verified」ベンチマークは、実際のソフトウェア開発におけるAIエージェントのパフォーマンスを大幅に過大評価している可能性があることが示唆されています。この研究では、同ベンチマークで「合格」と判定されたAI生成コードのソリューションの約半数が、実際のプロジェクトのメンテナーによるコードレビューでは却下される可能性が高いことが判明し、自動評価結果と実際のコード品質との間に大きな隔たりがあることが浮き彫りになりました。
SWE-bench Verifiedは、AI支援型ソフトウェアエンジニアリングを評価するための主要な基準として長年位置づけられてきた。このベンチマークは、モデルがオープンソースプロジェクトにおける実際のプログラミング課題を解決できるかどうかをテストし、コードの変更がプロジェクトの自動テストスイートを通過するかどうかを検証するものである。AnthropicやOpenAIを含む複数のAI企業は、モデルの進歩を示すために、このベンチマークの結果を頻繁に引用している。
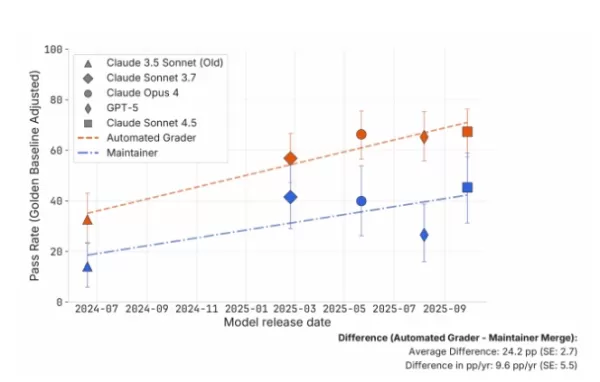
本研究において、METRチームは、オープンソースプロジェクトであるscikit-learn、Sphinx、pytestのメンテナンスを担当する4名の経験豊富な開発者に協力を依頼し、AIが生成した296件のコードを手動でレビューしてもらった。これらのコードサンプルは、Claude 3.5 Sonnet、Claude 3.7 Sonnet、Claude 4 Opus、Claude 4.5 Sonnet、GPT-5の5つの異なるモデルによって生成されたものである。 その結果、メンテナーによる実際の採用率は、SWE-benchによる自動評価スコアよりも平均で約24パーセントポイント低く、これは統計的に有意な差であることが明らかになった。
また、この研究では、却下されたAIコードの主な原因はスタイル上の問題ではなく、より根本的な技術的欠陥にあることも判明しました。メンテナーは問題を主に3つのタイプに分類しました。プロジェクトの仕様を満たしていないコード品質、既存のコード構造の破壊、そして根本的な機能エラーです。ケースの相当な割合は機能エラーに関連しており、自動テストには合格したものの、コードが意図された問題を正しく解決できていないというものでした。
モデル比較に関しては、Claude 3.5 SonnetからClaude 3.7 Sonnetへのアップグレードによりベンチマークの合格率が大幅に改善された一方で、メンテナーによって指摘された機能エラーの数も増加したことが判明した。 Claude 3.7 SonnetからClaude 4 Opusへの移行では、コード品質の問題がより多く見られるようになった一方、Claude 4.5 Sonnetではコード品質の改善が確認された。対照的に、GPT-5はこの手動評価において、Anthropicのモデルシリーズ全体と比較して著しく劣る結果となった。
研究チームは「タスク完了時間」の推定分析も実施した。SWE-benchの自動評価結果によると、Claude 4.5 Sonnetが50%の成功率でタスクを完了するには、人間が約50分の労力を要するとされる。しかし、メンテナーによる評価スコアに基づくと、推定時間はわずか約8分まで短縮され、このベンチマークが能力を最大7倍も過大評価している可能性が示唆された。
ただし、研究者らは、本研究がAIプログラミングエージェントの能力に根本的な限界があることを示唆するものではないとも強調している。プロンプト戦略の改善、より多くの人的フィードバック、あるいは複数の反復サイクルにより、自動評価と手動レビューの間のギャップは縮小し得る。さらに、実験設定は実際の開発プロセスとは異なる。例えば、AIエージェントには提出の機会が1回しかなかったのに対し、人間の開発者は通常、フィードバックに基づいてコードを反復的に修正することができる。
要約すると、本研究は、AIプログラミングエージェントの実用的な有用性を評価する際にベンチマークスコアのみに依存することは、体系的なバイアスを生じさせる可能性があると結論付けている。AIコーディングモデルが急速に進化する中、現実の開発環境をよりよく反映した評価システムを開発することは、AIソフトウェア工学における重要な研究方向となっている。
関連記事
 Linux財団を支援する6つのテックジャイアント、AI脆弱性のノイズに対処するために1,250万ドルを拠出
AI自動化ツールによって生成される低品質なセキュリティレポートの洪水に対処するため、Anthropic、Amazon(AWS)、GitHub、Google、Microsoft、OpenAIの6大テック企業が、Linux Foundationのイニシアチブに対して総額1250万ドルの資金を提供しました。この投資は、オープンソースソフトウェア(FOSS)のメンテナーが手動でのスクリーニングという負担から解放され、本格的なセキュリティ脅威に集中できることを目的としています。AI技術が脆弱性発見のハー
アルトマン証言の中で、マスクはOpenAIを子供たちに譲ることを検討した
今朝、OpenAIのCEOサム・アルトマン氏は、同社の企業構造に異議を唱える元共同創設者エロン・マスク氏の訴訟に対応するため証言台に立った。「営利子会社を設立してAI搭載製品を市場に出すことで、他の創設者たちが『慈善団体を盗んだ』」というマスク氏の主張について問われると、アルトマン氏は明らかなためらいを示して応答した。「その枠組みを処理するのは難しい」と、アルトマン氏は一時の間を置いて語った。「私たちは世界最大の慈善団体の一つを設立した。財団は素晴らしい活動を行っており、今後もさらに多くのこ
サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
関連特集おすすめ
仕事
 中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
 9 ツール
 xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai
コード
リファクタリング、バグ、セキュリティ上の脆弱性を扱うGitHubチーム向けのAIプルリクエストレビューツール
2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai
テキスト読み上げ
自然なナレーションを実現する、おすすめのAIテキスト読み上げツール
2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

 コメント (2)
0/500
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
METR研究所の研究によると、AIのプログラミング能力を評価するために広く利用されている「SWE-bench Verified」ベンチマークは、実際のソフトウェア開発におけるAIエージェントのパフォーマンスを大幅に過大評価している可能性があることが示唆されています。この研究では、同ベンチマークで「合格」と判定されたAI生成コードのソリューションの約半数が、実際のプロジェクトのメンテナーによるコードレビューでは却下される可能性が高いことが判明し、自動評価結果と実際のコード品質との間に大きな隔たりがあることが浮き彫りになりました。
SWE-bench Verifiedは、AI支援型ソフトウェアエンジニアリングを評価するための主要な基準として長年位置づけられてきた。このベンチマークは、モデルがオープンソースプロジェクトにおける実際のプログラミング課題を解決できるかどうかをテストし、コードの変更がプロジェクトの自動テストスイートを通過するかどうかを検証するものである。AnthropicやOpenAIを含む複数のAI企業は、モデルの進歩を示すために、このベンチマークの結果を頻繁に引用している。
本研究において、METRチームは、オープンソースプロジェクトであるscikit-learn、Sphinx、pytestのメンテナンスを担当する4名の経験豊富な開発者に協力を依頼し、AIが生成した296件のコードを手動でレビューしてもらった。これらのコードサンプルは、Claude 3.5 Sonnet、Claude 3.7 Sonnet、Claude 4 Opus、Claude 4.5 Sonnet、GPT-5の5つの異なるモデルによって生成されたものである。 その結果、メンテナーによる実際の採用率は、SWE-benchによる自動評価スコアよりも平均で約24パーセントポイント低く、これは統計的に有意な差であることが明らかになった。
また、この研究では、却下されたAIコードの主な原因はスタイル上の問題ではなく、より根本的な技術的欠陥にあることも判明しました。メンテナーは問題を主に3つのタイプに分類しました。プロジェクトの仕様を満たしていないコード品質、既存のコード構造の破壊、そして根本的な機能エラーです。ケースの相当な割合は機能エラーに関連しており、自動テストには合格したものの、コードが意図された問題を正しく解決できていないというものでした。
モデル比較に関しては、Claude 3.5 SonnetからClaude 3.7 Sonnetへのアップグレードによりベンチマークの合格率が大幅に改善された一方で、メンテナーによって指摘された機能エラーの数も増加したことが判明した。 Claude 3.7 SonnetからClaude 4 Opusへの移行では、コード品質の問題がより多く見られるようになった一方、Claude 4.5 Sonnetではコード品質の改善が確認された。対照的に、GPT-5はこの手動評価において、Anthropicのモデルシリーズ全体と比較して著しく劣る結果となった。
研究チームは「タスク完了時間」の推定分析も実施した。SWE-benchの自動評価結果によると、Claude 4.5 Sonnetが50%の成功率でタスクを完了するには、人間が約50分の労力を要するとされる。しかし、メンテナーによる評価スコアに基づくと、推定時間はわずか約8分まで短縮され、このベンチマークが能力を最大7倍も過大評価している可能性が示唆された。
ただし、研究者らは、本研究がAIプログラミングエージェントの能力に根本的な限界があることを示唆するものではないとも強調している。プロンプト戦略の改善、より多くの人的フィードバック、あるいは複数の反復サイクルにより、自動評価と手動レビューの間のギャップは縮小し得る。さらに、実験設定は実際の開発プロセスとは異なる。例えば、AIエージェントには提出の機会が1回しかなかったのに対し、人間の開発者は通常、フィードバックに基づいてコードを反復的に修正することができる。
要約すると、本研究は、AIプログラミングエージェントの実用的な有用性を評価する際にベンチマークスコアのみに依存することは、体系的なバイアスを生じさせる可能性があると結論付けている。AIコーディングモデルが急速に進化する中、現実の開発環境をよりよく反映した評価システムを開発することは、AIソフトウェア工学における重要な研究方向となっている。








 Linux財団を支援する6つのテックジャイアント、AI脆弱性のノイズに対処するために1,250万ドルを拠出
AI自動化ツールによって生成される低品質なセキュリティレポートの洪水に対処するため、Anthropic、Amazon(AWS)、GitHub、Google、Microsoft、OpenAIの6大テック企業が、Linux Foundationのイニシアチブに対して総額1250万ドルの資金を提供しました。この投資は、オープンソースソフトウェア(FOSS)のメンテナーが手動でのスクリーニングという負担から解放され、本格的なセキュリティ脅威に集中できることを目的としています。AI技術が脆弱性発見のハー
 アルトマン証言の中で、マスクはOpenAIを子供たちに譲ることを検討した
今朝、OpenAIのCEOサム・アルトマン氏は、同社の企業構造に異議を唱える元共同創設者エロン・マスク氏の訴訟に対応するため証言台に立った。「営利子会社を設立してAI搭載製品を市場に出すことで、他の創設者たちが『慈善団体を盗んだ』」というマスク氏の主張について問われると、アルトマン氏は明らかなためらいを示して応答した。「その枠組みを処理するのは難しい」と、アルトマン氏は一時の間を置いて語った。「私たちは世界最大の慈善団体の一つを設立した。財団は素晴らしい活動を行っており、今後もさらに多くのこ
 サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai

2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












