


 Lar
ByteDance Revela o Modelo de IA Seed-Thinking-v1.5 para Impulsionar Capacidades de Raciocínio
A corrida por IA com raciocínio avançado começou com o modelo o1 da OpenAI em setembro de 2024, ganhando impulso com o lançamento do R1 da DeepSeek em janeiro de 2025.
Os principais desenvolvedores de IA estão agora competindo para criar modelos de IA de raciocínio mais rápidos e econômicos que ofereçam respostas precisas e bem pensadas por meio de processos de cadeia de pensamento, garantindo precisão antes de responder.
ByteDance, a empresa-mãe do TikTok, entrou na disputa com o Seed-Thinking-v1.5, um novo modelo de linguagem de grande escala (LLM) descrito em um artigo técnico, voltado para aprimorar o raciocínio em STEM e domínios gerais.
O modelo ainda não está disponível, e sua licença — se proprietária, de código aberto ou híbrida — permanece não divulgada. O artigo, no entanto, oferece insights importantes que valem a pena explorar antes de seu lançamento.
Aproveitando a Arquitetura Mixture-of-Experts (MoE)
Seguindo o Llama 4 da Meta e o Mixtral da Mistral, o Seed-Thinking-v1.5 adota a arquitetura Mixture-of-Experts (MoE).
Essa abordagem aumenta a eficiência ao integrar múltiplos modelos especializados em um único, cada um focado em domínios distintos.
O Seed-Thinking-v1.5 utiliza apenas 20 bilhões de seus 200 bilhões de parâmetros por vez, otimizando o desempenho.
O artigo publicado no GitHub pela ByteDance destaca o foco do modelo em raciocínio estruturado e geração de respostas deliberadas.
Ele supera o DeepSeek R1 e rivaliza com o Gemini 2.5 Pro do Google e o o3-mini-high da OpenAI em benchmarks de terceiros, até mesmo superando-os no benchmark ARC-AGI, uma medida importante de progresso rumo à inteligência geral artificial, superando o desempenho humano em tarefas economicamente valiosas, conforme os padrões da OpenAI.
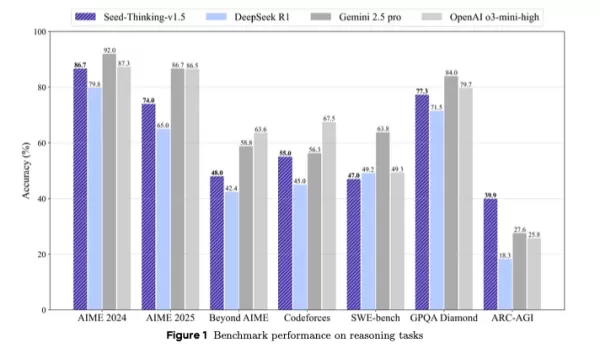
Posicionado como uma alternativa compacta, porém poderosa, a modelos maiores, o Seed-Thinking-v1.5 entrega resultados de benchmark sólidos por meio de aprendizado por reforço inovador, dados de treinamento curados e infraestrutura avançada de IA.
Desempenho em Benchmarks e Pontos Fortes Principais
O Seed-Thinking-v1.5 se destaca em tarefas difíceis, alcançando 86,7% no AIME 2024, 55,0% de pass@8 no Codeforces e 77,3% no benchmark científico GPQA, correspondendo ou superando modelos como o o3-mini-high da OpenAI e o Gemini 2.5 Pro do Google em métricas de raciocínio.
Em tarefas não relacionadas ao raciocínio, ele obteve uma taxa de preferência humana 8,0% maior que o DeepSeek R1, mostrando versatilidade além de lógica e matemática.
Para combater a saturação de benchmarks, a ByteDance criou o BeyondAIME, um benchmark matemático mais difícil para resistir à memorização e avaliar melhor o desempenho do modelo. Esse, junto com o conjunto Codeforces, será lançado publicamente para auxiliar pesquisas futuras.
Abordagem de Dados de Treinamento
A qualidade dos dados foi crucial no desenvolvimento do Seed-Thinking-v1.5. Para o ajuste fino supervisionado, 400.000 amostras foram curadas: 300.000 tarefas verificáveis de STEM, lógica e codificação, e 100.000 tarefas não verificáveis, como escrita criativa.
Para o aprendizado por reforço, os dados foram divididos em:
- Problemas verificáveis: 100.000 questões de STEM e quebra-cabeças lógicos cuidadosamente selecionados de competições de elite, validados por especialistas.
- Tarefas não verificáveis: Conjuntos de dados de preferência humana para prompts abertos, avaliados por modelos de recompensa pareada.
Mais de 80% dos dados de STEM focaram em matemática avançada, com tarefas lógicas como Sudoku e quebra-cabeças de 24 pontos escalados para acompanhar o progresso do modelo.
Inovações em Aprendizado por Reforço
O Seed-Thinking-v1.5 utiliza frameworks personalizados de ator-crítico (VAPO) e gradiente de política (DAPO) para estabilizar o aprendizado por reforço, abordando problemas em cenários de cadeia de pensamento longa.
Dois modelos de recompensa aprimoram a supervisão do RL:
- Seed-Verifier: Um LLM baseado em regras que garante equivalência matemática entre respostas geradas e de referência.
- Seed-Thinking-Verifier: Um juiz baseado em raciocínio para avaliação consistente, resistente à manipulação de recompensas.
Esse sistema duplo suporta avaliação precisa em tarefas simples e complexas.
Design de Infraestrutura Escalável
O framework HybridFlow da ByteDance, alimentado por clusters Ray, suporta treinamento em grande escala eficiente com treinamento e inferência co-localizados para minimizar o tempo ocioso da GPU.
O Sistema de Lançamento de Streaming (SRS) separa a evolução do modelo do tempo de execução, acelerando iterações em até três vezes por meio do gerenciamento assíncrono de gerações parciais.
Técnicas adicionais incluem:
- Precisão mista (FP8) para eficiência de memória
- Paralelismo de especialistas e autoajuste de kernel para otimização de MoE
- ByteCheckpoint para checkpointing robusto
- AutoTuner para configurações otimizadas de paralelismo e memória
Avaliação Centrada em Humanos e Aplicações
Testes humanos em escrita criativa, humanidades e conversação geral mostraram que o Seed-Thinking-v1.5 supera o DeepSeek R1, provando sua relevância no mundo real.
A equipe observa que o treinamento em tarefas verificáveis melhorou a generalização para domínios criativos, impulsionado por fluxos de trabalho matemáticos rigorosos.
Implicações para Equipes Técnicas e Empresas
Para líderes técnicos que supervisionam ciclos de vida de LLM, o Seed-Thinking-v1.5 oferece um modelo para integrar raciocínio avançado em sistemas de IA empresariais.
Seu treinamento modular, com conjuntos de dados verificáveis e aprendizado por reforço multifásico, é adequado para equipes que escalam o desenvolvimento de LLM com controle preciso.
O Seed-Verifier e o Seed-Thinking-Verifier aprimoram a modelagem de recompensas confiáveis, vital para configurações voltadas para clientes ou reguladas.
Para equipes com cronogramas apertados, o VAPO e a amostragem dinâmica reduzem os ciclos de iteração, simplificando o ajuste fino específico para tarefas.
A infraestrutura híbrida, incluindo SRS e otimização FP8, aumenta a taxa de transferência de treinamento e a eficiência de hardware, ideal para sistemas em nuvem e locais.
O feedback adaptativo de recompensas do modelo aborda desafios no gerenciamento de pipelines de dados diversos, garantindo consistência entre domínios.
Para engenheiros de dados, o foco em filtragem rigorosa de dados e verificação por especialistas destaca o valor de conjuntos de dados de alta qualidade para melhorar o desempenho do modelo.
Perspectivas Futuras
Desenvolvido pela equipe de Sistemas LLM Seed da ByteDance, liderada por Yonghui Wu e representada publicamente por Haibin Lin, o Seed-Thinking-v1.5 se baseia em esforços como o Doubao 1.5 Pro, usando técnicas compartilhadas de RLHF e curadoria de dados.
A equipe pretende refinar o aprendizado por reforço, focando na eficiência de treinamento e modelagem de recompensas para tarefas não verificáveis. A liberação de benchmarks como o BeyondAIME impulsionará ainda mais o progresso na pesquisa de IA focada em raciocínio.
Artigo relacionado
 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
Ex-executivos do TikTok lançam aplicativo baseado em IA para aperfeiçoar poses fotográficas
As empresas estão cada vez mais utilizando a geração de imagens por IA para ensinar técnicas fotográficas aos usuários. No ano passado, o Google lançou o Camera Coach nos dispositivos Pixel para auxil
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (1)
![ChristopherDavis]()
Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.
A corrida por IA com raciocínio avançado começou com o modelo o1 da OpenAI em setembro de 2024, ganhando impulso com o lançamento do R1 da DeepSeek em janeiro de 2025.
Os principais desenvolvedores de IA estão agora competindo para criar modelos de IA de raciocínio mais rápidos e econômicos que ofereçam respostas precisas e bem pensadas por meio de processos de cadeia de pensamento, garantindo precisão antes de responder.
ByteDance, a empresa-mãe do TikTok, entrou na disputa com o Seed-Thinking-v1.5, um novo modelo de linguagem de grande escala (LLM) descrito em um artigo técnico, voltado para aprimorar o raciocínio em STEM e domínios gerais.
O modelo ainda não está disponível, e sua licença — se proprietária, de código aberto ou híbrida — permanece não divulgada. O artigo, no entanto, oferece insights importantes que valem a pena explorar antes de seu lançamento.
Aproveitando a Arquitetura Mixture-of-Experts (MoE)
Seguindo o Llama 4 da Meta e o Mixtral da Mistral, o Seed-Thinking-v1.5 adota a arquitetura Mixture-of-Experts (MoE).
Essa abordagem aumenta a eficiência ao integrar múltiplos modelos especializados em um único, cada um focado em domínios distintos.
O Seed-Thinking-v1.5 utiliza apenas 20 bilhões de seus 200 bilhões de parâmetros por vez, otimizando o desempenho.
O artigo publicado no GitHub pela ByteDance destaca o foco do modelo em raciocínio estruturado e geração de respostas deliberadas.
Ele supera o DeepSeek R1 e rivaliza com o Gemini 2.5 Pro do Google e o o3-mini-high da OpenAI em benchmarks de terceiros, até mesmo superando-os no benchmark ARC-AGI, uma medida importante de progresso rumo à inteligência geral artificial, superando o desempenho humano em tarefas economicamente valiosas, conforme os padrões da OpenAI.
Posicionado como uma alternativa compacta, porém poderosa, a modelos maiores, o Seed-Thinking-v1.5 entrega resultados de benchmark sólidos por meio de aprendizado por reforço inovador, dados de treinamento curados e infraestrutura avançada de IA.
Desempenho em Benchmarks e Pontos Fortes Principais
O Seed-Thinking-v1.5 se destaca em tarefas difíceis, alcançando 86,7% no AIME 2024, 55,0% de pass@8 no Codeforces e 77,3% no benchmark científico GPQA, correspondendo ou superando modelos como o o3-mini-high da OpenAI e o Gemini 2.5 Pro do Google em métricas de raciocínio.
Em tarefas não relacionadas ao raciocínio, ele obteve uma taxa de preferência humana 8,0% maior que o DeepSeek R1, mostrando versatilidade além de lógica e matemática.
Para combater a saturação de benchmarks, a ByteDance criou o BeyondAIME, um benchmark matemático mais difícil para resistir à memorização e avaliar melhor o desempenho do modelo. Esse, junto com o conjunto Codeforces, será lançado publicamente para auxiliar pesquisas futuras.
Abordagem de Dados de Treinamento
A qualidade dos dados foi crucial no desenvolvimento do Seed-Thinking-v1.5. Para o ajuste fino supervisionado, 400.000 amostras foram curadas: 300.000 tarefas verificáveis de STEM, lógica e codificação, e 100.000 tarefas não verificáveis, como escrita criativa.
Para o aprendizado por reforço, os dados foram divididos em:
- Problemas verificáveis: 100.000 questões de STEM e quebra-cabeças lógicos cuidadosamente selecionados de competições de elite, validados por especialistas.
- Tarefas não verificáveis: Conjuntos de dados de preferência humana para prompts abertos, avaliados por modelos de recompensa pareada.
Mais de 80% dos dados de STEM focaram em matemática avançada, com tarefas lógicas como Sudoku e quebra-cabeças de 24 pontos escalados para acompanhar o progresso do modelo.
Inovações em Aprendizado por Reforço
O Seed-Thinking-v1.5 utiliza frameworks personalizados de ator-crítico (VAPO) e gradiente de política (DAPO) para estabilizar o aprendizado por reforço, abordando problemas em cenários de cadeia de pensamento longa.
Dois modelos de recompensa aprimoram a supervisão do RL:
- Seed-Verifier: Um LLM baseado em regras que garante equivalência matemática entre respostas geradas e de referência.
- Seed-Thinking-Verifier: Um juiz baseado em raciocínio para avaliação consistente, resistente à manipulação de recompensas.
Esse sistema duplo suporta avaliação precisa em tarefas simples e complexas.
Design de Infraestrutura Escalável
O framework HybridFlow da ByteDance, alimentado por clusters Ray, suporta treinamento em grande escala eficiente com treinamento e inferência co-localizados para minimizar o tempo ocioso da GPU.
O Sistema de Lançamento de Streaming (SRS) separa a evolução do modelo do tempo de execução, acelerando iterações em até três vezes por meio do gerenciamento assíncrono de gerações parciais.
Técnicas adicionais incluem:
- Precisão mista (FP8) para eficiência de memória
- Paralelismo de especialistas e autoajuste de kernel para otimização de MoE
- ByteCheckpoint para checkpointing robusto
- AutoTuner para configurações otimizadas de paralelismo e memória
Avaliação Centrada em Humanos e Aplicações
Testes humanos em escrita criativa, humanidades e conversação geral mostraram que o Seed-Thinking-v1.5 supera o DeepSeek R1, provando sua relevância no mundo real.
A equipe observa que o treinamento em tarefas verificáveis melhorou a generalização para domínios criativos, impulsionado por fluxos de trabalho matemáticos rigorosos.
Implicações para Equipes Técnicas e Empresas
Para líderes técnicos que supervisionam ciclos de vida de LLM, o Seed-Thinking-v1.5 oferece um modelo para integrar raciocínio avançado em sistemas de IA empresariais.
Seu treinamento modular, com conjuntos de dados verificáveis e aprendizado por reforço multifásico, é adequado para equipes que escalam o desenvolvimento de LLM com controle preciso.
O Seed-Verifier e o Seed-Thinking-Verifier aprimoram a modelagem de recompensas confiáveis, vital para configurações voltadas para clientes ou reguladas.
Para equipes com cronogramas apertados, o VAPO e a amostragem dinâmica reduzem os ciclos de iteração, simplificando o ajuste fino específico para tarefas.
A infraestrutura híbrida, incluindo SRS e otimização FP8, aumenta a taxa de transferência de treinamento e a eficiência de hardware, ideal para sistemas em nuvem e locais.
O feedback adaptativo de recompensas do modelo aborda desafios no gerenciamento de pipelines de dados diversos, garantindo consistência entre domínios.
Para engenheiros de dados, o foco em filtragem rigorosa de dados e verificação por especialistas destaca o valor de conjuntos de dados de alta qualidade para melhorar o desempenho do modelo.
Perspectivas Futuras
Desenvolvido pela equipe de Sistemas LLM Seed da ByteDance, liderada por Yonghui Wu e representada publicamente por Haibin Lin, o Seed-Thinking-v1.5 se baseia em esforços como o Doubao 1.5 Pro, usando técnicas compartilhadas de RLHF e curadoria de dados.
A equipe pretende refinar o aprendizado por reforço, focando na eficiência de treinamento e modelagem de recompensas para tarefas não verificáveis. A liberação de benchmarks como o BeyondAIME impulsionará ainda mais o progresso na pesquisa de IA focada em raciocínio.








 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
 A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
 Ex-executivos do TikTok lançam aplicativo baseado em IA para aperfeiçoar poses fotográficas
As empresas estão cada vez mais utilizando a geração de imagens por IA para ensinar técnicas fotográficas aos usuários. No ano passado, o Google lançou o Camera Coach nos dispositivos Pixel para auxil

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.












