


 Lar
A OpenAI lança o benchmark GeneBench-Pro para impulsionar a análise biológica com IA
À medida que a biotecnologia avança rapidamente, a análise eficiente e precisa de dados biológicos complexos tornou-se um grande desafio para os pesquisadores. Para dotar os modelos de IA de habilidades analíticas mais robustas nesse domínio, a OpenAI lançou recentemente um novo benchmark chamado GeneBench-Pro. Esse benchmark foi projetado para avaliar as capacidades práticas de pesquisa da IA em áreas como genômica e proteômica, especialmente sua capacidade de fazer julgamentos e tomar decisões quando confrontada com dados desorganizados e incompletos.
O GeneBench-Pro se diferencia dos benchmarks tradicionais. Enquanto os testes convencionais costumam se concentrar na capacidade de memória de um modelo e na habilidade de seguir sequências fixas de tarefas, o GeneBench-Pro enfatiza a utilidade na pesquisa do mundo real. Suas tarefas são construídas em torno de um ambiente de dados “difuso, incompleto e ruidoso”, permitindo que o modelo explore e analise nessas condições, o que reflete com mais precisão suas habilidades de julgamento.
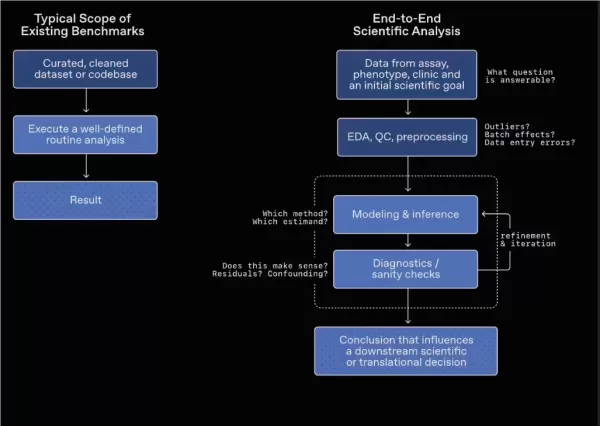
Este benchmark abrange um amplo espectro de campos biológicos, incluindo genômica, biologia quantitativa e medicina translacional, com 129 questões que abrangem subcampos como genética estatística, genética populacional, genômica funcional e proteômica. Cada questão fornece um conjunto de dados próximo a um ambiente real de pesquisa, exigindo que o modelo escolha de forma independente métodos de análise, adapte estratégias com base em breves contextos experimentais e, por fim, chegue a conclusões.
Para evitar vieses de pontuação comuns em testes tradicionais de longo processo, a OpenAI utilizou dados sintéticos ao projetar o GeneBench-Pro. Essa abordagem proporciona à OpenAI um controle mais rigoroso sobre o processo de geração de dados, garantindo que o desempenho do modelo reflita compreensão genuína, em vez de respostas corretas obtidas por meio de suposições ou atalhos.
A OpenAI disponibilizou como código aberto 10 questões representativas do GeneBench-Pro na plataforma Hugging Face, permitindo que pesquisadores externos as explorem por meio de uma interface interativa. No futuro, a OpenAI planeja enviar 50 dessas questões à Artificial Analysis para avaliação independente, verificando o desempenho real de diferentes modelos nesse benchmark.
Artigo relacionado
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n
Recomendações de tópicos especiais relacionados
escrita
 Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
 8 ferramentas
 xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

 Comentários (0)
À medida que a biotecnologia avança rapidamente, a análise eficiente e precisa de dados biológicos complexos tornou-se um grande desafio para os pesquisadores. Para dotar os modelos de IA de habilidades analíticas mais robustas nesse domínio, a OpenAI lançou recentemente um novo benchmark chamado GeneBench-Pro. Esse benchmark foi projetado para avaliar as capacidades práticas de pesquisa da IA em áreas como genômica e proteômica, especialmente sua capacidade de fazer julgamentos e tomar decisões quando confrontada com dados desorganizados e incompletos.
O GeneBench-Pro se diferencia dos benchmarks tradicionais. Enquanto os testes convencionais costumam se concentrar na capacidade de memória de um modelo e na habilidade de seguir sequências fixas de tarefas, o GeneBench-Pro enfatiza a utilidade na pesquisa do mundo real. Suas tarefas são construídas em torno de um ambiente de dados “difuso, incompleto e ruidoso”, permitindo que o modelo explore e analise nessas condições, o que reflete com mais precisão suas habilidades de julgamento.
Este benchmark abrange um amplo espectro de campos biológicos, incluindo genômica, biologia quantitativa e medicina translacional, com 129 questões que abrangem subcampos como genética estatística, genética populacional, genômica funcional e proteômica. Cada questão fornece um conjunto de dados próximo a um ambiente real de pesquisa, exigindo que o modelo escolha de forma independente métodos de análise, adapte estratégias com base em breves contextos experimentais e, por fim, chegue a conclusões.
Para evitar vieses de pontuação comuns em testes tradicionais de longo processo, a OpenAI utilizou dados sintéticos ao projetar o GeneBench-Pro. Essa abordagem proporciona à OpenAI um controle mais rigoroso sobre o processo de geração de dados, garantindo que o desempenho do modelo reflita compreensão genuína, em vez de respostas corretas obtidas por meio de suposições ou atalhos.
A OpenAI disponibilizou como código aberto 10 questões representativas do GeneBench-Pro na plataforma Hugging Face, permitindo que pesquisadores externos as explorem por meio de uma interface interativa. No futuro, a OpenAI planeja enviar 50 dessas questões à Artificial Analysis para avaliação independente, verificando o desempenho real de diferentes modelos nesse benchmark.








 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
 Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai












