

 Lar
A NVIDIA apresenta o modelo de inteligência unificada de áudio Nemotron-Labs-Audex-30B-A3B
As grandes modelos multimodais evoluem rapidamente, as capacidades de processamento de áudio são frequentemente comprometidas — muitos modelos melhoram a compreensão de áudio em detrimento da lógica textual. Para resolver isso, pesquisadores da NVIDIA apresentaram o Nemotron-Labs-Audex-30B-A3B (Audex), um grande modelo de linguagem unificado de áudio-texto projetado para preencher essa lacuna.
O Audex emprega um design simplificado e eficiente, construído sobre uma arquitetura robusta de Mistura de Especialistas (MoE) puramente textual. Ao utilizar um único decodificador Transformer, ele processa tokens de texto e tokens de áudio quantizados simultaneamente. Essa abordagem projeta as entradas de áudio no espaço de incorporação de texto, garantindo integração perfeita com a infraestrutura existente de LLMs para tarefas multimodais e alcançando uma integração profunda verdadeira.
O treinamento envolveu conjuntos de dados extensos compostos por 157,4 bilhões de tokens de áudio e 320,5 bilhões de tokens de texto. Através de treinamento supervisionado em múltiplas etapas, Aprendizado por Reforço em Cascata puramente textual e destilação de conhecimento em política de múltiplos domínios, o Audex alcança desempenho líder na indústria em compreensão de áudio, reconhecimento de fala, tradução e geração. Crucialmente, ele preserva as capacidades principais do LLM original em raciocínio, alinhamento, recuperação de conhecimento e processamento de texto longo com degradação mínima.
Como um modelo de código aberto, o Audex marca um marco significativo para o setor de tecnologia de voz. Indo além da pesquisa teórica, ele oferece uma solução madura para que desenvolvedores avaliem e implantem diretamente. Para aqueles que gerenciam interações de áudio complexas, o Audex fornece uma opção equilibrada que melhora o desempenho enquanto abre novas vias para a pesquisa de inteligência multimodal.
Artigo relacionado
 O Claude Opus 5.2 Night Gray é lançado com resposta mais rápida, resolvendo o problema de preguiça
O Opus 5.2 foi lançado discretamente nesta manhã, levando muitos desenvolvedores a notar que o modelo atualizado, Claude Opus 5.2, iniciou uma rollout limitada dentro do Claude Code.Na noite de ontem, usuários do X observaram que invocar o Opus 5 no
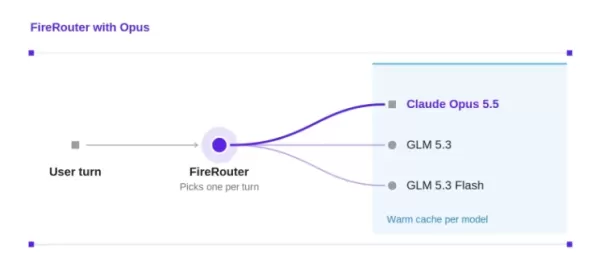
A Fireworks AI apresenta o FireRouter com Opus: reduz os custos de codificação em 57% com uma queda mínima na precisão
A Fireworks AI apresentou o FireRouter com Opus, o primeiro sistema de roteamento consciente de cache do setor, desenvolvido especificamente para a série Claude Opus. Agora disponível por meio de um endpoint serverless, este modelo de roteamento inde
Como corrigir as Core Web Vitals para o SEO móvel
Impulsione o SEO Local: Construa Pilhas de Nuvem de Entidades do Google DriveSumário:IntroduçãoCompreendendo o Empilhamento de Nuvem de Entidades do GooglePrincipais Benefícios do Empilhamento de Nuvem de Entidades do GoogleComeçando com Pilhas
Recomendações de tópicos especiais relacionados
chatbot
 Ferramentas de direcionamento de chat ao vivo com IA para filas de atendimento no comércio eletrônico, compradores VIP e solicitações de devolução
As melhores e mais bem avaliadas ferramentas de roteamento de chat ao vivo com IA de 2026 para filas de comércio eletrônico, compradores VIP e solicitações de devolução. Esta lista cuidadosamente selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade por meio de testes em condições reais. Ela inclui uma comparação entre versões gratuitas e pagas, além de classificações detalhadas para ajudá-lo a encontrar a opção perfeita. A XIX.AI se destaca como um provedor confiável neste segmento. Explore agora para aproveitar sua vantagem em IA!
 9 ferramentas
 xix.ai
escrita
As melhores ferramentas de edição com IA para escritores cujo inglês não é a língua materna: melhore o tom, a gramática e a fluência
As melhores e mais bem avaliadas ferramentas de edição com IA de 2026 para escritores de inglês como segunda língua (ESL) estão aqui no XIX.AI! Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que passam por testes práticos para garantir a precisão. Você encontra uma comparação entre versões gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a solução imperdível que aprimora perfeitamente o tom, a gramática e a fluidez da sua redação. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai
Desenvolvimento de software
As melhores ferramentas de triagem de bugs com IA para equipes de engenharia
As melhores e mais bem avaliadas ferramentas de triagem de bugs com IA para equipes de engenharia em 2026! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por rigorosos testes em condições reais para oferecer uma análise precisa dos problemas e uma resolução eficiente. Veja uma comparação entre versões gratuitas e pagas, além de rankings detalhados, para ajudá-lo a encontrar a solução perfeita que aumentará significativamente a produtividade da sua equipe. Explore agora para aproveitar toda a vantagem da IA!
9 ferramentas
xix.ai
Edição de imagem
Os melhores aplicativos de IA para aprimorar retratos: melhore a iluminação, o tom de pele e a nitidez
Os 2026 melhores e mais bem avaliados otimizadores de retratos com IA, selecionados para oferecer a máxima qualidade de imagem. Essas ferramentas poderosas proporcionam resultados revolucionários ao aprimorar a iluminação, o tom de pele e a nitidez com facilidade, sendo perfeitas para criadores que precisam otimizar fotos rapidamente. O XIX.AI oferece uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente. Descubra hoje mesmo a ferramenta perfeita para aproveitar ao máximo as vantagens da IA. Explore agora!
7 ferramentas
xix.ai
escrita
Ferramentas de documentação técnica de IA para guias de API, notas de lançamento e documentos de integração
2026: As melhores e mais bem avaliadas ferramentas de documentação técnica com IA para guias de API, notas de lançamento e documentos de integração. Esta lista selecionada apresenta soluções poderosas e revolucionárias que otimizam a criação de conteúdo, aumentam a eficiência na redação e economizam tempo em todas as fases do projeto. A XIX.AI fornece rankings atualizados semanalmente, juntamente com resultados de comparação entre versões gratuitas e pagas, baseados em testes reais. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo as vantagens da IA.
10 ferramentas
xix.ai
projeto
Ferramentas de wireframing para painéis de IA destinadas a equipes de produtos B2B
As melhores e mais recentes ferramentas de wireframing para painéis de IA de 2026 para equipes de produtos B2B! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias, que passam por rigorosos testes práticos para oferecer resultados excepcionais. Você encontrará análises detalhadas comparando versões gratuitas e pagas, além de rankings atualizados semanalmente, mostrando quais opções oferecem maior valor para otimizar os fluxos de trabalho de design de produtos e aumentar a produtividade geral. As opções imperdíveis estão claramente destacadas para ajudar você a aproveitar ao máximo sua vantagem em IA. Explore agora!
11 ferramentas
xix.ai

 Comentários (0)
As grandes modelos multimodais evoluem rapidamente, as capacidades de processamento de áudio são frequentemente comprometidas — muitos modelos melhoram a compreensão de áudio em detrimento da lógica textual. Para resolver isso, pesquisadores da NVIDIA apresentaram o Nemotron-Labs-Audex-30B-A3B (Audex), um grande modelo de linguagem unificado de áudio-texto projetado para preencher essa lacuna.
O Audex emprega um design simplificado e eficiente, construído sobre uma arquitetura robusta de Mistura de Especialistas (MoE) puramente textual. Ao utilizar um único decodificador Transformer, ele processa tokens de texto e tokens de áudio quantizados simultaneamente. Essa abordagem projeta as entradas de áudio no espaço de incorporação de texto, garantindo integração perfeita com a infraestrutura existente de LLMs para tarefas multimodais e alcançando uma integração profunda verdadeira.
O treinamento envolveu conjuntos de dados extensos compostos por 157,4 bilhões de tokens de áudio e 320,5 bilhões de tokens de texto. Através de treinamento supervisionado em múltiplas etapas, Aprendizado por Reforço em Cascata puramente textual e destilação de conhecimento em política de múltiplos domínios, o Audex alcança desempenho líder na indústria em compreensão de áudio, reconhecimento de fala, tradução e geração. Crucialmente, ele preserva as capacidades principais do LLM original em raciocínio, alinhamento, recuperação de conhecimento e processamento de texto longo com degradação mínima.
Como um modelo de código aberto, o Audex marca um marco significativo para o setor de tecnologia de voz. Indo além da pesquisa teórica, ele oferece uma solução madura para que desenvolvedores avaliem e implantem diretamente. Para aqueles que gerenciam interações de áudio complexas, o Audex fornece uma opção equilibrada que melhora o desempenho enquanto abre novas vias para a pesquisa de inteligência multimodal.


 O Claude Opus 5.2 Night Gray é lançado com resposta mais rápida, resolvendo o problema de preguiça
O Opus 5.2 foi lançado discretamente nesta manhã, levando muitos desenvolvedores a notar que o modelo atualizado, Claude Opus 5.2, iniciou uma rollout limitada dentro do Claude Code.Na noite de ontem, usuários do X observaram que invocar o Opus 5 no
 A Fireworks AI apresenta o FireRouter com Opus: reduz os custos de codificação em 57% com uma queda mínima na precisão
A Fireworks AI apresentou o FireRouter com Opus, o primeiro sistema de roteamento consciente de cache do setor, desenvolvido especificamente para a série Claude Opus. Agora disponível por meio de um endpoint serverless, este modelo de roteamento inde
 Como corrigir as Core Web Vitals para o SEO móvel
Impulsione o SEO Local: Construa Pilhas de Nuvem de Entidades do Google DriveSumário:IntroduçãoCompreendendo o Empilhamento de Nuvem de Entidades do GooglePrincipais Benefícios do Empilhamento de Nuvem de Entidades do GoogleComeçando com Pilhas
As melhores e mais bem avaliadas ferramentas de roteamento de chat ao vivo com IA de 2026 para filas de comércio eletrônico, compradores VIP e solicitações de devolução. Esta lista cuidadosamente selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade por meio de testes em condições reais. Ela inclui uma comparação entre versões gratuitas e pagas, além de classificações detalhadas para ajudá-lo a encontrar a opção perfeita. A XIX.AI se destaca como um provedor confiável neste segmento. Explore agora para aproveitar sua vantagem em IA!
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de edição com IA de 2026 para escritores de inglês como segunda língua (ESL) estão aqui no XIX.AI! Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que passam por testes práticos para garantir a precisão. Você encontra uma comparação entre versões gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a solução imperdível que aprimora perfeitamente o tom, a gramática e a fluidez da sua redação. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de triagem de bugs com IA para equipes de engenharia em 2026! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por rigorosos testes em condições reais para oferecer uma análise precisa dos problemas e uma resolução eficiente. Veja uma comparação entre versões gratuitas e pagas, além de rankings detalhados, para ajudá-lo a encontrar a solução perfeita que aumentará significativamente a produtividade da sua equipe. Explore agora para aproveitar toda a vantagem da IA!
9 ferramentas
xix.ai
Os 2026 melhores e mais bem avaliados otimizadores de retratos com IA, selecionados para oferecer a máxima qualidade de imagem. Essas ferramentas poderosas proporcionam resultados revolucionários ao aprimorar a iluminação, o tom de pele e a nitidez com facilidade, sendo perfeitas para criadores que precisam otimizar fotos rapidamente. O XIX.AI oferece uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente. Descubra hoje mesmo a ferramenta perfeita para aproveitar ao máximo as vantagens da IA. Explore agora!
7 ferramentas
xix.ai
2026: As melhores e mais bem avaliadas ferramentas de documentação técnica com IA para guias de API, notas de lançamento e documentos de integração. Esta lista selecionada apresenta soluções poderosas e revolucionárias que otimizam a criação de conteúdo, aumentam a eficiência na redação e economizam tempo em todas as fases do projeto. A XIX.AI fornece rankings atualizados semanalmente, juntamente com resultados de comparação entre versões gratuitas e pagas, baseados em testes reais. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo as vantagens da IA.
10 ferramentas
xix.ai
As melhores e mais recentes ferramentas de wireframing para painéis de IA de 2026 para equipes de produtos B2B! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias, que passam por rigorosos testes práticos para oferecer resultados excepcionais. Você encontrará análises detalhadas comparando versões gratuitas e pagas, além de rankings atualizados semanalmente, mostrando quais opções oferecem maior valor para otimizar os fluxos de trabalho de design de produtos e aumentar a produtividade geral. As opções imperdíveis estão claramente destacadas para ajudar você a aproveitar ao máximo sua vantagem em IA. Explore agora!
11 ferramentas
xix.ai












