옵션
속보
콘텐츠
BrianWalker
BrianWalker
2026년 8월 21일

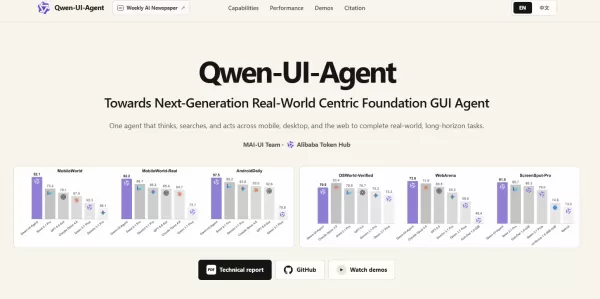
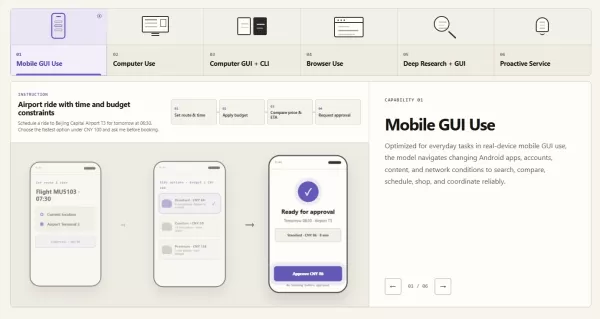
알리바바는 실제 사용 환경을 위해 설계된 GUI 에이전트 파운데이션 모델인 ‘Qwen-UI-Agent’를 공개했습니다. 이 모델은 모바일, 데스크톱, 웹, 딥 서치 플랫폼 전반에서 작동하며, 복잡한 실제 기기에서 직접 구동됨으로써 기존 시뮬레이션 테스트의 한계를 극복합니다. 이 모델은 여러 테스트에서 주요 국제 플래그십 모델들을 능가하는 성과를 보였으며, 모바일 테스트에서 80% 이상의 점수를 기록하고 WebArena 웹 테스트에서 1위를 차지했습니다. 또한 400개 이상의 작업이 포함된 실제 기기 벤치마크를 갖추고 있으며, 효율성을 높이기 위해 일괄 명령 실행을 지원합니다. 이 시스템에는 불법 요청을 거부하고, 민감한 작업은 사용자의 확인을 위해 일시 중지하는 보안 메커니즘이 포함되어 있습니다. 또한 적응형 커리큘럼 훈련을 통해 장기적인 과제에 대한 온라인 강화 학습을 수행할 수 있습니다. 이 프로젝트는 제공된 링크에서 확인할 수 있습니다.
알리바바는 실제 사용 환경을 위해 설계된 GUI 에이전트 파운데이션 모델인 ‘Qwen-UI-Agent’를 공개했습니다. 이 모델은 모바일, 데스크톱, 웹, 딥 서치 플랫폼 전반에서 작동하며, 복잡한 실제 기기에서 직접 구동됨으로써 기존 시뮬레이션 테스트의 한계를 극복합니다. 이 모델은 여러 테스트에서 주요 국제 플래그십 모델들을 능가하는 성과를 보였으며, 모바일 테스트에서 80% 이상의 점수를 기록하고 WebArena 웹 테스트에서 1위를 차지했습니다. 또한 400개 이상의 작업이 포함된 실제 기기 벤치마크를 갖추고 있으며, 효율성을 높이기 위해 일괄 명령 실행을 지원합니다. 이 시스템에는 불법 요청을 거부하고, 민감한 작업은 사용자의 확인을 위해 일시 중지하는 보안 메커니즘이 포함되어 있습니다. 또한 적응형 커리큘럼 훈련을 통해 장기적인 과제에 대한 온라인 강화 학습을 수행할 수 있습니다. 이 프로젝트는 제공된 링크에서 확인할 수 있습니다. 알리바바는 실제 사용 환경을 위해 설계된 GUI 에이전트 파운데이션 모델인 ‘Qwen-UI-Agent’를 공개했습니다. 이 모델은 모바일, 데스크톱, 웹, 딥 서치 플랫폼 전반에서 작동하며, 복잡한 실제 기기에서 직접 구동됨으로써 기존 시뮬레이션 테스트의 한계를 극복합니다. 이 모델은 여러 테스트에서 주요 국제 플래그십 모델들을 능가하는 성과를 보였으며, 모바일 테스트에서 80% 이상의 점수를 기록하고 WebArena 웹 테스트에서 1위를 차지했습니다. 또한 400개 이상의 작업이 포함된 실제 기기 벤치마크를 갖추고 있으며, 효율성을 높이기 위해 일괄 명령 실행을 지원합니다. 이 시스템에는 불법 요청을 거부하고, 민감한 작업은 사용자의 확인을 위해 일시 중지하는 보안 메커니즘이 포함되어 있습니다. 또한 적응형 커리큘럼 훈련을 통해 장기적인 과제에 대한 온라인 강화 학습을 수행할 수 있습니다. 이 프로젝트는 제공된 링크에서 확인할 수 있습니다.
의견 (0)
0/300
OR