


 家
AIの欠点を増幅することで、AIの幻覚に挑む
ChatGPTのような視覚モデルは、画像に欠けている要素を捏造することがよくある。新しいアプローチは、キャプションからモデル自身が幻覚した詳細を誇張したバージョンを生成し、修正を促すことで、このようなエラーを減らす。この手法は再学習や追加データを必要としないため、様々なモデルやアーキテクチャに幅広く適用できる。
中国からの新しい研究は、AIが生成した画像や動画における幻覚という頑固な問題に取り組んでいる。
プロセスは従来通り、モデルが画像を説明するところから始まる。そのキャプションは、新しい画像を生成するためにテキストから画像へ変換するモデルに入力される。元の画像と生成された画像を比較することで、システムは、今後の試行でそのような間違いを繰り返さないようにモデルを誘導する。
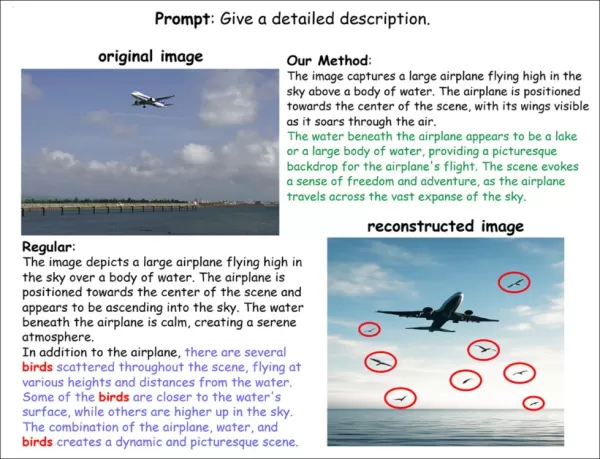
この図は、新しい技術がどのようにキャプションの幻覚を検出し、最小限に抑えるかを示している。標準的なモデルでは、画像の説明に誤って鳥が追加され、再構築されたバージョンでは鳥が視覚的に挿入される(赤でハイライト)。新しい手法では、記述の正確さを維持しながら、このような捏造を避けることができる。出典:https://arxiv.org/pdf/2509.21997
この方法では、まずモデルに実際の画像を描写させるが、その際、実際には存在しない物体や詳細が含まれることがある。これらの不正確なキャプションは、誤りを強調する合成画像を生成する。実画像と合成画像を比較することで、このシステムは偽装コンテンツにつながる内部パターンを特定する。
これらのエラーパターンが認識されると、将来使用するために保存される。新しい画像にキャプションを付ける際、システムはモデルの内部信号を調整し、既知の幻覚の引き金から遠ざける。この修正は、余分なデータ、再トレーニング、テスト中の画像生成なしに、1回のパスで行われる。
エンタングルメントへの挑戦
この論文の例では、「もつれ」によって、何もない画像に鳥が追加された理由が説明されている。
エンタングルメントとは、モデルが特定の概念を強く結びつけるときに発生する。この場合、モデルは飛行機と鳥に頻繁に遭遇し、キャプションに誤った影響を与える関連付けを作り出している可能性がある。
学習を早めに終了することで、もつれを減らすことができる(モデルの柔軟性が高まる)一方で、概念の詳細さや解像度が低下する。開発者は、柔軟でもつれのないモデルを優先させるか、それとも関連する幻覚が生じやすいより生成的なモデルを優先させるか、というトレードオフに直面します。
理想的には、ソース画像のキャプションは、存在するすべてのオブジェクトを箇条書きにし、モデルがそれらを個別の分離された項目として保存できるようにすることです。しかし、強力な生成モデルのトレーニングで一般的な、SEOを重視したキャプションの付け方や大規模なウェブスクレイピングは、しばしばこの基準を下回る。
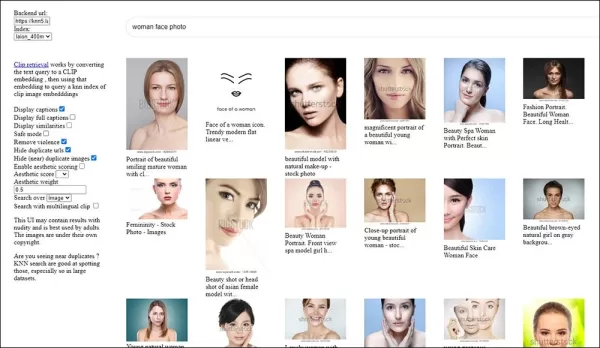
弱いキャプションは、Stable Diffusionのようなモデルを学習するためのLAION画像の価値を低下させます。ラベルはしばしば浅く、曖昧で、説明的ではなくSEOに特化しており、顔の特徴のような詳細な視覚的概念を学習するモデルの能力を妨げている。(元ソースはhttps://rom1504.github.io/、現在は廃止されている)。
基礎的な修正は現実的でないため、LLMやVLMの幻覚を減らすための回避策が重要な研究の焦点となっている。中国の新しい方法は、様々なアーキテクチャと条件でテストされ、"幻覚汚染 "の抑制に有望であることを示している。
著者らは次のように述べている:
複数のベンチマークにわたる広範な実験から、我々の方法は、想起とキャプション[豊富さ]をほぼ維持しながら、オブジェクト、属性、関係の各レベルで幻覚を有意に減少させることが示された」。
Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors』と題されたこの論文は、中国科学技術大学と南京大学の研究者によるものである。
手法の仕組み
研究者たちは、キャプションの幻覚を暴き、抑制するためのエンドツーエンドのパイプラインを開発した:
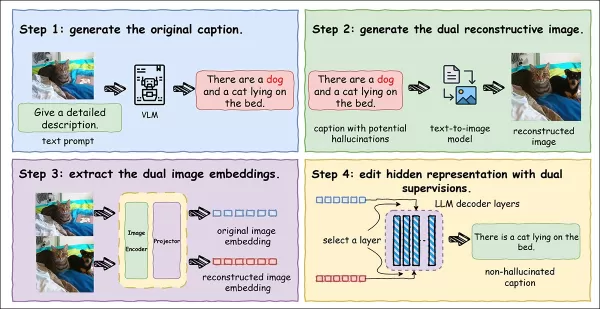
パイプラインの全体図。視覚言語モデルが入力画像から幻覚を含む可能性のあるキャプションを生成する。そのキャプションは、テキストから画像へのモデルを介して再構築された画像を作成するために使用され、エラーを可視化する。両方の画像からの埋め込みが内部調整のガイドとなり、キャプションの品質を失うことなく、モデルが発明された詳細を減らすのに役立つ。
視覚言語モデルはまず実画像にキャプションを付け、場合によってはオブジェクトや関係性を創作する。そのキャプションによって再構成された画像が生成され、捏造が視覚的な不一致として明らかになる。2つの画像を比較することで、微妙なテキストの誤りが測定可能で修正可能な信号に変わります。
捏造を阻止するために、システムは元の画像(信頼できる参照)と再構築された画像(エラーを強調)を比較する。それぞれはコンパクトな埋め込みに変換される。より原画に近づけ、再構成から乖離するように内部表現を調整することで、モデルは完全に自己教師付きで自己修正する。
論文では次のように説明されている:
MLLMにおける幻覚は、言語的に整っており、テキストレベルの忠実な記述と見分けがつかないことが多いため、本質的に検出が難しい。この不一致は、言語的妥当性ではなく、視覚的証拠とのズレにある。
この問題に対処するために、生成的再構成を活用して、暗黙の矛盾を明示的で観察可能な信号に変換する幻覚暴露メカニズムを導入する」。
FLUX.1-devのテキストから画像へのモデルを使用して、システムはキャプションから画像を再現し、誤った詳細を誇張する。これらの増幅されたエラーは、モデルが誤りを認識し修正するのに役立つ。
このアプローチを検証するため、研究者はキャプションに幻覚を注入し、再構成した画像を生成し、LLaVAでキャプションを付け直した。元のキャプションと幻覚のキャプションの間の意味的類似性を測定した:
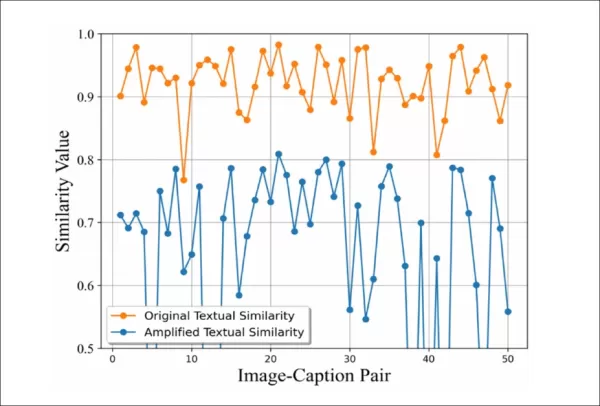
幻覚の増幅メカニズムは、微妙なエラーを可視化する。各ポイントは画像とキャプションのペアに対するキャプションの類似度を示す。オレンジ色の線(直接比較)は高いままであり、間違いを覆い隠している。青色の線(再構成後)は急激に下がり、検出可能な意味マーカーとして隠れた幻覚が明らかになる。
再構築後、類似度は著しく低下し、この方法が微妙な誤りを明らかにする能力を持つことが実証された。
データとテスト
3つのベンチマークを用いて有効性を検証した:Caption Hallucination Assessment with Image Relevance(CHAIR)、MLLM Evaluation(MME)、Pooling-based Object Probing Evaluation(POPE)。
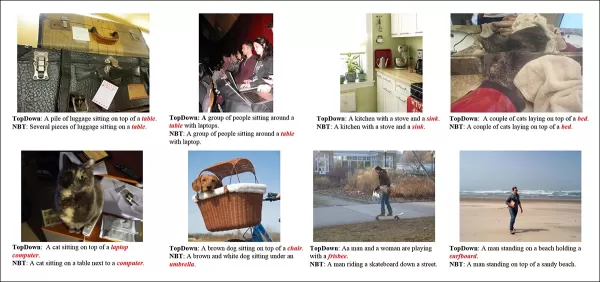
CHAIRリリースペーパーより:キャプションシステムTopDownとNBTによって生成された幻覚オブジェクトの例。出典:https://arxiv.org/pdf/1809.02156
幻覚率や想起率のような標準的な指標は、誤解を招く可能性があります-モデルは、曖昧なキャプションを生成することでエラーを回避するかもしれません。正確さと完全性のバランスをとるために、HAR@β(Hallucination and Recall)という指標を使用し、重み付けを調整することで、両方の要素でキャプションを評価しました。
POPEは文脈依存の物体幻覚を評価し、MMEは属性レベルの幻覚を評価した。
テストは、Microsoft COCO、A-OKVQA、GQAを含むデータセットで、FluxモデルとLLaVA-v1.5-7Bを用いた。潜在編集はモデルの第2層を対象とし、すべてのテストにおいて一貫したハイパーパラメータと温度を用いた。
CHAIRの初期結果を以下に示す*:
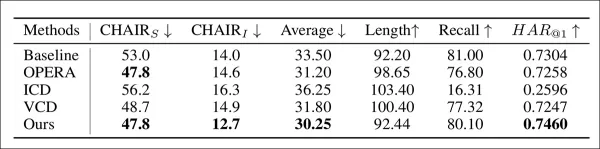
CHAIRベンチマークにおける幻覚軽減のパフォーマンス。
著者らは次のように述べている:
我々の方法は、CHAIRSと CHAIRI[*]の両方において、他のベースラインを一貫して上回っており、幻覚を抑制する上で優れた効果を示している。一方、ほぼすべての手法が幻覚を抑制する間に想起を低下させるのは避けられないが、これは忠実さと情報量のトレードオフを反映している。
このことは、我々の手法が、広範な真実の対象を捉えていることを示している」。HAR@β指標では、我々の手法が最も高いスコアを達成し、カバレッジを維持しながら幻覚を減らす能力を強調している」。
強力な結果は、二重監視によるものである。すなわち、元の画像からきれいな意味論を強化する一方で、再構成からの誤解を招く信号を抑制する。幻覚に関連する方向のみをターゲットとすることで、システムはディテールを失うことなくエラーを修正する。
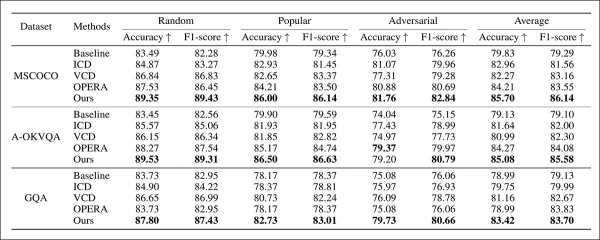
異なる構成とデータセットにわたるPOPEベンチマークでの性能比較。
POPEの結果について、論文は次のように述べている:
我々の方法は、すべての設定において一貫して最高の性能を達成していることが観察される。特筆すべきは、我々の手法は平均で最大+5.95%の精度と+6.85%のF1スコアを達成することができ、他のトレーニングフリーのアプローチを大きく上回っている。
従って、これらの結果は、我々の手法が様々な難易度にわたって信頼性が高く、一般化可能なソリューションを提供することを示している」。
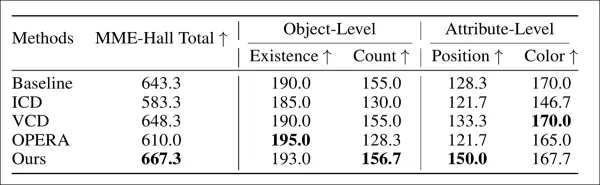
MMEでの第3回テストラウンドのパフォーマンス比較。
最後のメインテストはMMEで行われ、結果は上記の通り。しかし、この論文では、本文でも付録でも定義なしに「OPERA」という手法に言及している。著者はMMEの強力なパフォーマンスを主張しているが、メソッドの詳細が記載されていないため、これらの結果の解釈には注意が必要である。
関連記事
 ByteDance、コアAIインセンティブを強化、Doubaoが14.6%急伸
ByteDanceは最近、DouBaoの株式に関する説明会を開催し、DouBao部門に関わる従業員向けの新たなインセンティブ政策を発表した。DouBao株式の行使価格は2026年6月の14.85ドルから17.02ドルに引き上げられ、約14.6%の増加となった。この改定により、DouBao株式の評価額が上昇するだけでなく、その配布範囲も大幅に拡大した。個人の役割に応じて、一部の従業員は総報酬の約5%に相当するDouBao株式を受け取ることができる。新しい交換メカニズムの下、ByteDanceは従
MiniMax、グローバルのAI専門家に対するインセンティブを提供する「10xチームプログラム」を発表
MiniMax(稀宇科技)の汎用人工知能ラボは、グローバルな人材連携イニシアチブ「10xチーム」を正式に開始しました。このプログラムは、大規模モデルの専門分野における深い応用を探求するために、各業界のトップエキスパートを募集することを目的としています。深い業界知識と最先端のAIを統合することで、MiniMaxは汎用から専門的なシナリオへと大規模モデルの生産性を拡大し、最終的に業界の効率に「10倍の増加」をもたらすことを目指しています。業界の認知価値を検証し、マルチモーダルの中核リソースを開放す
韓国、国家AI計算センターの起工式を実施、2.5兆ウォンを投資し2028年の完成を目指す
韓国のアウトレッツ、EtNewsの報道によると、全羅南道順天のソラーシティデータセンターパークで、8月3日に韓国AI計算センター(KOACC)の起工式が行われた。総投資額2.5兆ウォン(約118億3800万元)を背景に、この施設は2028年の運用開始を目指しており、これまでに韓国がAIインフラに対して行った国家投資の中で最も大規模なものの一つとなっている。プロジェクトの株式配分は、政府と企業の深い連携を推進する戦略的な取り組みを示している。サムスンSDSが30%の株式を持つ最大株主として主導し
関連特集おすすめ
教育と学習
 宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
 10 ツール
 xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

 コメント (0)
0/500
ChatGPTのような視覚モデルは、画像に欠けている要素を捏造することがよくある。新しいアプローチは、キャプションからモデル自身が幻覚した詳細を誇張したバージョンを生成し、修正を促すことで、このようなエラーを減らす。この手法は再学習や追加データを必要としないため、様々なモデルやアーキテクチャに幅広く適用できる。
中国からの新しい研究は、AIが生成した画像や動画における幻覚という頑固な問題に取り組んでいる。
プロセスは従来通り、モデルが画像を説明するところから始まる。そのキャプションは、新しい画像を生成するためにテキストから画像へ変換するモデルに入力される。元の画像と生成された画像を比較することで、システムは、今後の試行でそのような間違いを繰り返さないようにモデルを誘導する。

この図は、新しい技術がどのようにキャプションの幻覚を検出し、最小限に抑えるかを示している。標準的なモデルでは、画像の説明に誤って鳥が追加され、再構築されたバージョンでは鳥が視覚的に挿入される(赤でハイライト)。新しい手法では、記述の正確さを維持しながら、このような捏造を避けることができる。出典:https://arxiv.org/pdf/2509.21997
この方法では、まずモデルに実際の画像を描写させるが、その際、実際には存在しない物体や詳細が含まれることがある。これらの不正確なキャプションは、誤りを強調する合成画像を生成する。実画像と合成画像を比較することで、このシステムは偽装コンテンツにつながる内部パターンを特定する。
これらのエラーパターンが認識されると、将来使用するために保存される。新しい画像にキャプションを付ける際、システムはモデルの内部信号を調整し、既知の幻覚の引き金から遠ざける。この修正は、余分なデータ、再トレーニング、テスト中の画像生成なしに、1回のパスで行われる。
エンタングルメントへの挑戦
この論文の例では、「もつれ」によって、何もない画像に鳥が追加された理由が説明されている。
エンタングルメントとは、モデルが特定の概念を強く結びつけるときに発生する。この場合、モデルは飛行機と鳥に頻繁に遭遇し、キャプションに誤った影響を与える関連付けを作り出している可能性がある。
学習を早めに終了することで、もつれを減らすことができる(モデルの柔軟性が高まる)一方で、概念の詳細さや解像度が低下する。開発者は、柔軟でもつれのないモデルを優先させるか、それとも関連する幻覚が生じやすいより生成的なモデルを優先させるか、というトレードオフに直面します。
理想的には、ソース画像のキャプションは、存在するすべてのオブジェクトを箇条書きにし、モデルがそれらを個別の分離された項目として保存できるようにすることです。しかし、強力な生成モデルのトレーニングで一般的な、SEOを重視したキャプションの付け方や大規模なウェブスクレイピングは、しばしばこの基準を下回る。

弱いキャプションは、Stable Diffusionのようなモデルを学習するためのLAION画像の価値を低下させます。ラベルはしばしば浅く、曖昧で、説明的ではなくSEOに特化しており、顔の特徴のような詳細な視覚的概念を学習するモデルの能力を妨げている。(元ソースはhttps://rom1504.github.io/、現在は廃止されている)。
基礎的な修正は現実的でないため、LLMやVLMの幻覚を減らすための回避策が重要な研究の焦点となっている。中国の新しい方法は、様々なアーキテクチャと条件でテストされ、"幻覚汚染 "の抑制に有望であることを示している。
著者らは次のように述べている:
複数のベンチマークにわたる広範な実験から、我々の方法は、想起とキャプション[豊富さ]をほぼ維持しながら、オブジェクト、属性、関係の各レベルで幻覚を有意に減少させることが示された」。
Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors』と題されたこの論文は、中国科学技術大学と南京大学の研究者によるものである。
手法の仕組み
研究者たちは、キャプションの幻覚を暴き、抑制するためのエンドツーエンドのパイプラインを開発した:

パイプラインの全体図。視覚言語モデルが入力画像から幻覚を含む可能性のあるキャプションを生成する。そのキャプションは、テキストから画像へのモデルを介して再構築された画像を作成するために使用され、エラーを可視化する。両方の画像からの埋め込みが内部調整のガイドとなり、キャプションの品質を失うことなく、モデルが発明された詳細を減らすのに役立つ。
視覚言語モデルはまず実画像にキャプションを付け、場合によってはオブジェクトや関係性を創作する。そのキャプションによって再構成された画像が生成され、捏造が視覚的な不一致として明らかになる。2つの画像を比較することで、微妙なテキストの誤りが測定可能で修正可能な信号に変わります。
捏造を阻止するために、システムは元の画像(信頼できる参照)と再構築された画像(エラーを強調)を比較する。それぞれはコンパクトな埋め込みに変換される。より原画に近づけ、再構成から乖離するように内部表現を調整することで、モデルは完全に自己教師付きで自己修正する。
論文では次のように説明されている:
MLLMにおける幻覚は、言語的に整っており、テキストレベルの忠実な記述と見分けがつかないことが多いため、本質的に検出が難しい。この不一致は、言語的妥当性ではなく、視覚的証拠とのズレにある。
この問題に対処するために、生成的再構成を活用して、暗黙の矛盾を明示的で観察可能な信号に変換する幻覚暴露メカニズムを導入する」。
FLUX.1-devのテキストから画像へのモデルを使用して、システムはキャプションから画像を再現し、誤った詳細を誇張する。これらの増幅されたエラーは、モデルが誤りを認識し修正するのに役立つ。
このアプローチを検証するため、研究者はキャプションに幻覚を注入し、再構成した画像を生成し、LLaVAでキャプションを付け直した。元のキャプションと幻覚のキャプションの間の意味的類似性を測定した:

幻覚の増幅メカニズムは、微妙なエラーを可視化する。各ポイントは画像とキャプションのペアに対するキャプションの類似度を示す。オレンジ色の線(直接比較)は高いままであり、間違いを覆い隠している。青色の線(再構成後)は急激に下がり、検出可能な意味マーカーとして隠れた幻覚が明らかになる。
再構築後、類似度は著しく低下し、この方法が微妙な誤りを明らかにする能力を持つことが実証された。
データとテスト
3つのベンチマークを用いて有効性を検証した:Caption Hallucination Assessment with Image Relevance(CHAIR)、MLLM Evaluation(MME)、Pooling-based Object Probing Evaluation(POPE)。

CHAIRリリースペーパーより:キャプションシステムTopDownとNBTによって生成された幻覚オブジェクトの例。出典:https://arxiv.org/pdf/1809.02156
幻覚率や想起率のような標準的な指標は、誤解を招く可能性があります-モデルは、曖昧なキャプションを生成することでエラーを回避するかもしれません。正確さと完全性のバランスをとるために、HAR@β(Hallucination and Recall)という指標を使用し、重み付けを調整することで、両方の要素でキャプションを評価しました。
POPEは文脈依存の物体幻覚を評価し、MMEは属性レベルの幻覚を評価した。
テストは、Microsoft COCO、A-OKVQA、GQAを含むデータセットで、FluxモデルとLLaVA-v1.5-7Bを用いた。潜在編集はモデルの第2層を対象とし、すべてのテストにおいて一貫したハイパーパラメータと温度を用いた。
CHAIRの初期結果を以下に示す*:

CHAIRベンチマークにおける幻覚軽減のパフォーマンス。
著者らは次のように述べている:
我々の方法は、CHAIRSと CHAIRI[*]の両方において、他のベースラインを一貫して上回っており、幻覚を抑制する上で優れた効果を示している。一方、ほぼすべての手法が幻覚を抑制する間に想起を低下させるのは避けられないが、これは忠実さと情報量のトレードオフを反映している。
このことは、我々の手法が、広範な真実の対象を捉えていることを示している」。HAR@β指標では、我々の手法が最も高いスコアを達成し、カバレッジを維持しながら幻覚を減らす能力を強調している」。
強力な結果は、二重監視によるものである。すなわち、元の画像からきれいな意味論を強化する一方で、再構成からの誤解を招く信号を抑制する。幻覚に関連する方向のみをターゲットとすることで、システムはディテールを失うことなくエラーを修正する。

異なる構成とデータセットにわたるPOPEベンチマークでの性能比較。
POPEの結果について、論文は次のように述べている:
我々の方法は、すべての設定において一貫して最高の性能を達成していることが観察される。特筆すべきは、我々の手法は平均で最大+5.95%の精度と+6.85%のF1スコアを達成することができ、他のトレーニングフリーのアプローチを大きく上回っている。
従って、これらの結果は、我々の手法が様々な難易度にわたって信頼性が高く、一般化可能なソリューションを提供することを示している」。

MMEでの第3回テストラウンドのパフォーマンス比較。
最後のメインテストはMMEで行われ、結果は上記の通り。しかし、この論文では、本文でも付録でも定義なしに「OPERA」という手法に言及している。著者はMMEの強力なパフォーマンスを主張しているが、メソッドの詳細が記載されていないため、これらの結果の解釈には注意が必要である。








 ByteDance、コアAIインセンティブを強化、Doubaoが14.6%急伸
ByteDanceは最近、DouBaoの株式に関する説明会を開催し、DouBao部門に関わる従業員向けの新たなインセンティブ政策を発表した。DouBao株式の行使価格は2026年6月の14.85ドルから17.02ドルに引き上げられ、約14.6%の増加となった。この改定により、DouBao株式の評価額が上昇するだけでなく、その配布範囲も大幅に拡大した。個人の役割に応じて、一部の従業員は総報酬の約5%に相当するDouBao株式を受け取ることができる。新しい交換メカニズムの下、ByteDanceは従
 MiniMax、グローバルのAI専門家に対するインセンティブを提供する「10xチームプログラム」を発表
MiniMax(稀宇科技)の汎用人工知能ラボは、グローバルな人材連携イニシアチブ「10xチーム」を正式に開始しました。このプログラムは、大規模モデルの専門分野における深い応用を探求するために、各業界のトップエキスパートを募集することを目的としています。深い業界知識と最先端のAIを統合することで、MiniMaxは汎用から専門的なシナリオへと大規模モデルの生産性を拡大し、最終的に業界の効率に「10倍の増加」をもたらすことを目指しています。業界の認知価値を検証し、マルチモーダルの中核リソースを開放す
 韓国、国家AI計算センターの起工式を実施、2.5兆ウォンを投資し2028年の完成を目指す
韓国のアウトレッツ、EtNewsの報道によると、全羅南道順天のソラーシティデータセンターパークで、8月3日に韓国AI計算センター(KOACC)の起工式が行われた。総投資額2.5兆ウォン(約118億3800万元)を背景に、この施設は2028年の運用開始を目指しており、これまでに韓国がAIインフラに対して行った国家投資の中で最も大規模なものの一つとなっている。プロジェクトの株式配分は、政府と企業の深い連携を推進する戦略的な取り組みを示している。サムスンSDSが30%の株式を持つ最大株主として主導し

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai












