


 家
OpenCUAのオープンソースAIエージェントがOpenAIとAnthropicの独自モデルに挑戦
香港大学(HKU)とパートナー機関の研究者は、コンピュータを操作できるAIエージェントを構築するための強固な基盤を確立する革新的なオープンソースフレームワーク「OpenCUA」を開発した。この包括的なツールキットは、専用ツール、広範なトレーニングデータセット、実証済みの方法論など、コンピュータ利用エージェント(CUA)開発のスケーリングに不可欠なコンポーネントを提供します。
初期評価では、OpenCUAで訓練されたモデルは、OpenAIやAnthropicのような業界リーダーのプロプライエタリシステムに匹敵する一方で、他のオープンソースソリューションと比較してCUAベンチマークで優れたパフォーマンスを達成することが実証されています。
コンピュータ・エージェント開発の複雑な課題
コンピュータユースエージェントは、単純なウェブナビゲーションから複雑なソフトウェア操作に至るまで、デジタルタスクを自律的に実行するように設計された、変革的なAIの一種です。これらのインテリジェント・システムは、企業のワークフロー自動化に多大な可能性を秘めているが、ほとんどの先進的なCUAは、プロプライエタリなブラックボックスのままである。
「商用CUAの透明性の欠如は、技術的進歩を制限し、重要な安全上の問題を提起する」と研究チームは発表した論文で指摘している。「科学コミュニティは、機能、限界、潜在的リスクを適切に調査するために、真にオープンなフレームワークを必要としている。
現在のオープンソースの取り組みは、以下のような大きな障害に直面している:
- 大規模で多様なデータ収集のための不十分なインフラストラクチャ
- 質の高いGUIインタラクションのデータセットが限られている
- 研究の再現を困難にする不十分な文書化
論文では次のように説明されている:"これらの制約は、総体的に汎用CUAの進歩を妨げ、そのスケーラビリティ、汎化能力、最適な学習アプローチの包括的な探求を妨げている。"
OpenCUAフレームワークの紹介
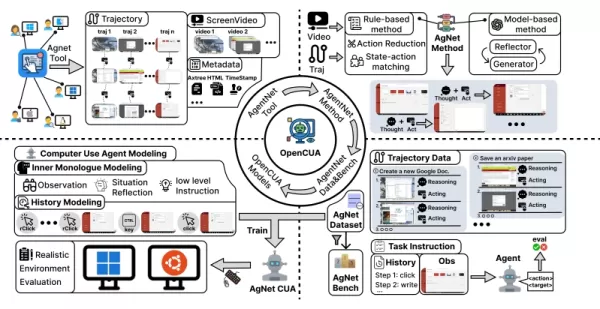
*OpenCUAアーキテクチャの概要(出典:XLANG Lab at HKU)*。 OpenCUAフレームワークは、データ収集とモデルトレーニングの両方の課題に対応する統合ソリューションを紹介する。その中心的なコンポーネントはAgentNet Toolで、複数のオペレーティングシステムにまたがる人間とコンピュータのインタラクションを詳細にキャプチャする専用ソフトウェアです。
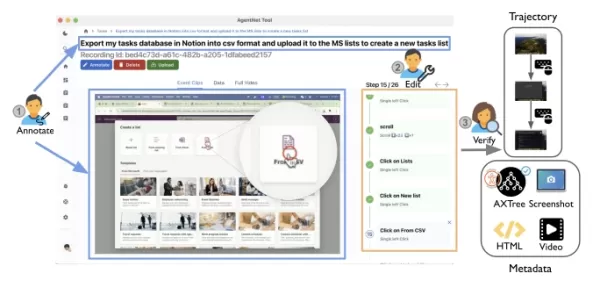
*AgentNetデータ収集ツール(出典:HKUのXLangラボ)*。 この革新的なツールは、バックグラウンドで目立たないように動作し、記録する:
- 画面操作ビデオ
- 正確なマウス/キーボード入力
- 画面上の要素を定義するアクセシビリティ・ツリー構造
研究者たちは、この生のインタラクション・データを、コンピュータのスクリーンショットと対応するユーザーのアクションを対にした、洗練された「状態-アクション軌跡」に加工した。その結果、AgentNetデータセットは、Windows、macOS、Ubuntu環境、200以上の多様なアプリケーションやウェブサイトにわたる22,600以上のタスクデモで構成されている。
HKUの博士研究員で研究の共著者であるXinyuan Wang氏は、厳格なプライバシー保護を強調している:"私たちは、多層的なセキュリティフレームワークを実装し、アノテーターが自分の提出物を完全に可視化し、制御できるようにしました。" "その後、手動で検証し、データ公開前に自動化された機密コンテンツのスキャンを行いました。"
革新的なトレーニング方法
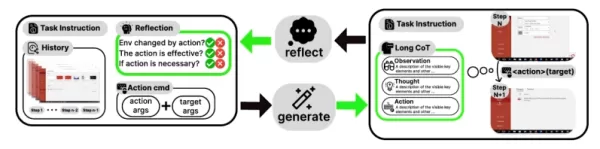
*OpenCUAの思考連鎖型推論プロセス(出典:XLang Lab at HKU)*1 このフレームワークは、構造化された思考連鎖推論と、クリーニングされたステート・アクション・ペアを組み合わせた新しいデータ処理パイプラインを導入している。このアプローチは、各アクションの詳細な「認知的モノローグ」を生成する:
- 高レベルの画面観察
- 戦略的分析と計画
- 正確な実行可能命令
Wang氏によると、企業は、内部のワークフローを記録し、同じ推論フレームワークを適用することで、このパイプラインを独自のシステムに特化したエージェントのトレーニングに適応させることができる。「これにより、企業は手作業で推論トレースを作成することなく、高性能なカスタムエージェントを開発することができます」と王氏は説明する。
ベンチマーク性能とエンタープライズ・アプリケーション
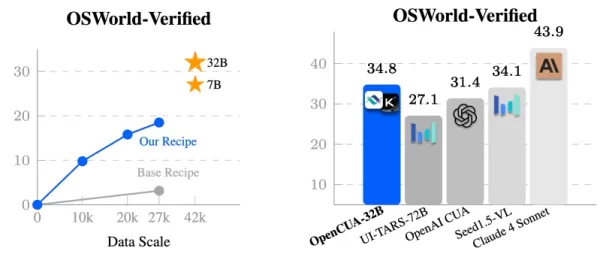
*OpenCUAのパフォーマンス比較(出典:HKUのXLANGラボ)*。 320億パラメータのOpenCUAモデルは、OSWorld-Verifiedベンチマークでオープンソースソリューションの中で記録的なパフォーマンスを達成し、同時に主要なプロプライエタリシステムとの差を大幅に縮めました。企業にとって重要なポイントは以下の通りです:
- 多様なモデルアーキテクチャとスケールに渡るフレームワークの適用性
- プラットフォームやタスクの種類を超えた強力な汎用性
- 反復的なワークフローの自動化に特に有効
Wang氏は、実装上の課題を強調した:"実世界への展開には、タスク実行中の意図しないシステム変更や有害な副作用を防止する強固な安全メカニズムが必要である"
研究チームは、ソースコード、データセット、モデルウェイトを含むすべてのフレームワークコンポーネントをオープンにしている。OpenCUA主導のエージェントが進歩すれば、AIが業務実行を処理する間、人間の労働者は戦略的目標に集中できるようになり、職場のダイナミクスを根本的に変革する可能性がある。
関連記事
 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA
秘密の追跡データがAIモデルの盗難を暴露
新たな手法により、ChatGPTのようなモデルに再学習なしで数秒で目に見えない透かしを埋め込める。標準出力に痕跡を残さず、あらゆる実用的な除去試みを耐えうる。 透かしと「著作権侵害の誘引」の主な違いは、透かし(可視・不可視を問わず)が通常、画像データセットなどのコレクション全体に一貫して配置され、軽率な複製に対する抑止力として設計されている点である。これに対し、偽装エントリとは、大規模な汎用コレク
関連特集おすすめ
書き込み
 長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
 8 ツール
 xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

 コメント (1)
0/500
![JuanJackson]()
Любопытно, как открытые проекты вроде OpenCUA бросят вызов гигантам вроде OpenAI. Может, наконец-то появится реальная альтернатива? Хотя, конечно, всегда есть опасения по поводу безопасности таких агентов — вдруг начнут делать что-то не то? 😅
香港大学(HKU)とパートナー機関の研究者は、コンピュータを操作できるAIエージェントを構築するための強固な基盤を確立する革新的なオープンソースフレームワーク「OpenCUA」を開発した。この包括的なツールキットは、専用ツール、広範なトレーニングデータセット、実証済みの方法論など、コンピュータ利用エージェント(CUA)開発のスケーリングに不可欠なコンポーネントを提供します。
初期評価では、OpenCUAで訓練されたモデルは、OpenAIやAnthropicのような業界リーダーのプロプライエタリシステムに匹敵する一方で、他のオープンソースソリューションと比較してCUAベンチマークで優れたパフォーマンスを達成することが実証されています。
コンピュータ・エージェント開発の複雑な課題
コンピュータユースエージェントは、単純なウェブナビゲーションから複雑なソフトウェア操作に至るまで、デジタルタスクを自律的に実行するように設計された、変革的なAIの一種です。これらのインテリジェント・システムは、企業のワークフロー自動化に多大な可能性を秘めているが、ほとんどの先進的なCUAは、プロプライエタリなブラックボックスのままである。
「商用CUAの透明性の欠如は、技術的進歩を制限し、重要な安全上の問題を提起する」と研究チームは発表した論文で指摘している。「科学コミュニティは、機能、限界、潜在的リスクを適切に調査するために、真にオープンなフレームワークを必要としている。
現在のオープンソースの取り組みは、以下のような大きな障害に直面している:
- 大規模で多様なデータ収集のための不十分なインフラストラクチャ
- 質の高いGUIインタラクションのデータセットが限られている
- 研究の再現を困難にする不十分な文書化
論文では次のように説明されている:"これらの制約は、総体的に汎用CUAの進歩を妨げ、そのスケーラビリティ、汎化能力、最適な学習アプローチの包括的な探求を妨げている。"
OpenCUAフレームワークの紹介
OpenCUAフレームワークは、データ収集とモデルトレーニングの両方の課題に対応する統合ソリューションを紹介する。その中心的なコンポーネントはAgentNet Toolで、複数のオペレーティングシステムにまたがる人間とコンピュータのインタラクションを詳細にキャプチャする専用ソフトウェアです。
この革新的なツールは、バックグラウンドで目立たないように動作し、記録する:
- 画面操作ビデオ
- 正確なマウス/キーボード入力
- 画面上の要素を定義するアクセシビリティ・ツリー構造
研究者たちは、この生のインタラクション・データを、コンピュータのスクリーンショットと対応するユーザーのアクションを対にした、洗練された「状態-アクション軌跡」に加工した。その結果、AgentNetデータセットは、Windows、macOS、Ubuntu環境、200以上の多様なアプリケーションやウェブサイトにわたる22,600以上のタスクデモで構成されている。
HKUの博士研究員で研究の共著者であるXinyuan Wang氏は、厳格なプライバシー保護を強調している:"私たちは、多層的なセキュリティフレームワークを実装し、アノテーターが自分の提出物を完全に可視化し、制御できるようにしました。" "その後、手動で検証し、データ公開前に自動化された機密コンテンツのスキャンを行いました。"
革新的なトレーニング方法
このフレームワークは、構造化された思考連鎖推論と、クリーニングされたステート・アクション・ペアを組み合わせた新しいデータ処理パイプラインを導入している。このアプローチは、各アクションの詳細な「認知的モノローグ」を生成する:
- 高レベルの画面観察
- 戦略的分析と計画
- 正確な実行可能命令
Wang氏によると、企業は、内部のワークフローを記録し、同じ推論フレームワークを適用することで、このパイプラインを独自のシステムに特化したエージェントのトレーニングに適応させることができる。「これにより、企業は手作業で推論トレースを作成することなく、高性能なカスタムエージェントを開発することができます」と王氏は説明する。
ベンチマーク性能とエンタープライズ・アプリケーション
320億パラメータのOpenCUAモデルは、OSWorld-Verifiedベンチマークでオープンソースソリューションの中で記録的なパフォーマンスを達成し、同時に主要なプロプライエタリシステムとの差を大幅に縮めました。企業にとって重要なポイントは以下の通りです:
- 多様なモデルアーキテクチャとスケールに渡るフレームワークの適用性
- プラットフォームやタスクの種類を超えた強力な汎用性
- 反復的なワークフローの自動化に特に有効
Wang氏は、実装上の課題を強調した:"実世界への展開には、タスク実行中の意図しないシステム変更や有害な副作用を防止する強固な安全メカニズムが必要である"
研究チームは、ソースコード、データセット、モデルウェイトを含むすべてのフレームワークコンポーネントをオープンにしている。OpenCUA主導のエージェントが進歩すれば、AIが業務実行を処理する間、人間の労働者は戦略的目標に集中できるようになり、職場のダイナミクスを根本的に変革する可能性がある。








 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
 マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA
 秘密の追跡データがAIモデルの盗難を暴露
新たな手法により、ChatGPTのようなモデルに再学習なしで数秒で目に見えない透かしを埋め込める。標準出力に痕跡を残さず、あらゆる実用的な除去試みを耐えうる。 透かしと「著作権侵害の誘引」の主な違いは、透かし(可視・不可視を問わず)が通常、画像データセットなどのコレクション全体に一貫して配置され、軽率な複製に対する抑止力として設計されている点である。これに対し、偽装エントリとは、大規模な汎用コレク

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

Любопытно, как открытые проекты вроде OpenCUA бросят вызов гигантам вроде OpenAI. Может, наконец-то появится реальная альтернатива? Хотя, конечно, всегда есть опасения по поводу безопасности таких агентов — вдруг начнут делать что-то не то? 😅












