


 Maison
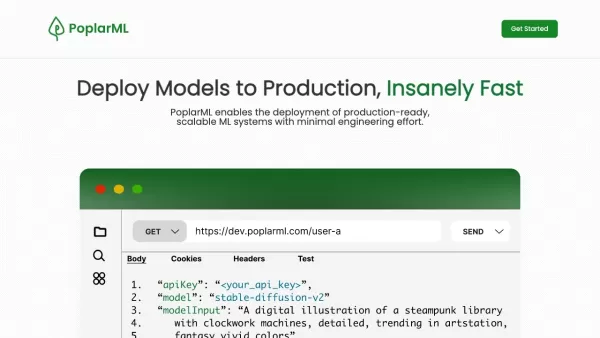
PoplarML - Deploy Models to Production
PoplarML : déploiement facile de modèles ML


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
Désaction AI Pro, souvent appelée Deepnude, est un outil très controversé qui a suscité tout à fait le débat. Il utilise des algorithmes d'apprentissage automatique sophistiqués pour éliminer numériquement les vêtements des images de personnes. C'est un concept sauvage, non? Mais le
Vous êtes-vous déjà demandé ce qui fait que Deepseek Ai se démarque dans le monde bondé de l'IA Tech? Eh bien, permettez-moi de vous dire que Deepseek IA n'est pas seulement un autre joueur du jeu; C'est le principal fournisseur de modèles avancés en langue AI et de solutions d'entreprise. Ce qui les définit APA
Qu'est-ce qu'GPT OSS ? GPT OSS marque une étape décisive dans la démocratisation de l'IA avancée, introduite par OpenAI le 5 août 2025. Cette famille open source comprend deux modèles r
Vous êtes-vous déjà demandé ce que ce serait de créer une version numérique de vous-même ou de quelqu'un d'autre? C'est là que Meshcapade Me entre en jeu - une plate-forme de pointe qui vous permet de créer des humains numériques 3D incroyablement réalisants. Que vous ayez quelques photos, SOM
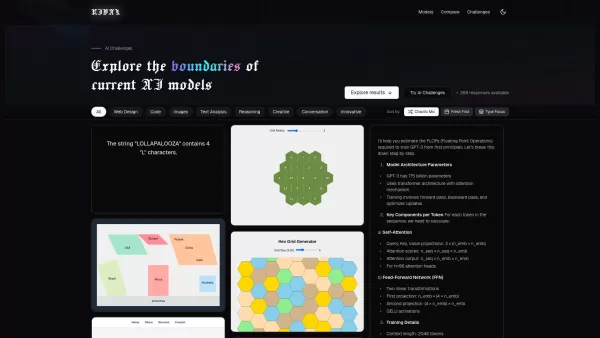
Vous êtes-vous déjà demandé comment différents modèles d'IA se comparent les uns contre les autres? Entrez Rival, une application Web élégante conçue pour vous permettre de plonger profondément dans le monde des comparaisons d'IA. C'est comme avoir un siège de première rang pour une épreuve de force entre GPT-4O, Claude 3.7 et Grok-3, où vous pouvez les voir s'attaquer à T
PoplarML - Deploy Models to Production Informations sur les produits
PoplarML change la donne pour tous ceux qui ont déjà rencontré des difficultés pour déployer des modèles d'apprentissage automatique en production. Cette plateforme élimine toute complexité et permet de mettre en place vos modèles sur une flotte de GPU en quelques clics seulement. Que vous travailliez avec Tensorflow, Pytorch ou JAX, PoplarML est là pour vous aider. Et le meilleur dans tout ça ? Vous pouvez exploiter vos modèles en temps réel à l'aide d'un simple point de terminaison API REST. C'est comme si vous disposiez d'un super-pouvoir pour vos projets d'apprentissage automatique !
Comment démarrer avec PoplarML
Prêt à vous lancer ? Voici comment commencer à utiliser PoplarML :
- Inscrivez-vous : rendez-vous sur leur site web et créez un compte. C'est rapide et facile, et vous serez opérationnel en un rien de temps.
- Déployez vos modèles : utilisez l'outil CLI fourni par PoplarML pour déployer vos modèles ML sur leur parc de GPU. Ils s'occupent de la mise à l'échelle, vous n'avez donc à vous soucier de rien.
- Prévisions en temps réel : une fois votre modèle déployé, vous pouvez l'appeler via une API REST pour obtenir des prévisions instantanées. Plus besoin d'attendre !
- Utilisez n'importe quel framework : que vous utilisiez Tensorflow, Pytorch ou JAX, PoplarML les prend tous en charge. Apportez simplement votre modèle, ils s'occupent du reste.
Principales fonctionnalités de PoplarML
- Déploiement transparent : déployez vos modèles ML sans effort à l'aide de l'outil CLI sur un parc de GPU.
- Inférence en temps réel : obtenez des prédictions instantanées en appelant votre modèle via un point de terminaison API REST.
- Indépendant du framework : prend en charge Tensorflow, Pytorch et JAX, vous n'êtes donc pas lié à un seul framework.
Cas d'utilisation de PoplarML
- Déploiement en production : idéal pour mettre rapidement vos modèles ML en production.
- Évolutivité aisée : faites évoluer vos systèmes ML sans effort, grâce à un travail d'ingénierie minimal.
- Informations en temps réel : activez l'inférence en temps réel pour vos modèles déployés, rendant vos applications plus réactives.
- Flexibilité du framework : prend en charge une variété de frameworks ML, vous pouvez donc utiliser celui qui vous convient le mieux.
FAQ
- Qu'est-ce que PoplarML ?
- PoplarML est une plateforme conçue pour simplifier le déploiement de modèles d'apprentissage automatique en production, prenant en charge plusieurs frameworks et offrant une inférence en temps réel.
- Comment utiliser PoplarML ?
- Inscrivez-vous sur leur site web, utilisez l'outil CLI pour déployer vos modèles, puis utilisez l'API REST pour obtenir des prédictions en temps réel.
- Quelles sont les principales fonctionnalités de PoplarML ?
- Déploiement transparent sur les GPU, inférence en temps réel via l'API REST et prise en charge de Tensorflow, Pytorch et JAX.
- Quels sont les cas d'utilisation de PoplarML ?
- Idéal pour déployer des modèles en production, faire évoluer des systèmes ML, permettre l'inférence en temps réel et prendre en charge divers frameworks ML.
Besoin d'aide ? Vous pouvez contacter le service clientèle de PoplarML à l'adresse [email protected]. Pour plus d'options de contact, consultez leur page Contactez-nous.
Restez informé des dernières actualités de PoplarML en les suivant sur Twitter.
Capture d'écran PoplarML - Deploy Models to Production


2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai


