


 Maison
M6 Intelligence et Tsinghua publient en open source BitCPM-CANN pour l'exécution de modèles de grande taille sur des appareils mobiles
MBLab, en collaboration avec l'université de Tsinghua et la communauté open source OpenBMB, a récemment publié et mis à disposition en open source une avancée majeure dans le domaine de l'entraînement de grands modèles à faible nombre de bits : BitCPM-CANN. Développée en natif sur la plateforme Ascend de Huawei, cette avancée majeure fait progresser l’allègement et le déploiement technique des grands modèles d’IA en périphérie.
Un gain de mémoire multiplié par six qui repousse les limites matérielles
BitCPM-CANN, désormais open source, est disponible en quatre tailles : 0,5B, 1B, 3B et 8B. En comparaison directe avec des modèles à pleine précision de taille équivalente, il offre des performances exceptionnelles. Par rapport à la précision BF16 conventionnelle, il permet de réaliser environ six fois plus d’économies de mémoire lors de l’inférence, réduisant ainsi considérablement le matériel nécessaire à l’exécution de grands modèles.
Pour les appareils mobiles, cet avantage de mémoire multiplié par six signifie que les grands modèles de 8 milliards de paramètres — qui nécessitaient auparavant du matériel haut de gamme — peuvent désormais fonctionner sans problème sur les smartphones phares grand public. Cette marge de mémoire remarquable accélère directement l’adoption et le déploiement commercial de la technologie d’IA en périphérie sur les plateformes mobiles.
Un taux de rétention élevé confirme la reproductibilité de l’ingénierie
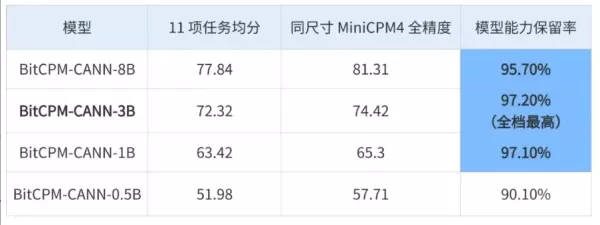
Malgré la réduction de la taille des modèles, BitCPM-CANN conserve des performances exceptionnellement élevées, avec des taux de rétention des capacités compris entre 90 % et 97,2 %. Pour les trois modèles les plus volumineux, les taux de rétention se situent entre 95,7 % et 97,2 %, tandis que même la plus petite variante (0,5 milliard de paramètres) dépasse les 90 %.
Ces résultats impressionnants démontrent de manière systématique que l’approche d’entraînement à faible nombre de bits offre une forte évolutivité et une reproductibilité technique. MBLab a établi une base complète pour l’entraînement à faible nombre de bits à l’aide de ces technologies clés, couvrant l’ensemble de la pile d’ingénierie — y compris l’adaptation à l’environnement, la prise en charge de longues séquences de 32K et les opérateurs fusionnés —, fournissant ainsi une infrastructure publique robuste pour les futurs travaux d’entraînement à faible nombre de bits sur la plateforme Ascend.
Article connexe
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc
Recommandations de sujets spéciaux liés
en écrivant
 Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
 8 outils
 xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

 commentaires (0)
MBLab, en collaboration avec l'université de Tsinghua et la communauté open source OpenBMB, a récemment publié et mis à disposition en open source une avancée majeure dans le domaine de l'entraînement de grands modèles à faible nombre de bits : BitCPM-CANN. Développée en natif sur la plateforme Ascend de Huawei, cette avancée majeure fait progresser l’allègement et le déploiement technique des grands modèles d’IA en périphérie.
Un gain de mémoire multiplié par six qui repousse les limites matérielles
BitCPM-CANN, désormais open source, est disponible en quatre tailles : 0,5B, 1B, 3B et 8B. En comparaison directe avec des modèles à pleine précision de taille équivalente, il offre des performances exceptionnelles. Par rapport à la précision BF16 conventionnelle, il permet de réaliser environ six fois plus d’économies de mémoire lors de l’inférence, réduisant ainsi considérablement le matériel nécessaire à l’exécution de grands modèles.
Pour les appareils mobiles, cet avantage de mémoire multiplié par six signifie que les grands modèles de 8 milliards de paramètres — qui nécessitaient auparavant du matériel haut de gamme — peuvent désormais fonctionner sans problème sur les smartphones phares grand public. Cette marge de mémoire remarquable accélère directement l’adoption et le déploiement commercial de la technologie d’IA en périphérie sur les plateformes mobiles.
Un taux de rétention élevé confirme la reproductibilité de l’ingénierie
Malgré la réduction de la taille des modèles, BitCPM-CANN conserve des performances exceptionnellement élevées, avec des taux de rétention des capacités compris entre 90 % et 97,2 %. Pour les trois modèles les plus volumineux, les taux de rétention se situent entre 95,7 % et 97,2 %, tandis que même la plus petite variante (0,5 milliard de paramètres) dépasse les 90 %.
Ces résultats impressionnants démontrent de manière systématique que l’approche d’entraînement à faible nombre de bits offre une forte évolutivité et une reproductibilité technique. MBLab a établi une base complète pour l’entraînement à faible nombre de bits à l’aide de ces technologies clés, couvrant l’ensemble de la pile d’ingénierie — y compris l’adaptation à l’environnement, la prise en charge de longues séquences de 32K et les opérateurs fusionnés —, fournissant ainsi une infrastructure publique robuste pour les futurs travaux d’entraînement à faible nombre de bits sur la plateforme Ascend.








 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
 Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai












