


 Maison
Google dévoile son modèle allégé Gemini 3.1, doté d'une interface utilisateur époustouflante
Google DeepMind a dévoilé sa dernière avancée en matière de vitesse dans le domaine de l'IA générative : Gemini 3.1 Flash-Lite. Ce modèle offre une efficacité de raisonnement exceptionnelle, permettant un rendu Web en temps quasi réel et faisant passer l'IA de l'interaction textuelle de base à la pointe du développement d'interfaces utilisateur dynamiques.
Gain de performance et compromis en termes de coûts
Les données officielles indiquent que Gemini 3.1 Flash-Lite réagit 2,5 fois plus vite que son prédécesseur, Gemini 2.5 Flash. Il atteint un débit remarquable, générant plus de 360 tokens par seconde. Lors d'évaluations de tâches multimodales menées par le cabinet indépendant Artificial Analysis, ce modèle léger a même surpassé des concurrents plus imposants tels que Claude Opus 4.6.
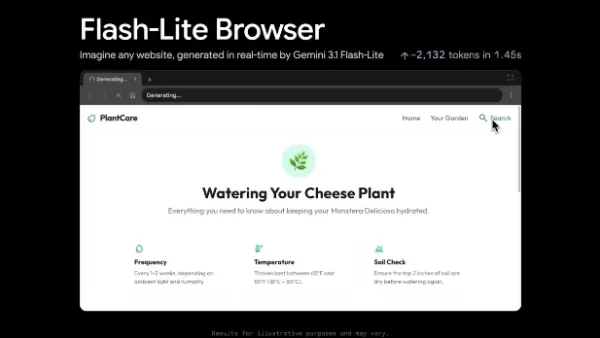
Cependant, cette amélioration de la vitesse s'accompagne d'une révision de la structure des coûts. Le prix de sortie du modèle est passé de 0,40 $ à 1,50 $ par million de tokens, reflétant le surcoût de calcul lié à une technologie haute performance et à faible latence.
Démonstration du « pseudo-navigateur » et scénarios d'application
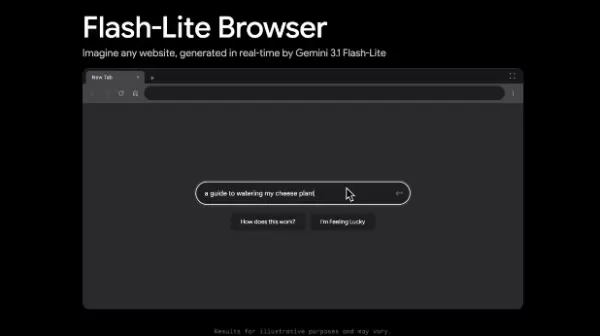
Parallèlement au modèle, Google a publié une application de démonstration « pseudo-navigateur ». Les utilisateurs peuvent fournir des instructions descriptives, et le système génère et affiche le contenu web correspondant en quelques millisecondes. Bien que la démo actuelle puisse présenter une certaine instabilité avec une logique complexe lors de sessions prolongées, elle démontre un potentiel significatif dans plusieurs domaines :
Prototypage rapide : visualisez instantanément des maquettes et des concepts d'interface utilisateur.
Interfaces interactives dynamiques : adaptation de la structure Web en fonction de l'intention de l'utilisateur en temps réel.
Tâches multimodales à faible latence : constitue une alternative efficace aux modèles plus lourds dans les scénarios exigeant un retour rapide.
Gemini 3.1 Flash-Lite est désormais disponible sur Google AI Studio et Vertex AI, où les utilisateurs peuvent découvrir les capacités de génération ultra-rapide.
Article connexe
 Purdue Robotics dévoile PuduFM 1.0 et PuduAgent, marquant le début d’une nouvelle ère de l’intelligence incarnée
Dans une ère définie par l’avancement rapide de l’intelligence artificielle et de la robotique, Pudu Robotics, leader mondial des robots de service commerciaux, a dévoilé deux avancées révolutionnaires en matière d’intelligence incarnée : PuduFM 1.0
Ensemble de puces Kunlun de Baidu pour une introduction en bourse à Hong Kong avec un objectif de valorisation de 50 milliards de dollars
Le 29 juin, les marchés de capitaux ont été ébranlés par une information majeure : la filiale de Baidu spécialisée dans les puces IA, Kunlun Tech, accélère son introduction en bourse à Hong Kong, visant une valorisation pouvant atteindre 50 milliards
Instinct lance un agent d'IA dans les conversations de groupe, y compris celles avec des non-utilisateurs
Instinct, l’agent d’intelligence artificielle dont la valorisation s’élève désormais à 10 milliards de dollars après son dernier tour de financement, s’étend aux conversations de groupe. La startup a annoncé lundi que les utilisateurs peuvent ajouter
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Google DeepMind a dévoilé sa dernière avancée en matière de vitesse dans le domaine de l'IA générative : Gemini 3.1 Flash-Lite. Ce modèle offre une efficacité de raisonnement exceptionnelle, permettant un rendu Web en temps quasi réel et faisant passer l'IA de l'interaction textuelle de base à la pointe du développement d'interfaces utilisateur dynamiques.
Gain de performance et compromis en termes de coûts
Les données officielles indiquent que Gemini 3.1 Flash-Lite réagit 2,5 fois plus vite que son prédécesseur, Gemini 2.5 Flash. Il atteint un débit remarquable, générant plus de 360 tokens par seconde. Lors d'évaluations de tâches multimodales menées par le cabinet indépendant Artificial Analysis, ce modèle léger a même surpassé des concurrents plus imposants tels que Claude Opus 4.6.
Cependant, cette amélioration de la vitesse s'accompagne d'une révision de la structure des coûts. Le prix de sortie du modèle est passé de 0,40 $ à 1,50 $ par million de tokens, reflétant le surcoût de calcul lié à une technologie haute performance et à faible latence.
Démonstration du « pseudo-navigateur » et scénarios d'application
Parallèlement au modèle, Google a publié une application de démonstration « pseudo-navigateur ». Les utilisateurs peuvent fournir des instructions descriptives, et le système génère et affiche le contenu web correspondant en quelques millisecondes. Bien que la démo actuelle puisse présenter une certaine instabilité avec une logique complexe lors de sessions prolongées, elle démontre un potentiel significatif dans plusieurs domaines :
Prototypage rapide : visualisez instantanément des maquettes et des concepts d'interface utilisateur.
Interfaces interactives dynamiques : adaptation de la structure Web en fonction de l'intention de l'utilisateur en temps réel.
Tâches multimodales à faible latence : constitue une alternative efficace aux modèles plus lourds dans les scénarios exigeant un retour rapide.
Gemini 3.1 Flash-Lite est désormais disponible sur Google AI Studio et Vertex AI, où les utilisateurs peuvent découvrir les capacités de génération ultra-rapide.








 Purdue Robotics dévoile PuduFM 1.0 et PuduAgent, marquant le début d’une nouvelle ère de l’intelligence incarnée
Dans une ère définie par l’avancement rapide de l’intelligence artificielle et de la robotique, Pudu Robotics, leader mondial des robots de service commerciaux, a dévoilé deux avancées révolutionnaires en matière d’intelligence incarnée : PuduFM 1.0
 Ensemble de puces Kunlun de Baidu pour une introduction en bourse à Hong Kong avec un objectif de valorisation de 50 milliards de dollars
Le 29 juin, les marchés de capitaux ont été ébranlés par une information majeure : la filiale de Baidu spécialisée dans les puces IA, Kunlun Tech, accélère son introduction en bourse à Hong Kong, visant une valorisation pouvant atteindre 50 milliards
 Instinct lance un agent d'IA dans les conversations de groupe, y compris celles avec des non-utilisateurs
Instinct, l’agent d’intelligence artificielle dont la valorisation s’élève désormais à 10 milliards de dollars après son dernier tour de financement, s’étend aux conversations de groupe. La startup a annoncé lundi que les utilisateurs peuvent ajouter

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












