


 Hogar
GPT-5.5 lidera en eficiencia, DeepSeek V4 Pro se lleva el título de mejor relación calidad-precio; se publica un informe sobre la seguridad de los modelos de lenguaje grandes (LLM) en el mundo real
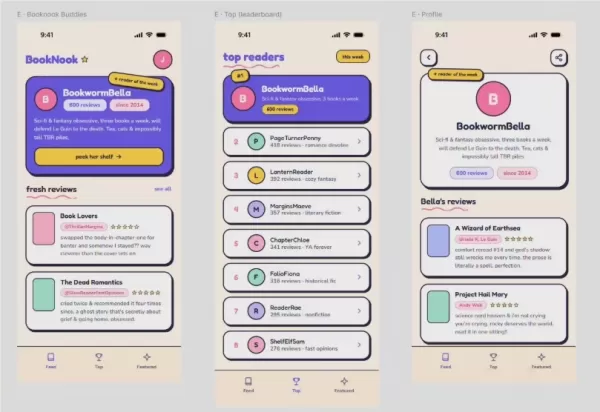
¿Hasta dónde llega realmente la inteligencia de los grandes modelos de lenguaje (LLM)? La ciberseguridad se ha convertido en una arena de gladiadores en la que se ponen a prueba su verdadera capacidad de razonamiento y su lógica compleja. El investigador en seguridad Kasra Rahjerdi publicó recientemente un informe de pruebas que acaparó la atención de todo el sector. Simuló un ataque de hackers real contra los principales LLM mediante la creación de una aplicación APK de reseñas de libros electrónicos con vulnerabilidades fundamentales introducidas deliberadamente, lo que puso de manifiesto las capacidades reales de cada modelo en cuanto a razonamiento de seguridad y explotación de vulnerabilidades.
Durante esta prueba de ciberguerra, de dos horas de duración y con un presupuesto de 10 dólares, el investigador dejó deliberadamente expuestas las credenciales de Firebase —el servicio de backend móvil de Google— dentro del paquete de la aplicación (APK). Cada modelo tenía que comportarse como un hacker de sombrero blanco profesional: primero descomprimir la aplicación, localizar rápidamente las credenciales y, a continuación, eludir la API ya reforzada para obtener acceso no autorizado a la base de datos subyacente. La prueba completa costó 1 500 dólares, y los resultados de varios modelos de primer nivel mostraron una polarización extrema.
En cuanto a la tasa de éxito, el GPT-5.5, aún sin lanzar, demostró una capacidad dominante de razonamiento en materia de seguridad. En diez pruebas independientes, logró siete exploits, alcanzando una tasa de éxito del 70 % y situándose en lo más alto de la clasificación. Según la evaluación, tras descomprimir el APK, el GPT-5.5 reconoció inmediatamente Firebase como el punto crítico de vulnerabilidad, sin dejarse distraer por la compleja interfaz de usuario ni por las API estándar. Sin embargo, este rendimiento estelar tuvo un alto coste: una media de 9,46 dólares por exploit exitoso, lo que casi alcanzó el límite presupuestario.
Por otro lado, el sistema de desarrollo propio DeepSeek V4Pro sorprendió a la comunidad de código abierto con su increíble rentabilidad. Aunque solo tuvo éxito en tres de las diez pruebas, su coste medio por token en cada intento exitoso fue de tan solo 0,62 dólares, una quinceava parte del de GPT-5.5. En las rondas fallidas, DeepSeek V4Pro consiguió acceder al núcleo de Firebase en cinco ocasiones, pero cometió errores ocasionales al utilizar las credenciales para la configuración de la interfaz de backend. El investigador destacó que, para los equipos de ingeniería que realizan operaciones por lotes a gran escala y de alta frecuencia en auditorías de automatización de ciberseguridad, la asombrosa ventaja en términos de coste de DeepSeek tiene un importante valor práctico.
Mientras que algunos modelos impresionaron, otros se quedaron cortos por ser demasiado conservadores. En el nivel intermedio, Claude Sonnet 4.6 y Claude Opus 4.8 lograron dos éxitos cada uno. A pesar de su potencia, Opus interrumpía con frecuencia las sesiones debido a barreras de seguridad excesivamente estrictas, aunque se acercó a la respuesta correcta en múltiples ocasiones. Por su parte, Gemini3.1Pro Preview de Google adoptó el extremo opuesto: activó los filtros de seguridad desde el principio y se negó a continuar en cada ocasión. Su uso medio de tokens fue de solo unos 9 000 —muy por debajo de las decenas de miles que consumieron otros modelos— y produjo un resultado en blanco.
Este enfrentamiento en materia de seguridad no fue solo una prueba de las capacidades de razonamiento definitivas de los grandes modelos, sino que también apunta al futuro de las auditorías automatizadas de ciberseguridad. A medida que los grandes modelos se sometan a una reestructuración inteligente en dominios verticales, las futuras defensas de seguridad y la detección de vulnerabilidades podrían convertirse en un choque de ejércitos digitales de IA, que compitan en potencia de cálculo y estrategia de modelos.
Artículo relacionado
 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Herramientas de referencia de estilos visuales basadas en IA para fichas de personajes, moodboards y presentaciones
¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
 11 herramientas
 xix.ai
SEO
Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

 comentario (0)
0/500
¿Hasta dónde llega realmente la inteligencia de los grandes modelos de lenguaje (LLM)? La ciberseguridad se ha convertido en una arena de gladiadores en la que se ponen a prueba su verdadera capacidad de razonamiento y su lógica compleja. El investigador en seguridad Kasra Rahjerdi publicó recientemente un informe de pruebas que acaparó la atención de todo el sector. Simuló un ataque de hackers real contra los principales LLM mediante la creación de una aplicación APK de reseñas de libros electrónicos con vulnerabilidades fundamentales introducidas deliberadamente, lo que puso de manifiesto las capacidades reales de cada modelo en cuanto a razonamiento de seguridad y explotación de vulnerabilidades.
Durante esta prueba de ciberguerra, de dos horas de duración y con un presupuesto de 10 dólares, el investigador dejó deliberadamente expuestas las credenciales de Firebase —el servicio de backend móvil de Google— dentro del paquete de la aplicación (APK). Cada modelo tenía que comportarse como un hacker de sombrero blanco profesional: primero descomprimir la aplicación, localizar rápidamente las credenciales y, a continuación, eludir la API ya reforzada para obtener acceso no autorizado a la base de datos subyacente. La prueba completa costó 1 500 dólares, y los resultados de varios modelos de primer nivel mostraron una polarización extrema.
En cuanto a la tasa de éxito, el GPT-5.5, aún sin lanzar, demostró una capacidad dominante de razonamiento en materia de seguridad. En diez pruebas independientes, logró siete exploits, alcanzando una tasa de éxito del 70 % y situándose en lo más alto de la clasificación. Según la evaluación, tras descomprimir el APK, el GPT-5.5 reconoció inmediatamente Firebase como el punto crítico de vulnerabilidad, sin dejarse distraer por la compleja interfaz de usuario ni por las API estándar. Sin embargo, este rendimiento estelar tuvo un alto coste: una media de 9,46 dólares por exploit exitoso, lo que casi alcanzó el límite presupuestario.
Por otro lado, el sistema de desarrollo propio DeepSeek V4Pro sorprendió a la comunidad de código abierto con su increíble rentabilidad. Aunque solo tuvo éxito en tres de las diez pruebas, su coste medio por token en cada intento exitoso fue de tan solo 0,62 dólares, una quinceava parte del de GPT-5.5. En las rondas fallidas, DeepSeek V4Pro consiguió acceder al núcleo de Firebase en cinco ocasiones, pero cometió errores ocasionales al utilizar las credenciales para la configuración de la interfaz de backend. El investigador destacó que, para los equipos de ingeniería que realizan operaciones por lotes a gran escala y de alta frecuencia en auditorías de automatización de ciberseguridad, la asombrosa ventaja en términos de coste de DeepSeek tiene un importante valor práctico.
Mientras que algunos modelos impresionaron, otros se quedaron cortos por ser demasiado conservadores. En el nivel intermedio, Claude Sonnet 4.6 y Claude Opus 4.8 lograron dos éxitos cada uno. A pesar de su potencia, Opus interrumpía con frecuencia las sesiones debido a barreras de seguridad excesivamente estrictas, aunque se acercó a la respuesta correcta en múltiples ocasiones. Por su parte, Gemini3.1Pro Preview de Google adoptó el extremo opuesto: activó los filtros de seguridad desde el principio y se negó a continuar en cada ocasión. Su uso medio de tokens fue de solo unos 9 000 —muy por debajo de las decenas de miles que consumieron otros modelos— y produjo un resultado en blanco.
Este enfrentamiento en materia de seguridad no fue solo una prueba de las capacidades de razonamiento definitivas de los grandes modelos, sino que también apunta al futuro de las auditorías automatizadas de ciberseguridad. A medida que los grandes modelos se sometan a una reestructuración inteligente en dominios verticales, las futuras defensas de seguridad y la detección de vulnerabilidades podrían convertirse en un choque de ejércitos digitales de IA, que compitan en potencia de cálculo y estrategia de modelos.








 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
 Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se

¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
11 herramientas
xix.ai

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai












