


 Hogar
El éxito de ventas «Reservation Ends Token Anxiety»: dibuja diagramas de flujo a mano con Gemma 4 de forma local en el navegador, gratis
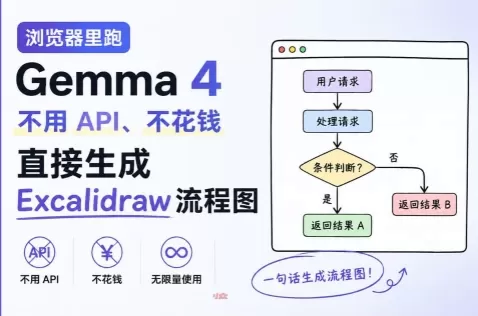
La ejecución de grandes modelos de lenguaje en dispositivos móviles no es nada nuevo, pero dotar a los navegadores de capacidades avanzadas de IA se está convirtiendo en una tendencia clave. Recientemente, los desarrolladores han integrado el modelo Gemma4 directamente en el navegador utilizando el último algoritmo TurboQuant de Google. Esto permite a los usuarios disfrutar de interacciones fluidas con la IA de forma local sin necesidad de configurar entornos API complejos ni pagar cuotas de suscripción.
Tecnología clave: la revolución de la memoria impulsada por TurboQuant
En el corazón de este avance se encuentra el algoritmo TurboQuant de Google, que se centra en optimizar el «banco de memoria temporal» de los modelos grandes: la caché KV (caché de clave-valor).
En las configuraciones convencionales, los datos de la caché crecen rápidamente durante conversaciones largas o tareas complejas, lo que provoca ralentizaciones del sistema. TurboQuant comprime estas entradas vectoriales hasta una sexta parte de su tamaño original y permite recuperarlas directamente desde el estado comprimido. Esta capacidad de «búsqueda sin descompresión» permite al modelo retener un contexto más amplio al tiempo que aumenta la eficiencia computacional.
Experiencia de prueba: generación de un diagrama de flujo profesional en 30 segundos
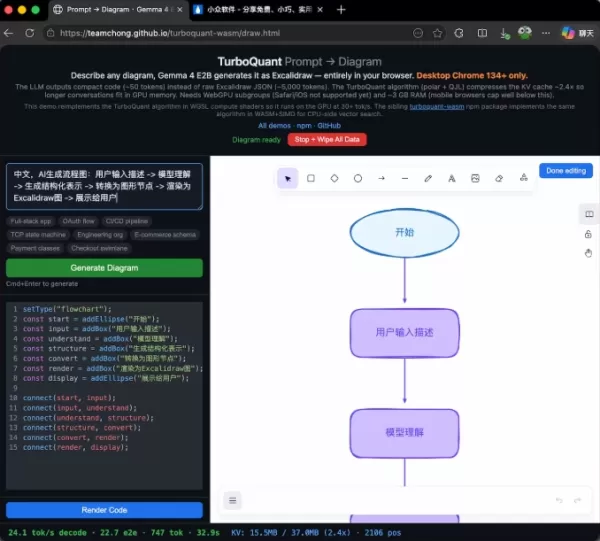
Por ejemplo, con una herramienta de integración local, los usuarios solo tienen que abrir una página web en un navegador de escritorio Chrome 134+ compatible con WebGPU para cargar el modelo Gemma4E2B.
En las pruebas, la generación de un diagrama de flujo completo de Excalidraw tardó unos 32,9 segundos. El modelo produce aproximadamente 24 tokens por segundo en el navegador, con una respuesta rápida de principio a fin. La ventaja clave: dado que todo el cálculo se realiza localmente en el dispositivo del usuario, no se utilizan tokens en línea, lo que permite una «creación de coste cero» auténtica.
Obstáculos y perspectivas: un nuevo paradigma para las aplicaciones de IA locales
Aunque ahora es posible un funcionamiento «sin tráfico», la ejecución local sigue enfrentándose a barreras de hardware. Los usuarios deben descargar aproximadamente 3,1 GB de archivos de modelo para el primer uso, y los requisitos de versión del navegador son específicos.
Esta solución, basada en WebAssembly (WASM) y TurboQuant, ofrece un modelo altamente replicable para aplicaciones ligeras de IA. Demuestra que, sin necesidad de costosa computación en la nube, los navegadores pueden gestionar la generación de diagramas de flujo complejos y el procesamiento de textos largos mediante la optimización algorítmica. Para los usuarios que valoran la privacidad y la rentabilidad, este modelo «listo para usar y ejecutado localmente» podría convertirse en la forma predominante de las futuras herramientas de IA.
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
SEO
 Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
 13 herramientas
 xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

 comentario (0)
0/500
La ejecución de grandes modelos de lenguaje en dispositivos móviles no es nada nuevo, pero dotar a los navegadores de capacidades avanzadas de IA se está convirtiendo en una tendencia clave. Recientemente, los desarrolladores han integrado el modelo Gemma4 directamente en el navegador utilizando el último algoritmo TurboQuant de Google. Esto permite a los usuarios disfrutar de interacciones fluidas con la IA de forma local sin necesidad de configurar entornos API complejos ni pagar cuotas de suscripción.
Tecnología clave: la revolución de la memoria impulsada por TurboQuant
En el corazón de este avance se encuentra el algoritmo TurboQuant de Google, que se centra en optimizar el «banco de memoria temporal» de los modelos grandes: la caché KV (caché de clave-valor).
En las configuraciones convencionales, los datos de la caché crecen rápidamente durante conversaciones largas o tareas complejas, lo que provoca ralentizaciones del sistema. TurboQuant comprime estas entradas vectoriales hasta una sexta parte de su tamaño original y permite recuperarlas directamente desde el estado comprimido. Esta capacidad de «búsqueda sin descompresión» permite al modelo retener un contexto más amplio al tiempo que aumenta la eficiencia computacional.
Experiencia de prueba: generación de un diagrama de flujo profesional en 30 segundos
Por ejemplo, con una herramienta de integración local, los usuarios solo tienen que abrir una página web en un navegador de escritorio Chrome 134+ compatible con WebGPU para cargar el modelo Gemma4E2B.
En las pruebas, la generación de un diagrama de flujo completo de Excalidraw tardó unos 32,9 segundos. El modelo produce aproximadamente 24 tokens por segundo en el navegador, con una respuesta rápida de principio a fin. La ventaja clave: dado que todo el cálculo se realiza localmente en el dispositivo del usuario, no se utilizan tokens en línea, lo que permite una «creación de coste cero» auténtica.
Obstáculos y perspectivas: un nuevo paradigma para las aplicaciones de IA locales
Aunque ahora es posible un funcionamiento «sin tráfico», la ejecución local sigue enfrentándose a barreras de hardware. Los usuarios deben descargar aproximadamente 3,1 GB de archivos de modelo para el primer uso, y los requisitos de versión del navegador son específicos.
Esta solución, basada en WebAssembly (WASM) y TurboQuant, ofrece un modelo altamente replicable para aplicaciones ligeras de IA. Demuestra que, sin necesidad de costosa computación en la nube, los navegadores pueden gestionar la generación de diagramas de flujo complejos y el procesamiento de textos largos mediante la optimización algorítmica. Para los usuarios que valoran la privacidad y la rentabilidad, este modelo «listo para usar y ejecutado localmente» podría convertirse en la forma predominante de las futuras herramientas de IA.








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai












