


 Hogar
Un equipo académico pone fin al monopolio de los gigantes tecnológicos con SFT; OpenSeeker-v2 encabeza la clasificación de agentes de búsqueda
En el panorama en constante evolución de los modelos de lenguaje a gran escala (LLM), las capacidades de búsqueda profunda se han convertido en la ventaja decisiva para los agentes inteligentes avanzados. Sin embargo, este ámbito ha estado controlado durante mucho tiempo por gigantes del sector que cuentan con una gran financiación. Los enfoques de desarrollo convencionales suelen depender de procesos que consumen muchos recursos y que abarcan el preentrenamiento, el preentrenamiento continuado (CPT), el ajuste fino supervisado (SFT) y el aprendizaje por refuerzo (RL).
Un equipo de investigadores académicos ha presentado recientemente su último trabajo, OpenSeeker-v2, que cuestiona de raíz esta visión establecida. Según su informe, el entrenamiento con trayectorias de tareas de alta calidad y gran dificultad permite que incluso un enfoque sencillo de ajuste fino supervisado (SFT) genere un agente de búsqueda de primer nivel.
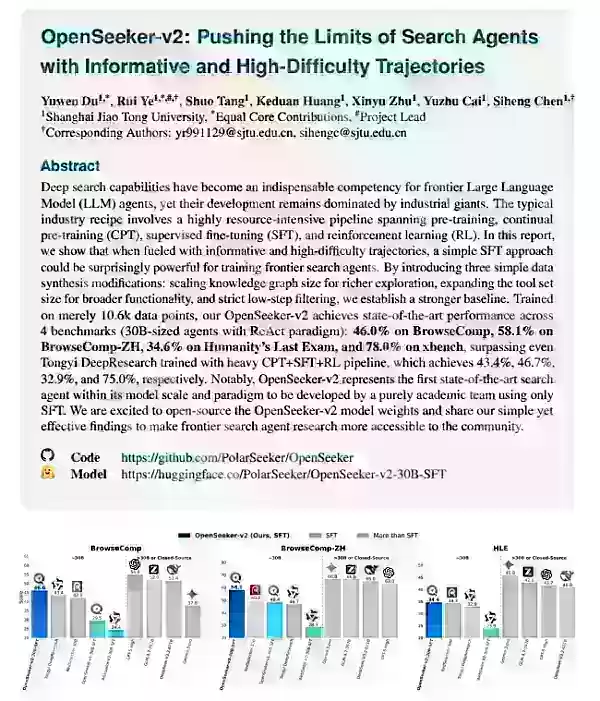
El equipo esbozó tres estrategias clave de optimización para la síntesis de datos: en primer lugar, ampliar el grafo de conocimiento para crear un espacio de exploración más amplio; en segundo lugar, ampliar sustancialmente el repertorio de herramientas para superar los límites funcionales; y, por último, aplicar un filtrado estricto de pasos reducidos para garantizar la calidad y la eficiencia de los datos de entrenamiento.
Los resultados experimentales revelan que OpenSeeker-v2 (con 30 000 millones de parámetros y una arquitectura ReAct), entrenado con tan solo 10 600 puntos de datos, mostró un rendimiento sobresaliente en cuatro pruebas de referencia fundamentales: obtuvo una puntuación del 46,0 % en BrowseComp, del 58,1 % en BrowseComp-ZH, un 34,6 % en «Humanity’s Last Exam» y un 78,0 % en xbench. Estas cifras no solo establecen nuevos récords, sino que también superan ampliamente a los modelos del sector que se basaban en complejas cadenas de procesamiento que combinaban CPT, SFT y RL —como Tongyi DeepResearch—.
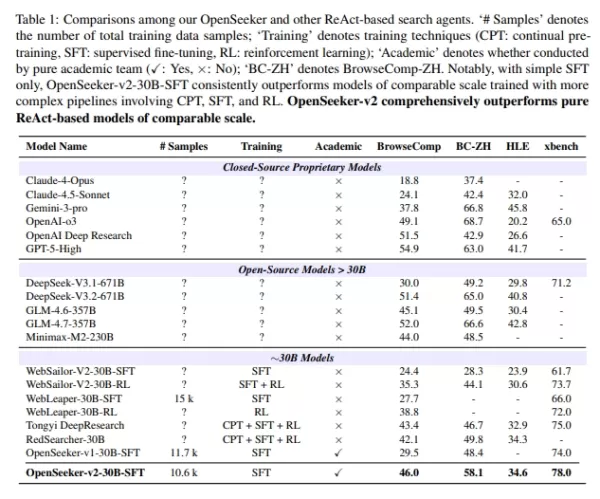
Sorprendentemente, se trata del primer agente de búsqueda de vanguardia (SOTA) desarrollado por un equipo íntegramente académico utilizando únicamente SFT, con la misma escala y arquitectura de modelo. El equipo ha publicado ahora en código abierto los pesos del modelo de OpenSeeker-v2. Este avance reduce significativamente las barreras de I+D para los agentes de búsqueda avanzados y ofrece una vía de desarrollo más accesible y ligera tanto para la comunidad académica como para la de código abierto.
Artículo: https://arxiv.org/pdf/2605.04036
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
SEO
 Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
 13 herramientas
 xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

 comentario (0)
0/500
En el panorama en constante evolución de los modelos de lenguaje a gran escala (LLM), las capacidades de búsqueda profunda se han convertido en la ventaja decisiva para los agentes inteligentes avanzados. Sin embargo, este ámbito ha estado controlado durante mucho tiempo por gigantes del sector que cuentan con una gran financiación. Los enfoques de desarrollo convencionales suelen depender de procesos que consumen muchos recursos y que abarcan el preentrenamiento, el preentrenamiento continuado (CPT), el ajuste fino supervisado (SFT) y el aprendizaje por refuerzo (RL).
Un equipo de investigadores académicos ha presentado recientemente su último trabajo, OpenSeeker-v2, que cuestiona de raíz esta visión establecida. Según su informe, el entrenamiento con trayectorias de tareas de alta calidad y gran dificultad permite que incluso un enfoque sencillo de ajuste fino supervisado (SFT) genere un agente de búsqueda de primer nivel.
El equipo esbozó tres estrategias clave de optimización para la síntesis de datos: en primer lugar, ampliar el grafo de conocimiento para crear un espacio de exploración más amplio; en segundo lugar, ampliar sustancialmente el repertorio de herramientas para superar los límites funcionales; y, por último, aplicar un filtrado estricto de pasos reducidos para garantizar la calidad y la eficiencia de los datos de entrenamiento.
Los resultados experimentales revelan que OpenSeeker-v2 (con 30 000 millones de parámetros y una arquitectura ReAct), entrenado con tan solo 10 600 puntos de datos, mostró un rendimiento sobresaliente en cuatro pruebas de referencia fundamentales: obtuvo una puntuación del 46,0 % en BrowseComp, del 58,1 % en BrowseComp-ZH, un 34,6 % en «Humanity’s Last Exam» y un 78,0 % en xbench. Estas cifras no solo establecen nuevos récords, sino que también superan ampliamente a los modelos del sector que se basaban en complejas cadenas de procesamiento que combinaban CPT, SFT y RL —como Tongyi DeepResearch—.
Sorprendentemente, se trata del primer agente de búsqueda de vanguardia (SOTA) desarrollado por un equipo íntegramente académico utilizando únicamente SFT, con la misma escala y arquitectura de modelo. El equipo ha publicado ahora en código abierto los pesos del modelo de OpenSeeker-v2. Este avance reduce significativamente las barreras de I+D para los agentes de búsqueda avanzados y ofrece una vía de desarrollo más accesible y ligera tanto para la comunidad académica como para la de código abierto.
Artículo: https://arxiv.org/pdf/2605.04036








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai












