


 Heim
Xunfei Xinghuo X2-Flash kommt mit verbesserter Rechenleistung und Unterstützung für 256 KB lange Texte auf den Markt
Am 29. April stellte iFLYTEK offiziell das neue Modell „Spark X2-Flash“ vor und öffnete dessen API-Schnittstelle. Damit wurde ein neuer Meilenstein in Sachen Effizienz für Anwendungen mit großen Modellen gesetzt, die auf dem heimischen Rechenleistungs-Ökosystem basieren.
Das Modell nutzt die derzeit gängige MoE-Architektur (Mixture of Experts) mit insgesamt 30 Milliarden Parametern. Sein herausragendes Merkmal ist die Unterstützung eines extrem langen Kontexts von bis zu 256K. Bemerkenswert ist, dass das Spark X2-Flash vollständig auf dem Ascend 910B-Cluster von Huawei trainiert wurde, was die Synergie von inländischer Software und Hardware für das Deep-Learning-Training demonstriert.
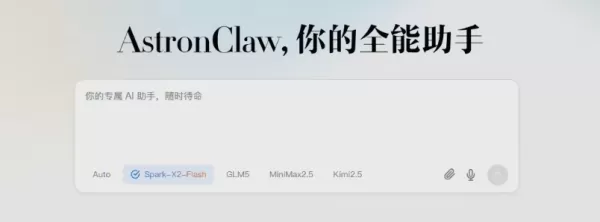
In Bezug auf die Kernleistung bietet das Spark X2-Flash erhebliche Verbesserungen bei den Fähigkeiten zur Agenten- und Codegenerierung. Tests von Drittanbietern zeigen, dass seine Leistung bei komplexen Aufgaben – wie der Verarbeitung tiefgreifender Forschungsberichte, der Verwaltung und dem Aufruf von Fähigkeiten sowie der Ausführung von Systemsteuerung – das Niveau von Spitzenmodellen der Branche mit Billionen von Parametern erreicht hat.
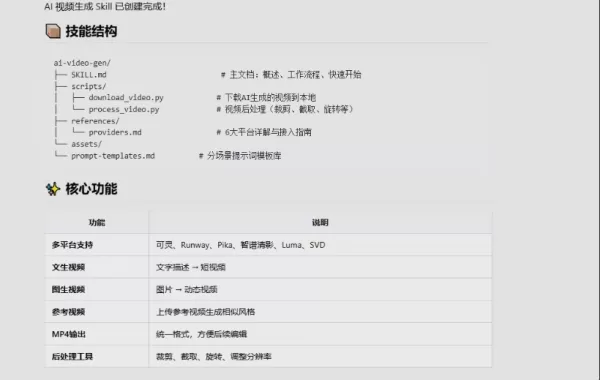
Auch in Bezug auf die Kosten, die für Entwickler von Bedeutung sind, überzeugt das Spark X2-Flash. In identischen Workflow-Tests beträgt sein Token-Verbrauch nur ein Drittel des Verbrauchs aktueller gängiger großer Modelle, was die Hürde für die Entwicklung komplexer Agentenanwendungen erheblich senkt. Beispielsweise erfasst das Modell bei der Erstellung komplexer Fähigkeiten zur Videogenerierung nicht nur schnell die Anforderungen, sondern bietet auch detaillierte Erklärungen, die von der Skill-Struktur bis hin zu den Kernfunktionen reichen.
Technisch gesehen ist das Spark X2-Flash das erste Modell, das DSA (Sparse Attention) und MTP (Multi-Token Prediction) auf heimischen Chips kombiniert. Diese Innovation löst das Problem des langsamen Trainings langer Texte auf heimischen Rechenplattformen und steigert die Trainingseffizienz im Vergleich zu Clustern ähnlicher Größe um das 4,5-Fache. Darüber hinaus verbessert das Modell bei Szenarien des agentenbasierten verstärkenden Lernens die Effizienz der Sampling-Inferenz durch kombinierte algorithmische und technische Optimierungen um mehr als das Doppelte und beseitigt so effektiv Leistungsengpässe in Szenarien mit langen Interaktionen.
Derzeit haben Anwendungen wie AstronClaw und Loomy die Integration als erste abgeschlossen. Das Modell ist zudem eng auf internationale Mainstream-Agenten-Frameworks wie OpenClaw und Claude Code abgestimmt und bietet Entwicklern weltweit eine kostengünstigere Option für inländische Rechenleistung.
Verwandter Artikel
 ByteDances Seed startet globale Campus-Werbung und bietet virtuelle Aktien, um Top-Talente für große Modelle zu gewinnen
Im wettbewerbsintensiven Umfeld der großen Sprachmodelle bleibt die Sicherung erstklassiger Talente das wichtigste strategische Asset.Am 1. April ByteDance gab die Einführung seiner globalen Campus-Rekrutierungsinitiative Seed bekannt, die Teil seine
Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 KI-basierte Tools zur Referenzierung visueller Stile für Charakterbeschreibungen, Moodboards und Pitch-Präsentationen
Die besten KI-Tools für visuelle Stile im Jahr 2026 – für Charakterbögen, Moodboards und Pitch-Decks – finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings sowie Optionen, die Sie unbedingt ausprobieren sollten, um Ihre Kreativität zu steigern und Ihren Arbeitsablauf zu optimieren. Stöbern Sie jetzt und entdecken Sie das perfekte Tool zur Steigerung Ihrer Produktivität!
 11 Tools
 xix.ai
SEO
Die besten KI-Tools zur SERP-Analyse für die Suchstrategie
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai
Datenanalyse
Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

 Kommentare (0)
Am 29. April stellte iFLYTEK offiziell das neue Modell „Spark X2-Flash“ vor und öffnete dessen API-Schnittstelle. Damit wurde ein neuer Meilenstein in Sachen Effizienz für Anwendungen mit großen Modellen gesetzt, die auf dem heimischen Rechenleistungs-Ökosystem basieren.
Das Modell nutzt die derzeit gängige MoE-Architektur (Mixture of Experts) mit insgesamt 30 Milliarden Parametern. Sein herausragendes Merkmal ist die Unterstützung eines extrem langen Kontexts von bis zu 256K. Bemerkenswert ist, dass das Spark X2-Flash vollständig auf dem Ascend 910B-Cluster von Huawei trainiert wurde, was die Synergie von inländischer Software und Hardware für das Deep-Learning-Training demonstriert.
In Bezug auf die Kernleistung bietet das Spark X2-Flash erhebliche Verbesserungen bei den Fähigkeiten zur Agenten- und Codegenerierung. Tests von Drittanbietern zeigen, dass seine Leistung bei komplexen Aufgaben – wie der Verarbeitung tiefgreifender Forschungsberichte, der Verwaltung und dem Aufruf von Fähigkeiten sowie der Ausführung von Systemsteuerung – das Niveau von Spitzenmodellen der Branche mit Billionen von Parametern erreicht hat.
Auch in Bezug auf die Kosten, die für Entwickler von Bedeutung sind, überzeugt das Spark X2-Flash. In identischen Workflow-Tests beträgt sein Token-Verbrauch nur ein Drittel des Verbrauchs aktueller gängiger großer Modelle, was die Hürde für die Entwicklung komplexer Agentenanwendungen erheblich senkt. Beispielsweise erfasst das Modell bei der Erstellung komplexer Fähigkeiten zur Videogenerierung nicht nur schnell die Anforderungen, sondern bietet auch detaillierte Erklärungen, die von der Skill-Struktur bis hin zu den Kernfunktionen reichen.
Technisch gesehen ist das Spark X2-Flash das erste Modell, das DSA (Sparse Attention) und MTP (Multi-Token Prediction) auf heimischen Chips kombiniert. Diese Innovation löst das Problem des langsamen Trainings langer Texte auf heimischen Rechenplattformen und steigert die Trainingseffizienz im Vergleich zu Clustern ähnlicher Größe um das 4,5-Fache. Darüber hinaus verbessert das Modell bei Szenarien des agentenbasierten verstärkenden Lernens die Effizienz der Sampling-Inferenz durch kombinierte algorithmische und technische Optimierungen um mehr als das Doppelte und beseitigt so effektiv Leistungsengpässe in Szenarien mit langen Interaktionen.
Derzeit haben Anwendungen wie AstronClaw und Loomy die Integration als erste abgeschlossen. Das Modell ist zudem eng auf internationale Mainstream-Agenten-Frameworks wie OpenClaw und Claude Code abgestimmt und bietet Entwicklern weltweit eine kostengünstigere Option für inländische Rechenleistung.








 ByteDances Seed startet globale Campus-Werbung und bietet virtuelle Aktien, um Top-Talente für große Modelle zu gewinnen
Im wettbewerbsintensiven Umfeld der großen Sprachmodelle bleibt die Sicherung erstklassiger Talente das wichtigste strategische Asset.Am 1. April ByteDance gab die Einführung seiner globalen Campus-Rekrutierungsinitiative Seed bekannt, die Teil seine
 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
 Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc

Die besten KI-Tools für visuelle Stile im Jahr 2026 – für Charakterbögen, Moodboards und Pitch-Decks – finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings sowie Optionen, die Sie unbedingt ausprobieren sollten, um Ihre Kreativität zu steigern und Ihren Arbeitsablauf zu optimieren. Stöbern Sie jetzt und entdecken Sie das perfekte Tool zur Steigerung Ihrer Produktivität!
11 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai












