


 Heim
xAI stellt Grok 4.20 mit verbesserter Schlussfolgerungsfähigkeit und einer Halluzinationskontrolle vor, die alle bisherigen Rekorde bricht
Am 12. März 2026 veröffentlichte xAI offiziell sein großes Sprachmodell der nächsten Generation, Grok 4.20 Beta , das einen neuen Branchenstandard für außergewöhnliche sachliche Zuverlässigkeit gesetzt hat und dabei preislich wettbewerbsfähig bleibt.
Laut der neuesten Bewertung von Artificial Analysis erreichte Grok 4.20 bei Denkaufgaben einen Intelligence-Index-Wert von 48 Punkten, was eine Verbesserung um 6 Punkte gegenüber dem Vorgängermodell darstellt. Zwar liegt es in der Gesamt-Benchmark-Leistung noch hinter Gemini 3.1 Pro Preview und GPT-5.4 (beide mit 57 Punkten), doch waren seine Ergebnisse im AA Omniscient-Test herausragend und wiesen eine Nicht-Halluzinationsrate von bis zu 78 % auf. Damit wird das häufige Problem, dass KI-Modelle falsche Informationen generieren, wirksam angegangen.
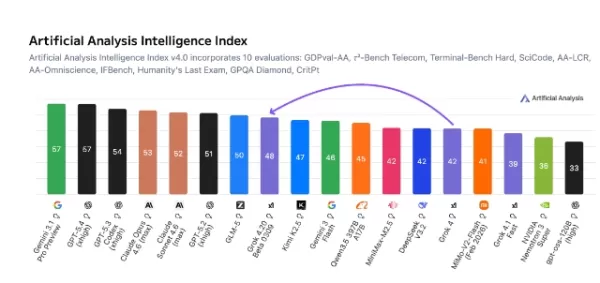
Was die Produktpalette und die technischen Spezifikationen betrifft, hat xAI gleichzeitig drei API-Versionen auf den Markt gebracht: eine mit Schlussfolgerungsfähigkeiten, eine ohne und eine weitere, die für den Multi-Agenten-Betrieb ausgelegt ist. Das Modell unterstützt ein Kontextfenster von bis zu 2 Millionen Token und verfolgt eine äußerst wettbewerbsfähige Preisstrategie mit Kosten zwischen 2 und 6 US-Dollar pro Million Token – deutlich niedriger als beim Vorgänger Grok 4. Technisch gesehen zeigt Grok 4.20 in unbekanntem Terrain große Zurückhaltung und neigt deutlich häufiger dazu, „Ich weiß es nicht“ zuzugeben, wobei die Fehlerquote bei etwa einem Fünftel liegt.
Der globale Wettbewerb unter großen KI-Modellen hat sich mittlerweile von einem reinen Fokus auf die Größe zu einem doppelten Wettstreit um die Tiefe der Schlussfolgerungen und die faktische Genauigkeit entwickelt. Die Einführung von Grok 4.20 unterstreicht die Strategie von xAI, einen deutlichen Wettbewerbsvorteil aufzubauen, indem „Ehrlichkeit“ und eine „niedrige Halluzinationsrate“ bei der Verfolgung der Allgemeinen Künstlichen Intelligenz (AGI) priorisiert werden. Dieses extreme Bekenntnis zur sachlichen Zuverlässigkeit verbessert nicht nur den praktischen Nutzen der KI in anspruchsvollen Branchen, sondern schafft auch eine vertrauenswürdigere Grundlage für die Informationsintegrität in zukünftigen Multi-Agenten-Systemen.
Verwandter Artikel
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
Empfehlungen zu verwandten Spezialthemen
Schreiben
 Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (1)
![NicholasLee]()
Grok 4.20 Beta 這次在幻覺控制上好像真的進步了?看簡介說設了新標準,有點期待實際用起來是不是真的那麼可靠。價格有競爭力是好事,但希望別像有些模型,一更新舊功能反而變差。🤔
Am 12. März 2026 veröffentlichte xAI offiziell sein großes Sprachmodell der nächsten Generation,
Laut der neuesten Bewertung von
Was die Produktpalette und die technischen Spezifikationen betrifft, hat xAI gleichzeitig drei API-Versionen auf den Markt gebracht: eine mit Schlussfolgerungsfähigkeiten, eine ohne und eine weitere, die für den Multi-Agenten-Betrieb ausgelegt ist. Das Modell unterstützt ein Kontextfenster von bis zu 2 Millionen Token und verfolgt eine äußerst wettbewerbsfähige Preisstrategie mit Kosten zwischen 2 und 6 US-Dollar pro Million Token – deutlich niedriger als beim Vorgänger Grok 4. Technisch gesehen zeigt Grok 4.20 in unbekanntem Terrain große Zurückhaltung und neigt deutlich häufiger dazu, „Ich weiß es nicht“ zuzugeben, wobei die Fehlerquote bei etwa einem Fünftel liegt.
Der globale Wettbewerb unter großen KI-Modellen hat sich mittlerweile von einem reinen Fokus auf die Größe zu einem doppelten Wettstreit um die Tiefe der Schlussfolgerungen und die faktische Genauigkeit entwickelt. Die Einführung von Grok 4.20 unterstreicht die Strategie von xAI, einen deutlichen Wettbewerbsvorteil aufzubauen, indem „Ehrlichkeit“ und eine „niedrige Halluzinationsrate“ bei der Verfolgung der Allgemeinen Künstlichen Intelligenz (AGI) priorisiert werden. Dieses extreme Bekenntnis zur sachlichen Zuverlässigkeit verbessert nicht nur den praktischen Nutzen der KI in anspruchsvollen Branchen, sondern schafft auch eine vertrauenswürdigere Grundlage für die Informationsintegrität in zukünftigen Multi-Agenten-Systemen.








 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

Grok 4.20 Beta 這次在幻覺控制上好像真的進步了?看簡介說設了新標準,有點期待實際用起來是不是真的那麼可靠。價格有競爭力是好事,但希望別像有些模型,一更新舊功能反而變差。🤔












