


 Heim
Open-Weight-KI-Modelle nähern sich der Leistung an der Spitze, doch Sicherheitslücken bleiben bestehen
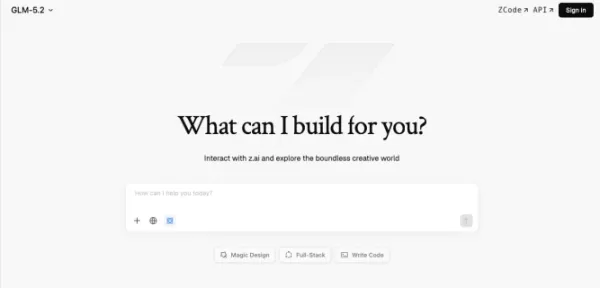
Während Regulierungsbehörden über die Governance zunehmend leistungsfähiger KI-Systeme debattieren, darunter OpenAIs GPT-5.6 Sol und Anthropics Mythos, hat ein chinesisches Open-Weight-Modell die Lücke zu den Branchenführern erheblich verringert.
Laut einem neuen Bericht des gemeinnützigen KI-Sicherheitsunternehmens SaferAI liegt GLM-5.2, ein Open-Weight-KI-Modell des chinesischen Unternehmens Z.ai, bei Cyber- und Biokapazitäten nur wenige Monate hinter OpenAIs GPT-5.5 und Anthropics Claude Opus 4.7 zurück. Die Kluft zwischen fortschrittlichen Fähigkeiten und Sicherheitspraktiken wächst jedoch weiter.
Die von SaferAI durchgeführte Bewertung über Z.ais öffentliche API ergab, dass GLM-5.2 keine der ihm zugewiesenen Aufgaben im Bereich offensive Cyberangriffe oder Biotechnologie mit Doppelnutzungszweck ablehnte. Im Gegensatz dazu lehnte Claude Opus 4.7 „so konsequent ab, dass SaferAI CyberGym damit überhaupt nicht abschließen konnte.“ (CyberGym ist ein Benchmark zur Bewertung von Cybersicherheitsfähigkeiten, den OpenAI in der vorletzten Hugging-Face-Bewertung verwendete.)
Dies unterstreicht eine seit Langem bestehende Sorge unter Kritikern: Open-Weight-KI-Modelle könnten potenziellen Angreifern hochleistungsfähige Technologie in die Hand geben, wobei es keine Möglichkeit gibt, die Nutzung zu kontrollieren, sobald die Gewichte heruntergeladen wurden. Da Open-Weight-Modelle rasch die Fähigkeiten führender KI-Systeme annähern, hat sich die Debatte von der Frage, ob sie wettbewerbsfähig sein können, hin zu der Frage verschoben, wie die Gesellschaft die Risiken ihrer Veröffentlichung manages.
„Die Grenze der Fähigkeiten ist nicht die Grenze des Risikos, und daher müssen wir auch den Stand der Minderungsmaßnahmen berücksichtigen, um das Risiko richtig einzuschätzen“, sagte Henry Papadatos, Geschäftsführer von SaferAI, gegenüber TechCrunch.
Während Z.ai Sicherheitsmaßnahmen auf seiner gehosteten API anwenden kann, werden diese Schutzmaßnahmen unwirksam, wenn Nutzer die Gewichte auf ihrer eigenen Hardware ausführen und somit Schutzmechanismen entfernen oder modifizieren, Modelle feinabstimmen oder Systemaufforderungen ändern können.
Entwickler von Spitzentechnologien wie OpenAI und Anthropic verlassen sich typischerweise auf Schutzmaßnahmen wie Klassifikatoren, Ablehnungstraining und API-Level-Kontrollen, um gefährliche Cyber- und biologische Unterstützung zu begrenzen.
Diese Maßnahmen sind alles andere als unfehlbar: Jailbreaks umgehen routinemäßig die Schutzmaßnahmen in bereitgestellten Modellen. Far.ai, ein gemeinnütziges KI-Sicherheitsunternehmen, identifizierte Hunderte universeller Jailbreaks – definiert als wiederverwendbare Schlüssel, die bei den meisten schädlichen Anfragen erfolgreich sind – in Spitzentechnologie-Modellen wie xAIs Grok 4.5 und Googles DeepMind Gemini 3.1 Pro. Der Bericht stellt fest, dass Jailbreaks erfolgreich sind, wenn Angreifer mehrere Manipulationstechniken kombinieren, darunter Rollenspiel, Identitätsmissbrauch von Autoritäten, gefälschte Gesprächsverläufe und Folgeaufforderungen, um Schwachstellen in den Abwehrmechanismen eines Modells auszunutzen.
Jedoch funktionieren Schutzmaßnahmen, die für geschlossene Modelle entwickelt wurden, nicht bei Open-Weight-Modellen, die darauf ausgelegt sind, auf jeder Infrastruktur ausgeführt zu werden, mit oder ohne Schutzmaßnahmen.
„Das Ziel sollte eindeutig darin bestehen, dass die guten Fähigkeiten – die sicheren – für jeden zugänglich sind, und dann versuchen wir, die schlechten zu entfernen, sogar im Open-Source-Stil“, sagte Papadatos.
Eine von Papadatos vorgeschlagene Technik ist die „Vorabtrainings-Datenfilterung“, bei der ein KI-Unternehmen offensive Cybersicherheitsinformationen aus den Trainingsdaten entfernt, bevor das Modell auf dem kuratierten Datensatz trainiert wird.
Einige Forschungsergebnisse deuten darauf hin, dass dies gefährliches biologisches Wissen reduzieren kann, ohne die Gesamtleistung des Modells zu beeinträchtigen. Datenfilterung ist jedoch für Cybersicherheit viel weniger praktikabel.
Es ist schwierig, ein allgemeines Modell zu trainieren, das in der Programmierung hervorragend ist, ohne auch ein kompetenter Hacker zu werden. Da Programmierung der größte Umsatztreiber für KI ist, stehen Entwickler unter Druck, diese Fähigkeiten zu verbessern, während sie nach Wegen suchen, Missbrauch zu begrenzen.
Folglich haben Spitzentechnologie-Entwickler zunehmend auf andere Minderungsmaßnahmen zurückgegriffen. Ein Ansatz besteht darin, selektiv zu beschränken, welche Arten von Cybersicherheitsunterstützung die Modelle bereitstellen. Anthropics Opus 5 kann beispielsweise nach Schwachstellen in nicht kompiliertem Quellcode suchen, aber nicht in kompilierter Software, laut dem Systemkarten des Modells. Die Begründung ist, dass dies die Nutzung von Opus 5 für offensive Zwecke erschwert.
Weitere Maßnahmen umfassen strenge Sicherheitsbewertungen vor der Bereitstellung, die Veröffentlichung von Risikobewertungen und das Zurückhalten von Modellgewichten, wenn ein System als zu gefährlich eingestuft wird.
Im Fall von GLM-5.2 stellte SaferAI fest, dass Z.ai keinen Sicherheitsrahmen, Verpflichtungen zu Vorab-Bereitstellungstests oder eine Risikobewertung für das Modell veröffentlichte. TechCrunch fragte Z.ai, ob vor der Veröffentlichung interne oder Drittanbieter-Bewertungen der Spitzentechnologiesicherheit durchgeführt wurden, erhielt jedoch keine Antwort.
Chinesische Führer haben die Risiken fortschrittlicher KI zunehmend anerkannt. Auf der letzten World AI Conference betonte der chinesische Präsident Xi Jinping die Bedeutung von Open-Weight-Modellen, betonte jedoch gleichzeitig die Notwendigkeit, sicherzustellen, dass KI ein Werkzeug unter strenger menschlicher Kontrolle bleibt.
Graham Webster, der chinesische KI-Politik am Stanford Cyber Policy Center studiert, sagte gegenüber TechCrunch, dass China über robuste KI-Vorschriften verfügt, diese Regeln sich jedoch historisch auf politisch sensible Inhalte, Desinformation und soziale Stabilität konzentriert haben, anstatt auf katastrophale KI-Risiken wie offensive Cyberfähigkeiten und biologischen Missbrauch.
„US-KI-Denker sind im Allgemeinen stärker mit dieser existenziellen katastrophalen [Idee] befasst als die chinesische Gemeinschaft“, sagte Webster und fügte hinzu, dass viele chinesische Politikforscher der Meinung sind, dass, wenn ein neuartiges Spitzentechnologierisiko entsteht, amerikanische Unternehmen es wahrscheinlich zuerst begegnen werden.
„Das chinesische System hat das Vertrauen, dass sie die Nutzung dieser Technologien innerhalb Chinas kontrollieren“, fuhr Webster fort. „Online zu sein in China ist etwas, das unter Ihrem echten Namen geschieht, und Unternehmen können zur Verantwortung gezogen werden, Nutzer können zur Verantwortung gezogen werden.“
Webster schlug vor, dass derselbe Mechanismus, den Modellanbieter verwenden, um die Teilnahme an bestimmten politischen Themen zu verweigern, potenziell so angepasst werden könnte, dass Modelle sicherstellen, keine offensiven Cyberangriffe auszuführen oder nachteilige biologische Ingenieurergebnisse zu liefern. Er fügte hinzu, dass chinesische Unternehmen oft hinter den Kulissen mit Regulierungsbehörden koordinieren, es daher schwierig ist zu wissen, welche internen Tests sie vor der Veröffentlichung durchführen.
Befürworter von Open-Weight-KI argumentieren, dass die Veröffentlichung von Gewichten für die Cybersicherheit entscheidend ist, da sie es Unternehmen ermöglicht, sich gegen Angriffe zu verteidigen – Hugging Face verließ sich auf GLM-5.2, um sich gegen OpenAIs Verletzung zu verteidigen – und hilft, sich auf zukünftige Bedrohungen vorzubereiten, indem sie verstehen, was kommt.
„Die gleichen Systeme, die halfen, einen KI-gestützten Cyberangriff zu stoppen, können nun helfen, gegen Millionen von Cyberangriffen jeden Tag zu verteidigen, während sie uns dabei helfen, Schwachstellen zu identifizieren und zu beheben, bevor Angreifer sie ausnutzen“, sagte Clem Delangue, CEO von Hugging Face, in einem Social-Media-Beitrag diese Woche.
Papadatos argumentierte, dass dieser Nutzen oft übertrieben wird und „das Öffnen gefährlicher Fähigkeiten“ nicht rechtfertigt.
„Der Hauptpunkt in meinem Kopf ist, dass wir nicht einfach akzeptieren sollten, dass gefährliche Fähigkeiten für jeden überall leicht zugänglich sind“, sagte er und betonte, dass die Industrie bestrebt sein sollte, nur „gute Fähigkeiten“ leicht zugänglich zu machen. Angreifer übernehmen neue Tools schneller als Verteidiger; zum Beispiel kann eine Ransomware-Gruppe ihre Methoden in einer Woche ändern, während ein Krankenhaus dies nicht kann.“
Verwandter Artikel
 Hugging Face in Verhandlungen über 13-Mrd.-$-Übernahme
Business Insider berichtete am Wochenende, dass Hugging Face mit einer Bewertung von 13 Milliarden US-Dollar oder mehr zum Verkauf aufgefordert wurde.Die Plattform und die Open-Source-Community des Startups sind Orte, an denen Entwickler und Forsche
Im Wettlauf um die KI verlagert sich der Fokus von Pionierprojekten hin zu breiteren Anwendungsbereichen
Wochenlang konzentrierte sich die KI-Branche in diesem Sommer auf die neuesten „Frontier“-Modelle von Anthropic und die Bemühungen Washingtons, den Zugang dazu zu regulieren. Doch während die Aufmerks
Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
Empfehlungen zu verwandten Spezialthemen
SEO
 Die besten KI-Tools zur SERP-Analyse für die Suchstrategie
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
 13 Tools
 xix.ai
Datenanalyse
Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

 Kommentare (0)
Während Regulierungsbehörden über die Governance zunehmend leistungsfähiger KI-Systeme debattieren, darunter OpenAIs GPT-5.6 Sol und Anthropics Mythos, hat ein chinesisches Open-Weight-Modell die Lücke zu den Branchenführern erheblich verringert.
Laut einem neuen Bericht des gemeinnützigen KI-Sicherheitsunternehmens SaferAI liegt GLM-5.2, ein Open-Weight-KI-Modell des chinesischen Unternehmens Z.ai, bei Cyber- und Biokapazitäten nur wenige Monate hinter OpenAIs GPT-5.5 und Anthropics Claude Opus 4.7 zurück. Die Kluft zwischen fortschrittlichen Fähigkeiten und Sicherheitspraktiken wächst jedoch weiter.
Die von SaferAI durchgeführte Bewertung über Z.ais öffentliche API ergab, dass GLM-5.2 keine der ihm zugewiesenen Aufgaben im Bereich offensive Cyberangriffe oder Biotechnologie mit Doppelnutzungszweck ablehnte. Im Gegensatz dazu lehnte Claude Opus 4.7 „so konsequent ab, dass SaferAI CyberGym damit überhaupt nicht abschließen konnte.“ (CyberGym ist ein Benchmark zur Bewertung von Cybersicherheitsfähigkeiten, den OpenAI in der vorletzten Hugging-Face-Bewertung verwendete.)
Dies unterstreicht eine seit Langem bestehende Sorge unter Kritikern: Open-Weight-KI-Modelle könnten potenziellen Angreifern hochleistungsfähige Technologie in die Hand geben, wobei es keine Möglichkeit gibt, die Nutzung zu kontrollieren, sobald die Gewichte heruntergeladen wurden. Da Open-Weight-Modelle rasch die Fähigkeiten führender KI-Systeme annähern, hat sich die Debatte von der Frage, ob sie wettbewerbsfähig sein können, hin zu der Frage verschoben, wie die Gesellschaft die Risiken ihrer Veröffentlichung manages.
„Die Grenze der Fähigkeiten ist nicht die Grenze des Risikos, und daher müssen wir auch den Stand der Minderungsmaßnahmen berücksichtigen, um das Risiko richtig einzuschätzen“, sagte Henry Papadatos, Geschäftsführer von SaferAI, gegenüber TechCrunch.
Während Z.ai Sicherheitsmaßnahmen auf seiner gehosteten API anwenden kann, werden diese Schutzmaßnahmen unwirksam, wenn Nutzer die Gewichte auf ihrer eigenen Hardware ausführen und somit Schutzmechanismen entfernen oder modifizieren, Modelle feinabstimmen oder Systemaufforderungen ändern können.
Entwickler von Spitzentechnologien wie OpenAI und Anthropic verlassen sich typischerweise auf Schutzmaßnahmen wie Klassifikatoren, Ablehnungstraining und API-Level-Kontrollen, um gefährliche Cyber- und biologische Unterstützung zu begrenzen.
Diese Maßnahmen sind alles andere als unfehlbar: Jailbreaks umgehen routinemäßig die Schutzmaßnahmen in bereitgestellten Modellen. Far.ai, ein gemeinnütziges KI-Sicherheitsunternehmen, identifizierte Hunderte universeller Jailbreaks – definiert als wiederverwendbare Schlüssel, die bei den meisten schädlichen Anfragen erfolgreich sind – in Spitzentechnologie-Modellen wie xAIs Grok 4.5 und Googles DeepMind Gemini 3.1 Pro. Der Bericht stellt fest, dass Jailbreaks erfolgreich sind, wenn Angreifer mehrere Manipulationstechniken kombinieren, darunter Rollenspiel, Identitätsmissbrauch von Autoritäten, gefälschte Gesprächsverläufe und Folgeaufforderungen, um Schwachstellen in den Abwehrmechanismen eines Modells auszunutzen.
Jedoch funktionieren Schutzmaßnahmen, die für geschlossene Modelle entwickelt wurden, nicht bei Open-Weight-Modellen, die darauf ausgelegt sind, auf jeder Infrastruktur ausgeführt zu werden, mit oder ohne Schutzmaßnahmen.
„Das Ziel sollte eindeutig darin bestehen, dass die guten Fähigkeiten – die sicheren – für jeden zugänglich sind, und dann versuchen wir, die schlechten zu entfernen, sogar im Open-Source-Stil“, sagte Papadatos.
Eine von Papadatos vorgeschlagene Technik ist die „Vorabtrainings-Datenfilterung“, bei der ein KI-Unternehmen offensive Cybersicherheitsinformationen aus den Trainingsdaten entfernt, bevor das Modell auf dem kuratierten Datensatz trainiert wird.
Einige Forschungsergebnisse deuten darauf hin, dass dies gefährliches biologisches Wissen reduzieren kann, ohne die Gesamtleistung des Modells zu beeinträchtigen. Datenfilterung ist jedoch für Cybersicherheit viel weniger praktikabel.
Es ist schwierig, ein allgemeines Modell zu trainieren, das in der Programmierung hervorragend ist, ohne auch ein kompetenter Hacker zu werden. Da Programmierung der größte Umsatztreiber für KI ist, stehen Entwickler unter Druck, diese Fähigkeiten zu verbessern, während sie nach Wegen suchen, Missbrauch zu begrenzen.
Folglich haben Spitzentechnologie-Entwickler zunehmend auf andere Minderungsmaßnahmen zurückgegriffen. Ein Ansatz besteht darin, selektiv zu beschränken, welche Arten von Cybersicherheitsunterstützung die Modelle bereitstellen. Anthropics Opus 5 kann beispielsweise nach Schwachstellen in nicht kompiliertem Quellcode suchen, aber nicht in kompilierter Software, laut dem Systemkarten des Modells. Die Begründung ist, dass dies die Nutzung von Opus 5 für offensive Zwecke erschwert.
Weitere Maßnahmen umfassen strenge Sicherheitsbewertungen vor der Bereitstellung, die Veröffentlichung von Risikobewertungen und das Zurückhalten von Modellgewichten, wenn ein System als zu gefährlich eingestuft wird.
Im Fall von GLM-5.2 stellte SaferAI fest, dass Z.ai keinen Sicherheitsrahmen, Verpflichtungen zu Vorab-Bereitstellungstests oder eine Risikobewertung für das Modell veröffentlichte. TechCrunch fragte Z.ai, ob vor der Veröffentlichung interne oder Drittanbieter-Bewertungen der Spitzentechnologiesicherheit durchgeführt wurden, erhielt jedoch keine Antwort.
Chinesische Führer haben die Risiken fortschrittlicher KI zunehmend anerkannt. Auf der letzten World AI Conference betonte der chinesische Präsident Xi Jinping die Bedeutung von Open-Weight-Modellen, betonte jedoch gleichzeitig die Notwendigkeit, sicherzustellen, dass KI ein Werkzeug unter strenger menschlicher Kontrolle bleibt.
Graham Webster, der chinesische KI-Politik am Stanford Cyber Policy Center studiert, sagte gegenüber TechCrunch, dass China über robuste KI-Vorschriften verfügt, diese Regeln sich jedoch historisch auf politisch sensible Inhalte, Desinformation und soziale Stabilität konzentriert haben, anstatt auf katastrophale KI-Risiken wie offensive Cyberfähigkeiten und biologischen Missbrauch.
„US-KI-Denker sind im Allgemeinen stärker mit dieser existenziellen katastrophalen [Idee] befasst als die chinesische Gemeinschaft“, sagte Webster und fügte hinzu, dass viele chinesische Politikforscher der Meinung sind, dass, wenn ein neuartiges Spitzentechnologierisiko entsteht, amerikanische Unternehmen es wahrscheinlich zuerst begegnen werden.
„Das chinesische System hat das Vertrauen, dass sie die Nutzung dieser Technologien innerhalb Chinas kontrollieren“, fuhr Webster fort. „Online zu sein in China ist etwas, das unter Ihrem echten Namen geschieht, und Unternehmen können zur Verantwortung gezogen werden, Nutzer können zur Verantwortung gezogen werden.“
Webster schlug vor, dass derselbe Mechanismus, den Modellanbieter verwenden, um die Teilnahme an bestimmten politischen Themen zu verweigern, potenziell so angepasst werden könnte, dass Modelle sicherstellen, keine offensiven Cyberangriffe auszuführen oder nachteilige biologische Ingenieurergebnisse zu liefern. Er fügte hinzu, dass chinesische Unternehmen oft hinter den Kulissen mit Regulierungsbehörden koordinieren, es daher schwierig ist zu wissen, welche internen Tests sie vor der Veröffentlichung durchführen.
Befürworter von Open-Weight-KI argumentieren, dass die Veröffentlichung von Gewichten für die Cybersicherheit entscheidend ist, da sie es Unternehmen ermöglicht, sich gegen Angriffe zu verteidigen – Hugging Face verließ sich auf GLM-5.2, um sich gegen OpenAIs Verletzung zu verteidigen – und hilft, sich auf zukünftige Bedrohungen vorzubereiten, indem sie verstehen, was kommt.
„Die gleichen Systeme, die halfen, einen KI-gestützten Cyberangriff zu stoppen, können nun helfen, gegen Millionen von Cyberangriffen jeden Tag zu verteidigen, während sie uns dabei helfen, Schwachstellen zu identifizieren und zu beheben, bevor Angreifer sie ausnutzen“, sagte Clem Delangue, CEO von Hugging Face, in einem Social-Media-Beitrag diese Woche.
Papadatos argumentierte, dass dieser Nutzen oft übertrieben wird und „das Öffnen gefährlicher Fähigkeiten“ nicht rechtfertigt.
„Der Hauptpunkt in meinem Kopf ist, dass wir nicht einfach akzeptieren sollten, dass gefährliche Fähigkeiten für jeden überall leicht zugänglich sind“, sagte er und betonte, dass die Industrie bestrebt sein sollte, nur „gute Fähigkeiten“ leicht zugänglich zu machen. Angreifer übernehmen neue Tools schneller als Verteidiger; zum Beispiel kann eine Ransomware-Gruppe ihre Methoden in einer Woche ändern, während ein Krankenhaus dies nicht kann.“








 Hugging Face in Verhandlungen über 13-Mrd.-$-Übernahme
Business Insider berichtete am Wochenende, dass Hugging Face mit einer Bewertung von 13 Milliarden US-Dollar oder mehr zum Verkauf aufgefordert wurde.Die Plattform und die Open-Source-Community des Startups sind Orte, an denen Entwickler und Forsche
 Im Wettlauf um die KI verlagert sich der Fokus von Pionierprojekten hin zu breiteren Anwendungsbereichen
Wochenlang konzentrierte sich die KI-Branche in diesem Sommer auf die neuesten „Frontier“-Modelle von Anthropic und die Bemühungen Washingtons, den Zugang dazu zu regulieren. Doch während die Aufmerks
 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K

Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai












