


 Heim
Was ist Gemini 2.5 Conversational Image Segmentation und wie kann man es im Jahr 2025 nutzen?
Die konversationelle Bildsegmentierung verändert die Art und Weise, wie wir mit Bildern interagieren und ihnen Bedeutung abgewinnen. Mit Gemini 2.5 können Benutzer natürliche Sprachbefehle nutzen, um Objekte innerhalb eines Bildes präzise zu identifizieren und zu isolieren und so ein neues Maß an Effizienz und Präzision zu erreichen. Dieser Durchbruch verspricht erhebliche Auswirkungen auf alle Branchen, von den digitalen Medien bis zur autonomen Technologie.
Wichtigste Punkte
Gemini 2.5 führt einen dialogorientierten Ansatz für die Bildsegmentierung ein, der es dem Benutzer ermöglicht, den Prozess mit einfacher Sprache zu steuern.
Damit entfällt der Bedarf an benutzerdefinierten, beschrifteten Datensätzen und die Entwicklung spezieller Segmentierungsmodelle grundlegend.
Diese Fähigkeit ermöglicht neue Anwendungen in Bereichen wie kreative Inhalte, industrielle Inspektion, Einzelhandel und Robotik.
Für jedes identifizierte Objekt liefert Gemini 2.5 eine strukturierte JSON-Ausgabe mit Bounding-Box-Koordinaten und einer detaillierten Segmentierungsmaske.
Das System verarbeitet und segmentiert Bilder in Echtzeit und liefert selbst bei komplexen Szenen und komplizierten Objekten genaue Ergebnisse.
Enthüllung der konversationellen Bildsegmentierung von Gemini 2.5
Die Leistungsfähigkeit der konversationellen Bildsegmentierung
Die herkömmliche Bildsegmentierung beruhte auf manuellen Anmerkungen, Bounding Boxes und Modellen, die auf spezifischen Datensätzen trainiert wurden. Gemini 2.5 definiert dies neu mit der konversationellen Bildsegmentierung, einem System, das Anweisungen in natürlicher Sprache interpretiert, um bestimmte Elemente in einem Bild zu identifizieren und zu extrahieren.

Benutzer beschreiben einfach das Ziel, und Gemini 2.5 führt die präzise Segmentierung durch.
Konversationelle KI trifft auf pixelgenaue Präzision. Diese Kombination ermöglicht es der KI, die Absicht des Benutzers genau zu verstehen, wodurch das umfangreiche ML-Training entfällt, das normalerweise für kundenspezifische Aufgaben erforderlich ist. Der Prozess wird vollständig durch natürliche Sprache gesteuert, so dass keine speziellen Trainingsdaten und keine Modellfeinabstimmung erforderlich sind.
Wo ältere Methoden bei unregelmäßigen Formen oder abstrakten Beschreibungen ins Stocken geraten, nutzt Gemini 2.5 sein kontextbezogenes Verständnis, um eine akribische Segmentierung auf Pixelebene zu erreichen. Komplexe Umrisse und relationale Beschreibungen ("die Katze, die am weitesten weg ist") werden mühelos gehandhabt, wodurch die Abhängigkeit von benutzerdefinierten Modellen und beschrifteten Daten entfällt.
Wie Gemini 2.5 das benutzerdefinierte Training eliminiert
Ein wichtiger Durchbruch von Gemini 2.5 ist die Fähigkeit, eine genaue Segmentierung ohne benutzerdefinierte Trainingsdaten durchzuführen. Mit dieser in der neuen Gemini-Version eingeführten Fähigkeit können Benutzer beliebige Anweisungen zu einem Bild eingeben. Die KI lokalisiert nicht nur die beschriebenen Objekte, sondern liefert auch ihre exakten Pixelmasken, was eine saubere Extraktion unabhängig von der Komplexität der Form ermöglicht.
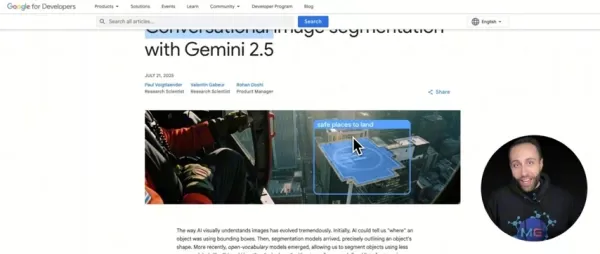
Herkömmliche Segmentierungsmodelle erfordern große, sorgfältig beschriftete Datensätze, deren Erstellung kostspielig und zeitintensiv ist. Gemini 2.5 umgeht diese Hürde vollständig. Es nutzt sein umfangreiches, bereits trainiertes Wissen und sein Sprachverständnis, um Bilder direkt aus Benutzereingaben zu segmentieren.
Verabschieden Sie sich von den Beschriftungsdaten. Auf diese Weise können Teams die Segmentierung sofort auf ihre individuellen Herausforderungen anwenden, ohne den Aufwand für die Datenaufbereitung betreiben zu müssen. Das System interpretiert verbale Beschreibungen, um alles in einem Bild auszuwählen, und ersetzt damit manuelles Klicken, Zeichnen und komplexe Softwaretools. Der Hauptvorteil besteht darin, dass für die benutzerdefinierte Segmentierung kein Training für maschinelles Lernen erforderlich ist, da die KI ausschließlich mit natürlichem Sprachinput arbeitet.
Neue Anwendungsfälle ermöglichen: Von Drohnen bis zur medizinischen Bildgebung
Der dialogorientierte Ansatz von Gemini 2.5 ermöglicht transformative Anwendungen in verschiedenen Bereichen:
- Erstellung von Inhalten: Sofortiges Entfernen von Hintergründen, Anwenden von Effekten auf bestimmte Elemente oder Erstellen dynamischer Masken mit einfachen Befehlen - alles ohne zusätzliche Software.
- Qualitätskontrolle: Identifizieren Sie Defekte, Anomalien oder Nichteinhaltung von Standards, indem Sie verbal den korrekten Standard oder die Art des Fehlers beschreiben.
- Einzelhandelsanalyse: Überwachen Sie den Warenbestand, analysieren Sie das Kundenverhalten und optimieren Sie das Ladenlayout mit Hilfe von Konversationsabfragen und nutzen Sie die natürliche Sprache, um Erkenntnisse über die Kunden zu gewinnen.
- Autonome Systeme: Statten Sie Roboter und Fahrzeuge mit der Fähigkeit aus, komplexe visuelle Umgebungen mithilfe von Anweisungen in natürlicher Sprache zu interpretieren, um ihre Wahrnehmung und Entscheidungsfindung zu verbessern.
Gemini 2.5 kann zum Beispiel Drohnenaufnahmen analysieren, um automatisch sichere Landezonen zu identifizieren. Die Benutzer laden einfach das Video zur Analyse hoch, das pixelgenau segmentiert ist.

Die Software kartiert präzise alle möglichen und gefährlichen Landezonen für die Drohne.
Autonome Erkennung von Drohnenlandezonen durch die pixelgenaue Segmentierung von Gemini 2.5.
In der medizinischen Bildgebung kann Gemini 2.5 außerdem bei der Überprüfung von Röntgenaufnahmen des Brustkorbs helfen, um Bereiche mit potenziellen Anomalien zu markieren. Durch die Verwendung natürlicher Sprache zur Steuerung der Analyse können Mediziner dank des fortschrittlichen Sprachverständnisses des Systems viel Zeit sparen.
Die Entwicklung von Computer Vision und Gemini 2.5
Von Bounding Boxes zum Gesprächsverstehen
Die Computer Vision hat sich mit den Fortschritten der künstlichen Intelligenz erheblich weiterentwickelt. Geminis Sprachverständnis stellt eine neue Grenze dar, die über die einfache Erkennung hinausgeht und zu einer interaktiven, sprachgesteuerten Segmentierung führt.
Bounding Boxes: Frühe KI-Systeme konnten nur rechteckige Boxen um Objekte herum platzieren und boten eine grobe Lokalisierung mit begrenzten Details.

Pixelgenaue Umrisse: Spätere Fortschritte ermöglichten es der KI, die exakten Konturen von Objekten durch Segmentierung nachzuzeichnen und selbst für unregelmäßige Formen präzise Masken zu erstellen.
Gesprächsverstehen: Mit Gemini 2.5 versteht das System nun auch den Kontext und beschreibende Ausdrücke. Anstatt nur "eine Katze" zu finden, kann es auf der Grundlage der Sprache des Benutzers "die Katze, die am weitesten entfernt ist" identifizieren.
Vorteile der neuen KI-Technologie mit Gemini. Die konversationelle Bildsegmentierung bietet greifbare Vorteile: Sie macht manuelles Klicken, Zeichnen oder komplexe Tools überflüssig und ersetzt sie durch einfache Beschreibungen in natürlicher Sprache. Mit diesem Ansatz entfällt der Aufwand für die Sammlung von Trainingsdaten und die Feinabstimmung des Modells.
Die Fähigkeiten von Gemini Durch den Verzicht auf Ein-Wort-Beschriftungen bietet das System eine intuitivere und leistungsfähigere Schnittstelle für visuelle Daten. Es zeichnet sich durch mehrere Abfragetypen aus, darunter:
- Objektbeziehungen: z. B. "die Person, die den Schirm hält", "das dritte Buch von links" oder "die verwelkteste Blume im Strauß".
- Bedingte Logik: wie z.B. "vegetarisches Essen" oder "die Leute, die nicht sitzen". Gemini 2.5 versteht diese nuancierten Attribute.
- Abstrakte Konzepte: Sein fortschrittliches semantisches Wissen ermöglicht eine Segmentierung auf der Grundlage von Ideen wie "ein unordentlicher Bereich" oder "eine Gelegenheit", wodurch bisher unmögliche Aufgaben praktisch werden.
Häufig gestellte Fragen
Was ist konversationelle Bildsegmentierung?
Bei der konversationellen Bildsegmentierung handelt es sich um eine KI-gestützte Technologie, die es den Nutzern ermöglicht, bestimmte Objekte in einem Bild mithilfe von Anweisungen in natürlicher Sprache zu identifizieren und zu isolieren, anstatt mit manuellen Werkzeugen.
Wie unterscheidet sich Gemini 2.5 von der herkömmlichen Bildsegmentierung?
Im Gegensatz zu herkömmlichen Methoden benötigt Gemini 2.5 keine benutzerdefinierten Trainingsdatensätze oder spezielle Segmentierungsmodelle. Gemini 2.5 nutzt sein vortrainiertes Wissen und die Verarbeitung natürlicher Sprache, um Bilder allein auf der Grundlage von Benutzerbeschreibungen zu segmentieren.
Welche Branchen können von der konversationellen Bildsegmentierung von Gemini 2.5 profitieren?
Zahlreiche Branchen können davon profitieren, darunter die Erstellung von Inhalten, die Qualitätskontrolle in der Fertigung, der Einzelhandel und die Analytik sowie die Entwicklung autonomer Systeme wie Roboter und selbstfahrende Fahrzeuge.
Welches Ausgabeformat bietet Gemini 2.5 für die Segmentierungsergebnisse?
Die Ergebnisse werden in einem strukturierten JSON-Format ausgegeben, das sowohl Bounding-Box-Koordinaten als auch detaillierte Segmentierungsmasken für jedes identifizierte Objekt enthält, was eine einfache Integration in andere Software und Anwendungen ermöglicht.
Ist Gemini 2.5 für Bilder mit unregelmäßigen Formen oder abstrakten Konzepten geeignet?
Ja. Gemini 2.5 wurde entwickelt, um komplexe Formen und abstrakte Beschreibungen zu handhaben, indem es sein tiefes kontextuelles Verständnis nutzt und eine präzise Segmentierung selbst für anspruchsvolle Ziele liefert, die durch relationale Begriffe definiert sind.
Verwandte Fragen
Wie kann Gemini 2.5 bei der Erstellung von Inhalten eingesetzt werden?
Gemini 2.5 rationalisiert Arbeitsabläufe, indem es die schnelle Entfernung von Hintergründen, die gezielte Anwendung von Effekten und die dynamische Erstellung von Masken ermöglicht - alles gesteuert durch natürliche Sprache. Dank dieser Effizienz können sich die Kreativen besser auf ihre kreative Vision konzentrieren und Werkzeuge wie Photoshop ergänzen.
Welche Rolle spielt Gemini 2.5 bei der Qualitätskontrolle?
In der Qualitätskontrolle ermöglicht es Inspektoren, Fehler oder Abweichungen zu erkennen, indem sie verbal definieren, wie ein korrektes Produkt oder Bauteil aussehen sollte. Dank der pixelgenauen Segmentierungsgenauigkeit wird eine gleichbleibende Qualität sichergestellt, ohne dass umfangreiche Fehlerdatenbanken erstellt werden müssen.
Wie verbessert Gemini 2.5 die Einzelhandelsanalytik?
Gemini 2.5 verbessert die Einzelhandelsanalyse, indem es die Bestandsverfolgung, die Analyse des Kundenverhaltens und die Optimierung des Regallayouts durch einfache Konversationsabfragen ermöglicht. Dieser datengesteuerte Ansatz hilft Einzelhändlern, das Kundenerlebnis zu verbessern und den Umsatz durch KI-gestützte Erkenntnisse zu steigern.
Auf welche Weise kann Gemini 2.5 autonome Systeme verbessern?
Es verbessert autonome Systeme, indem es Roboter und Fahrzeuge in die Lage versetzt, komplexe visuelle Szenen über natürlichsprachliche Befehle zu interpretieren. Die Anwendungen reichen von der Identifizierung sicherer Drohnenlandezonen bis hin zur Erkennung von Fußgängern für selbstfahrende Autos, was sowohl die Sicherheit als auch die betriebliche Effizienz verbessert und gleichzeitig die Entwicklungszeit und -kosten reduziert.
Verwandter Artikel
 Sechs Tech-Giganten unterstützen die Linux Foundation mit 12,5 Millionen US-Dollar, um das Rauschen bei KI-Schwachstellen zu bekämpfen
Um der Flut von Sicherheitsberichten niedriger Qualität, die durch KI-Automatisierungstools erzeugt werden, zu begegnen, haben sechs große Technologieunternehmen – Anthropic, Amazon (AWS), GitHub, Google, Microsoft und OpenAI – gemeinsam 12,5 Million
Musk erwog, OpenAI an seine Kinder zu übergeben, während Altman aussagte
Diesen Morgen trat OpenAI-CEO Sam Altman vor Gericht, um sich zur Klage von Ex-Mitbegründer Elon Musk zu äußern, die die Unternehmensstruktur der Firma anfechtet.Auf die Frage nach Musks Behauptung, andere Mitbegründer hätten „eine Wohltätigkeitsorg
Sam Altman löst eine Debatte über die Verlangsamung der KI-Entwicklung aus
Bei Apple Podcasts anhörenBei Spotify anhörenDer CEO von OpenAI, Sam Altman, hat kürzlich vorgeschlagen, es könnte an der Zeit sein, „das Tempo der KI-Entwicklung zu drosseln“, um der Gesellschaft Zeit zu geben, „sich um einige dieser neuen Fähigkei
Empfehlungen zu verwandten Spezialthemen
Geschäft
 Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
 9 Tools
 xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai
Code
KI-Tools zur Überprüfung von Pull-Requests für GitHub-Teams, die sich mit Refactorings, Fehlern und Sicherheitslücken befassen
Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai
Text-zu-Sprache
Die besten KI-Tools zur Text-zu-Sprache-Umwandlung für natürliche Sprachausgabe
Die besten und am besten bewerteten KI-Text-to-Speech-Tools für natürliche Sprachausgabe des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Optionen, die für jeden Anwendungsfall kristallklare Stimmen liefern – gestützt auf Tests in der Praxis und wöchentlich aktualisierte Rankings. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die Lösung zu finden, die Sie unbedingt ausprobieren sollten und die Ihre Produktivität sofort steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

 Kommentare (1)
![ThomasMiller]()
Ces avancées en segmentation d'images par commande vocale me font rêver ! 😍 Imaginez pouvoir simplement dire 'montre-moi tous les chiens sur cette photo de parc' et voir la magie opérer. Mais ça soulève aussi des questions sur la vie privée... jusqu'où cette technologie pourrait-elle analyser nos images sans consentement ? 🧐
Die konversationelle Bildsegmentierung verändert die Art und Weise, wie wir mit Bildern interagieren und ihnen Bedeutung abgewinnen. Mit Gemini 2.5 können Benutzer natürliche Sprachbefehle nutzen, um Objekte innerhalb eines Bildes präzise zu identifizieren und zu isolieren und so ein neues Maß an Effizienz und Präzision zu erreichen. Dieser Durchbruch verspricht erhebliche Auswirkungen auf alle Branchen, von den digitalen Medien bis zur autonomen Technologie.
Wichtigste Punkte
Gemini 2.5 führt einen dialogorientierten Ansatz für die Bildsegmentierung ein, der es dem Benutzer ermöglicht, den Prozess mit einfacher Sprache zu steuern.
Damit entfällt der Bedarf an benutzerdefinierten, beschrifteten Datensätzen und die Entwicklung spezieller Segmentierungsmodelle grundlegend.
Diese Fähigkeit ermöglicht neue Anwendungen in Bereichen wie kreative Inhalte, industrielle Inspektion, Einzelhandel und Robotik.
Für jedes identifizierte Objekt liefert Gemini 2.5 eine strukturierte JSON-Ausgabe mit Bounding-Box-Koordinaten und einer detaillierten Segmentierungsmaske.
Das System verarbeitet und segmentiert Bilder in Echtzeit und liefert selbst bei komplexen Szenen und komplizierten Objekten genaue Ergebnisse.
Enthüllung der konversationellen Bildsegmentierung von Gemini 2.5
Die Leistungsfähigkeit der konversationellen Bildsegmentierung
Die herkömmliche Bildsegmentierung beruhte auf manuellen Anmerkungen, Bounding Boxes und Modellen, die auf spezifischen Datensätzen trainiert wurden. Gemini 2.5 definiert dies neu mit der konversationellen Bildsegmentierung, einem System, das Anweisungen in natürlicher Sprache interpretiert, um bestimmte Elemente in einem Bild zu identifizieren und zu extrahieren.
Benutzer beschreiben einfach das Ziel, und Gemini 2.5 führt die präzise Segmentierung durch.
Konversationelle KI trifft auf pixelgenaue Präzision. Diese Kombination ermöglicht es der KI, die Absicht des Benutzers genau zu verstehen, wodurch das umfangreiche ML-Training entfällt, das normalerweise für kundenspezifische Aufgaben erforderlich ist. Der Prozess wird vollständig durch natürliche Sprache gesteuert, so dass keine speziellen Trainingsdaten und keine Modellfeinabstimmung erforderlich sind.
Wo ältere Methoden bei unregelmäßigen Formen oder abstrakten Beschreibungen ins Stocken geraten, nutzt Gemini 2.5 sein kontextbezogenes Verständnis, um eine akribische Segmentierung auf Pixelebene zu erreichen. Komplexe Umrisse und relationale Beschreibungen ("die Katze, die am weitesten weg ist") werden mühelos gehandhabt, wodurch die Abhängigkeit von benutzerdefinierten Modellen und beschrifteten Daten entfällt.
Wie Gemini 2.5 das benutzerdefinierte Training eliminiert
Ein wichtiger Durchbruch von Gemini 2.5 ist die Fähigkeit, eine genaue Segmentierung ohne benutzerdefinierte Trainingsdaten durchzuführen. Mit dieser in der neuen Gemini-Version eingeführten Fähigkeit können Benutzer beliebige Anweisungen zu einem Bild eingeben. Die KI lokalisiert nicht nur die beschriebenen Objekte, sondern liefert auch ihre exakten Pixelmasken, was eine saubere Extraktion unabhängig von der Komplexität der Form ermöglicht.
Herkömmliche Segmentierungsmodelle erfordern große, sorgfältig beschriftete Datensätze, deren Erstellung kostspielig und zeitintensiv ist. Gemini 2.5 umgeht diese Hürde vollständig. Es nutzt sein umfangreiches, bereits trainiertes Wissen und sein Sprachverständnis, um Bilder direkt aus Benutzereingaben zu segmentieren.
Verabschieden Sie sich von den Beschriftungsdaten. Auf diese Weise können Teams die Segmentierung sofort auf ihre individuellen Herausforderungen anwenden, ohne den Aufwand für die Datenaufbereitung betreiben zu müssen. Das System interpretiert verbale Beschreibungen, um alles in einem Bild auszuwählen, und ersetzt damit manuelles Klicken, Zeichnen und komplexe Softwaretools. Der Hauptvorteil besteht darin, dass für die benutzerdefinierte Segmentierung kein Training für maschinelles Lernen erforderlich ist, da die KI ausschließlich mit natürlichem Sprachinput arbeitet.
Neue Anwendungsfälle ermöglichen: Von Drohnen bis zur medizinischen Bildgebung
Der dialogorientierte Ansatz von Gemini 2.5 ermöglicht transformative Anwendungen in verschiedenen Bereichen:
- Erstellung von Inhalten: Sofortiges Entfernen von Hintergründen, Anwenden von Effekten auf bestimmte Elemente oder Erstellen dynamischer Masken mit einfachen Befehlen - alles ohne zusätzliche Software.
- Qualitätskontrolle: Identifizieren Sie Defekte, Anomalien oder Nichteinhaltung von Standards, indem Sie verbal den korrekten Standard oder die Art des Fehlers beschreiben.
- Einzelhandelsanalyse: Überwachen Sie den Warenbestand, analysieren Sie das Kundenverhalten und optimieren Sie das Ladenlayout mit Hilfe von Konversationsabfragen und nutzen Sie die natürliche Sprache, um Erkenntnisse über die Kunden zu gewinnen.
- Autonome Systeme: Statten Sie Roboter und Fahrzeuge mit der Fähigkeit aus, komplexe visuelle Umgebungen mithilfe von Anweisungen in natürlicher Sprache zu interpretieren, um ihre Wahrnehmung und Entscheidungsfindung zu verbessern.
Gemini 2.5 kann zum Beispiel Drohnenaufnahmen analysieren, um automatisch sichere Landezonen zu identifizieren. Die Benutzer laden einfach das Video zur Analyse hoch, das pixelgenau segmentiert ist.
Die Software kartiert präzise alle möglichen und gefährlichen Landezonen für die Drohne.
Autonome Erkennung von Drohnenlandezonen durch die pixelgenaue Segmentierung von Gemini 2.5.
In der medizinischen Bildgebung kann Gemini 2.5 außerdem bei der Überprüfung von Röntgenaufnahmen des Brustkorbs helfen, um Bereiche mit potenziellen Anomalien zu markieren. Durch die Verwendung natürlicher Sprache zur Steuerung der Analyse können Mediziner dank des fortschrittlichen Sprachverständnisses des Systems viel Zeit sparen.
Die Entwicklung von Computer Vision und Gemini 2.5
Von Bounding Boxes zum Gesprächsverstehen
Die Computer Vision hat sich mit den Fortschritten der künstlichen Intelligenz erheblich weiterentwickelt. Geminis Sprachverständnis stellt eine neue Grenze dar, die über die einfache Erkennung hinausgeht und zu einer interaktiven, sprachgesteuerten Segmentierung führt.
Bounding Boxes: Frühe KI-Systeme konnten nur rechteckige Boxen um Objekte herum platzieren und boten eine grobe Lokalisierung mit begrenzten Details.
Pixelgenaue Umrisse: Spätere Fortschritte ermöglichten es der KI, die exakten Konturen von Objekten durch Segmentierung nachzuzeichnen und selbst für unregelmäßige Formen präzise Masken zu erstellen.
Gesprächsverstehen: Mit Gemini 2.5 versteht das System nun auch den Kontext und beschreibende Ausdrücke. Anstatt nur "eine Katze" zu finden, kann es auf der Grundlage der Sprache des Benutzers "die Katze, die am weitesten entfernt ist" identifizieren.
Vorteile der neuen KI-Technologie mit Gemini. Die konversationelle Bildsegmentierung bietet greifbare Vorteile: Sie macht manuelles Klicken, Zeichnen oder komplexe Tools überflüssig und ersetzt sie durch einfache Beschreibungen in natürlicher Sprache. Mit diesem Ansatz entfällt der Aufwand für die Sammlung von Trainingsdaten und die Feinabstimmung des Modells.
Die Fähigkeiten von Gemini Durch den Verzicht auf Ein-Wort-Beschriftungen bietet das System eine intuitivere und leistungsfähigere Schnittstelle für visuelle Daten. Es zeichnet sich durch mehrere Abfragetypen aus, darunter:
- Objektbeziehungen: z. B. "die Person, die den Schirm hält", "das dritte Buch von links" oder "die verwelkteste Blume im Strauß".
- Bedingte Logik: wie z.B. "vegetarisches Essen" oder "die Leute, die nicht sitzen". Gemini 2.5 versteht diese nuancierten Attribute.
- Abstrakte Konzepte: Sein fortschrittliches semantisches Wissen ermöglicht eine Segmentierung auf der Grundlage von Ideen wie "ein unordentlicher Bereich" oder "eine Gelegenheit", wodurch bisher unmögliche Aufgaben praktisch werden.
Häufig gestellte Fragen
Was ist konversationelle Bildsegmentierung?
Bei der konversationellen Bildsegmentierung handelt es sich um eine KI-gestützte Technologie, die es den Nutzern ermöglicht, bestimmte Objekte in einem Bild mithilfe von Anweisungen in natürlicher Sprache zu identifizieren und zu isolieren, anstatt mit manuellen Werkzeugen.
Wie unterscheidet sich Gemini 2.5 von der herkömmlichen Bildsegmentierung?
Im Gegensatz zu herkömmlichen Methoden benötigt Gemini 2.5 keine benutzerdefinierten Trainingsdatensätze oder spezielle Segmentierungsmodelle. Gemini 2.5 nutzt sein vortrainiertes Wissen und die Verarbeitung natürlicher Sprache, um Bilder allein auf der Grundlage von Benutzerbeschreibungen zu segmentieren.
Welche Branchen können von der konversationellen Bildsegmentierung von Gemini 2.5 profitieren?
Zahlreiche Branchen können davon profitieren, darunter die Erstellung von Inhalten, die Qualitätskontrolle in der Fertigung, der Einzelhandel und die Analytik sowie die Entwicklung autonomer Systeme wie Roboter und selbstfahrende Fahrzeuge.
Welches Ausgabeformat bietet Gemini 2.5 für die Segmentierungsergebnisse?
Die Ergebnisse werden in einem strukturierten JSON-Format ausgegeben, das sowohl Bounding-Box-Koordinaten als auch detaillierte Segmentierungsmasken für jedes identifizierte Objekt enthält, was eine einfache Integration in andere Software und Anwendungen ermöglicht.
Ist Gemini 2.5 für Bilder mit unregelmäßigen Formen oder abstrakten Konzepten geeignet?
Ja. Gemini 2.5 wurde entwickelt, um komplexe Formen und abstrakte Beschreibungen zu handhaben, indem es sein tiefes kontextuelles Verständnis nutzt und eine präzise Segmentierung selbst für anspruchsvolle Ziele liefert, die durch relationale Begriffe definiert sind.
Verwandte Fragen
Wie kann Gemini 2.5 bei der Erstellung von Inhalten eingesetzt werden?
Gemini 2.5 rationalisiert Arbeitsabläufe, indem es die schnelle Entfernung von Hintergründen, die gezielte Anwendung von Effekten und die dynamische Erstellung von Masken ermöglicht - alles gesteuert durch natürliche Sprache. Dank dieser Effizienz können sich die Kreativen besser auf ihre kreative Vision konzentrieren und Werkzeuge wie Photoshop ergänzen.
Welche Rolle spielt Gemini 2.5 bei der Qualitätskontrolle?
In der Qualitätskontrolle ermöglicht es Inspektoren, Fehler oder Abweichungen zu erkennen, indem sie verbal definieren, wie ein korrektes Produkt oder Bauteil aussehen sollte. Dank der pixelgenauen Segmentierungsgenauigkeit wird eine gleichbleibende Qualität sichergestellt, ohne dass umfangreiche Fehlerdatenbanken erstellt werden müssen.
Wie verbessert Gemini 2.5 die Einzelhandelsanalytik?
Gemini 2.5 verbessert die Einzelhandelsanalyse, indem es die Bestandsverfolgung, die Analyse des Kundenverhaltens und die Optimierung des Regallayouts durch einfache Konversationsabfragen ermöglicht. Dieser datengesteuerte Ansatz hilft Einzelhändlern, das Kundenerlebnis zu verbessern und den Umsatz durch KI-gestützte Erkenntnisse zu steigern.
Auf welche Weise kann Gemini 2.5 autonome Systeme verbessern?
Es verbessert autonome Systeme, indem es Roboter und Fahrzeuge in die Lage versetzt, komplexe visuelle Szenen über natürlichsprachliche Befehle zu interpretieren. Die Anwendungen reichen von der Identifizierung sicherer Drohnenlandezonen bis hin zur Erkennung von Fußgängern für selbstfahrende Autos, was sowohl die Sicherheit als auch die betriebliche Effizienz verbessert und gleichzeitig die Entwicklungszeit und -kosten reduziert.








 Sechs Tech-Giganten unterstützen die Linux Foundation mit 12,5 Millionen US-Dollar, um das Rauschen bei KI-Schwachstellen zu bekämpfen
Um der Flut von Sicherheitsberichten niedriger Qualität, die durch KI-Automatisierungstools erzeugt werden, zu begegnen, haben sechs große Technologieunternehmen – Anthropic, Amazon (AWS), GitHub, Google, Microsoft und OpenAI – gemeinsam 12,5 Million
 Musk erwog, OpenAI an seine Kinder zu übergeben, während Altman aussagte
Diesen Morgen trat OpenAI-CEO Sam Altman vor Gericht, um sich zur Klage von Ex-Mitbegründer Elon Musk zu äußern, die die Unternehmensstruktur der Firma anfechtet.Auf die Frage nach Musks Behauptung, andere Mitbegründer hätten „eine Wohltätigkeitsorg
 Sam Altman löst eine Debatte über die Verlangsamung der KI-Entwicklung aus
Bei Apple Podcasts anhörenBei Spotify anhörenDer CEO von OpenAI, Sam Altman, hat kürzlich vorgeschlagen, es könnte an der Zeit sein, „das Tempo der KI-Entwicklung zu drosseln“, um der Gesellschaft Zeit zu geben, „sich um einige dieser neuen Fähigkei

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Text-to-Speech-Tools für natürliche Sprachausgabe des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Optionen, die für jeden Anwendungsfall kristallklare Stimmen liefern – gestützt auf Tests in der Praxis und wöchentlich aktualisierte Rankings. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die Lösung zu finden, die Sie unbedingt ausprobieren sollten und die Ihre Produktivität sofort steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

Ces avancées en segmentation d'images par commande vocale me font rêver ! 😍 Imaginez pouvoir simplement dire 'montre-moi tous les chiens sur cette photo de parc' et voir la magie opérer. Mais ça soulève aussi des questions sur la vie privée... jusqu'où cette technologie pourrait-elle analyser nos images sans consentement ? 🧐












