


 Heim
AReaL 2.0 Open Source: RL-Infrastruktur für sich selbst weiterentwickelnde Agenten durch Nutzung
Am 2. Juli veröffentlichte das Open-Source-Projekt AReaL zur Infrastruktur für verstärktes Lernen offiziell die Version 2.0. AReaL soll die Lücke zwischen dem Training grundlegender Modelle und modernen Agentenanwendungen schließen und bietet effiziente Unterstützung beim Training mit verstärktem Lernen für Agentenszenarien.
Das neu eingeführte AReaL 2.0 richtet sich an Agenten, die in realen Geschäftsumgebungen eingesetzt werden, und stellt eine Systeminfrastruktur bereit, die kontinuierliches Lernen während des Einsatzes der Agenten ermöglicht. Mit AReaL 2.0 können die Interaktionsprozesse, die Agenten bei der Ausführung realer Aufgaben generieren, aufgezeichnet, organisiert und in nachfolgende Trainingszyklen integriert werden. Diese Prozesse dienen dazu, die zugrunde liegenden Modelle kontinuierlich zu verfeinern, sodass Agenten leistungsfähiger werden und gleichzeitig sicher und kontrollierbar bleiben.
Derzeit halten Agenten Einzug in reale Produktionsumgebungen – sie schreiben Code, suchen nach Informationen und rufen Tools auf, um immer komplexere Aufgaben innerhalb von Unternehmenssystemen zu erledigen. Dabei ist jedoch ein Problem aufgetreten: Agenten arbeiten zwar täglich, lernen aber selten aus ihren Erfahrungen.
In realen Geschäftsszenarien sammeln Agenten eine große Menge wertvoller Erfahrungen: welche Aufgaben wurden gut erledigt, wo schlugen Tool-Aufrufe fehl, warum waren Nutzer unzufrieden und ob eine bestimmte Entscheidung in die falsche Richtung ging. Diese Informationen werden jedoch meist in Protokollen gespeichert, was es schwierig macht, sie stabil und sicher in den nächsten Schritt der Leistungsverbesserung umzusetzen.
AReaL 2.0 zielt darauf ab, das Problem zu lösen, wie Agenten nach ihrer Bereitstellung weiter wachsen können. Entwickler müssen Agenten nicht neu entwickeln; sie müssen lediglich die Anfragen, die Agenten normalerweise an große Modelle senden, über den einheitlichen Inferenz-Endpunkt von AReaL 2.0 leiten, um sie in den Online-Verstärkungslernprozess zu integrieren.
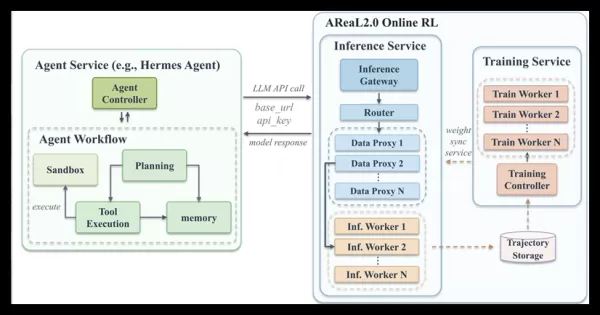
Abbildung: Architekturdiagramm des Online-Reinforcement-Learning (Online-RL) von AReaL 2.0
Nehmen wir den Hermes-Agenten als Beispiel. Hermes empfängt weiterhin wie gewohnt Aufgaben, plant Schritte und ruft Modelle auf. AReaL 2.0 zeichnet im Hintergrund die wichtigsten Interaktionsabläufe auf, während Hermes Aufgaben erledigt, und nutzt diese realen Verläufe in Kombination mit Feedback- oder Belohnungssignalen nach Abschluss der Aufgabe für das anschließende Training. Entwickler können Hermes auch durch ihren eigenen Agenten und ihre eigene Aufgabenumgebung ersetzen und mit demselben Ansatz einen Online-Verstärkungslernprozess für Agenten aufbauen.
Das bedeutet, dass die Verbesserung der Fähigkeiten eines Agenten nicht mehr ausschließlich auf manuell erstellten Daten, Offline-Training und erneuter Bereitstellung beruht. Mehrrundige Konversationen, Tool-Aufrufe, Ausführungsergebnisse und Rückmeldesignale aus realen Aufgaben können alle als Material für das Modelllernen dienen.
Dieser Punkt ist insbesondere in Unternehmensszenarien von Bedeutung. Agenten in Unternehmensabläufen sehen sich mit realen, komplexen und sich ständig ändernden Aufgaben konfrontiert: Code-Repositorys können aktualisiert werden, Geschäftsprozesse können sich ändern, Nutzerbedürfnisse können sich verschieben, und auch Werkzeuge und Systeme können sich wandeln. Sind die Fähigkeiten eines Agenten nach der Bereitstellung fest vorgegeben, wird er im Laufe der Zeit Schwierigkeiten haben, sich an die reale Umgebung anzupassen. AReaL 2.0 zielt darauf ab, die Lücke zwischen „der Fähigkeit, Tools zu nutzen“ und „der Fähigkeit, aus der Nutzung zu lernen“ zu schließen.
Gleichzeitig darf es beim kontinuierlichen Lernen in realen Geschäftsszenarien nicht lediglich um „das Sammeln von Daten und das erneute Trainieren“ gehen. Agenten greifen möglicherweise auf Code, Kundeninformationen, Wissensdatenbanken des Unternehmens und interne Systeme zu, weshalb die Trainingspipeline Anforderungen wie Zugriffskontrolle, Datenanonymisierung, Isolierung und Auditierung berücksichtigen muss. AReaL 2.0 führt in seinem Systemdesign einen Daten-Proxy-Mechanismus für Agenten-Traces ein, wodurch echte Aufgabendaten beim Eintritt in den Trainingsprozess sicherer und kontrollierter verwaltet und genutzt werden können.
Das AReaL-Team wies in seinem technischen Bericht darauf hin, dass der entscheidende Engpass für sich selbst weiterentwickelnde Agenten nicht nur darin besteht, wie leistungsfähig das Modell ist oder ob der Algorithmus für bestärkendes Lernen fortschrittlich ist, sondern im Fehlen einer Infrastruktur für online-basiertes bestärkendes Lernen, die echte Agenten unterstützt. AReaL 2.0 ist ein Architektur-Upgrade, das auf die nächste Generation von Agentenanwendungen abzielt: die Verknüpfung von Agentendiensten, realen Aufgabenverläufen, Daten-Governance und Online-Training mit verstärkendem Lernen, wodurch Agenten die praktische technische Grundlage erhalten, um nach der Bereitstellung weiter zu lernen.
Langfristig weist AReaL 2.0 auf das Evolutionsparadigma der nächsten Generation von Agentenanwendungen hin: Agenten sind nicht mehr nur einmalig trainierte und bereitgestellte Werkzeuge, sondern erhalten kontinuierlich Feedback in realen Umgebungen, wandeln sowohl Erfolge als auch Misserfolge in Erfahrungen um und verbessern ihre Fähigkeiten kontinuierlich innerhalb sicherer Grenzen.
Das AReaL-Projekt wurde 2024 von Teams ins Leben gerufen, zu denen unter anderem die Ant Group, die Tsinghua-Universität und die Hong Kong University of Science and Technology gehörten. Im Mai 2026 verließ AReaL offiziell das Inkubationsprogramm „Ant InclusionAI“ und wurde zu einer unabhängigen Open-Source-Community, die sich dem Projekt „PyTorch Foundation Ecosystem“ anschloss und sich damit weiter in das Mainstream-Ökosystem der Infrastruktur für verstärktes Lernen integrierte.
Während sich die Community eigenständig weiterentwickelt, erhält AReaL weiterhin Unterstützung und Beteiligung von Partnern aus der Industrie und dem Open-Source-Ökosystem, darunter das Huawei Cloud-Team und MindLab. Auch in Zukunft wird AReaL seine Arbeit in Bereichen wie Online-Reinforcement-Learning, automatisierte Bewertung und multimodales Agenten-Training fortsetzen und gemeinsam mit der Community die Entwicklung selbstentwickelnder Agenten-Ökosysteme vorantreiben.
Derzeit sind der technische Bericht und der Code zu AReaL 2.0 als Open Source verfügbar.
· GitHub-Repository: https://github.com/areal-project/AReaL
· Technischer Bericht: https://arxiv.org/abs/2607.01120
Verwandter Artikel
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
Empfehlungen zu verwandten Spezialthemen
Schreiben
 Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (0)
Am 2. Juli veröffentlichte das Open-Source-Projekt AReaL zur Infrastruktur für verstärktes Lernen offiziell die Version 2.0. AReaL soll die Lücke zwischen dem Training grundlegender Modelle und modernen Agentenanwendungen schließen und bietet effiziente Unterstützung beim Training mit verstärktem Lernen für Agentenszenarien.
Das neu eingeführte AReaL 2.0 richtet sich an Agenten, die in realen Geschäftsumgebungen eingesetzt werden, und stellt eine Systeminfrastruktur bereit, die kontinuierliches Lernen während des Einsatzes der Agenten ermöglicht. Mit AReaL 2.0 können die Interaktionsprozesse, die Agenten bei der Ausführung realer Aufgaben generieren, aufgezeichnet, organisiert und in nachfolgende Trainingszyklen integriert werden. Diese Prozesse dienen dazu, die zugrunde liegenden Modelle kontinuierlich zu verfeinern, sodass Agenten leistungsfähiger werden und gleichzeitig sicher und kontrollierbar bleiben.
Derzeit halten Agenten Einzug in reale Produktionsumgebungen – sie schreiben Code, suchen nach Informationen und rufen Tools auf, um immer komplexere Aufgaben innerhalb von Unternehmenssystemen zu erledigen. Dabei ist jedoch ein Problem aufgetreten: Agenten arbeiten zwar täglich, lernen aber selten aus ihren Erfahrungen.
In realen Geschäftsszenarien sammeln Agenten eine große Menge wertvoller Erfahrungen: welche Aufgaben wurden gut erledigt, wo schlugen Tool-Aufrufe fehl, warum waren Nutzer unzufrieden und ob eine bestimmte Entscheidung in die falsche Richtung ging. Diese Informationen werden jedoch meist in Protokollen gespeichert, was es schwierig macht, sie stabil und sicher in den nächsten Schritt der Leistungsverbesserung umzusetzen.
AReaL 2.0 zielt darauf ab, das Problem zu lösen, wie Agenten nach ihrer Bereitstellung weiter wachsen können. Entwickler müssen Agenten nicht neu entwickeln; sie müssen lediglich die Anfragen, die Agenten normalerweise an große Modelle senden, über den einheitlichen Inferenz-Endpunkt von AReaL 2.0 leiten, um sie in den Online-Verstärkungslernprozess zu integrieren.
Abbildung: Architekturdiagramm des Online-Reinforcement-Learning (Online-RL) von AReaL 2.0
Nehmen wir den Hermes-Agenten als Beispiel. Hermes empfängt weiterhin wie gewohnt Aufgaben, plant Schritte und ruft Modelle auf. AReaL 2.0 zeichnet im Hintergrund die wichtigsten Interaktionsabläufe auf, während Hermes Aufgaben erledigt, und nutzt diese realen Verläufe in Kombination mit Feedback- oder Belohnungssignalen nach Abschluss der Aufgabe für das anschließende Training. Entwickler können Hermes auch durch ihren eigenen Agenten und ihre eigene Aufgabenumgebung ersetzen und mit demselben Ansatz einen Online-Verstärkungslernprozess für Agenten aufbauen.
Das bedeutet, dass die Verbesserung der Fähigkeiten eines Agenten nicht mehr ausschließlich auf manuell erstellten Daten, Offline-Training und erneuter Bereitstellung beruht. Mehrrundige Konversationen, Tool-Aufrufe, Ausführungsergebnisse und Rückmeldesignale aus realen Aufgaben können alle als Material für das Modelllernen dienen.
Dieser Punkt ist insbesondere in Unternehmensszenarien von Bedeutung. Agenten in Unternehmensabläufen sehen sich mit realen, komplexen und sich ständig ändernden Aufgaben konfrontiert: Code-Repositorys können aktualisiert werden, Geschäftsprozesse können sich ändern, Nutzerbedürfnisse können sich verschieben, und auch Werkzeuge und Systeme können sich wandeln. Sind die Fähigkeiten eines Agenten nach der Bereitstellung fest vorgegeben, wird er im Laufe der Zeit Schwierigkeiten haben, sich an die reale Umgebung anzupassen. AReaL 2.0 zielt darauf ab, die Lücke zwischen „der Fähigkeit, Tools zu nutzen“ und „der Fähigkeit, aus der Nutzung zu lernen“ zu schließen.
Gleichzeitig darf es beim kontinuierlichen Lernen in realen Geschäftsszenarien nicht lediglich um „das Sammeln von Daten und das erneute Trainieren“ gehen. Agenten greifen möglicherweise auf Code, Kundeninformationen, Wissensdatenbanken des Unternehmens und interne Systeme zu, weshalb die Trainingspipeline Anforderungen wie Zugriffskontrolle, Datenanonymisierung, Isolierung und Auditierung berücksichtigen muss. AReaL 2.0 führt in seinem Systemdesign einen Daten-Proxy-Mechanismus für Agenten-Traces ein, wodurch echte Aufgabendaten beim Eintritt in den Trainingsprozess sicherer und kontrollierter verwaltet und genutzt werden können.
Das AReaL-Team wies in seinem technischen Bericht darauf hin, dass der entscheidende Engpass für sich selbst weiterentwickelnde Agenten nicht nur darin besteht, wie leistungsfähig das Modell ist oder ob der Algorithmus für bestärkendes Lernen fortschrittlich ist, sondern im Fehlen einer Infrastruktur für online-basiertes bestärkendes Lernen, die echte Agenten unterstützt. AReaL 2.0 ist ein Architektur-Upgrade, das auf die nächste Generation von Agentenanwendungen abzielt: die Verknüpfung von Agentendiensten, realen Aufgabenverläufen, Daten-Governance und Online-Training mit verstärkendem Lernen, wodurch Agenten die praktische technische Grundlage erhalten, um nach der Bereitstellung weiter zu lernen.
Langfristig weist AReaL 2.0 auf das Evolutionsparadigma der nächsten Generation von Agentenanwendungen hin: Agenten sind nicht mehr nur einmalig trainierte und bereitgestellte Werkzeuge, sondern erhalten kontinuierlich Feedback in realen Umgebungen, wandeln sowohl Erfolge als auch Misserfolge in Erfahrungen um und verbessern ihre Fähigkeiten kontinuierlich innerhalb sicherer Grenzen.
Das AReaL-Projekt wurde 2024 von Teams ins Leben gerufen, zu denen unter anderem die Ant Group, die Tsinghua-Universität und die Hong Kong University of Science and Technology gehörten. Im Mai 2026 verließ AReaL offiziell das Inkubationsprogramm „Ant InclusionAI“ und wurde zu einer unabhängigen Open-Source-Community, die sich dem Projekt „PyTorch Foundation Ecosystem“ anschloss und sich damit weiter in das Mainstream-Ökosystem der Infrastruktur für verstärktes Lernen integrierte.
Während sich die Community eigenständig weiterentwickelt, erhält AReaL weiterhin Unterstützung und Beteiligung von Partnern aus der Industrie und dem Open-Source-Ökosystem, darunter das Huawei Cloud-Team und MindLab. Auch in Zukunft wird AReaL seine Arbeit in Bereichen wie Online-Reinforcement-Learning, automatisierte Bewertung und multimodales Agenten-Training fortsetzen und gemeinsam mit der Community die Entwicklung selbstentwickelnder Agenten-Ökosysteme vorantreiben.
Derzeit sind der technische Bericht und der Code zu AReaL 2.0 als Open Source verfügbar.
· GitHub-Repository: https://github.com/areal-project/AReaL
· Technischer Bericht: https://arxiv.org/abs/2607.01120








 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai












