發現高質量的人工智能工具
將全球領先的人工智能工具聚集在一起,以幫助提高工作效率

RogerPerez發表的文章
MiniMax 釋出 H3 多模態模型,將 15 秒 2K 音影片生成成本降至行業標準的三分之一以下
MiniMax 正式釋出了 MiniMax H3,這是一款通用多模態生成模型,旨在統一文字、影象、影片和音訊的理解與創作。透過彌合影片生成任務與模態之間的歷史鴻溝,此次釋出標誌著從專用工具向多功能一體化助手的關鍵轉變。根據官方規格,H3 原生支援雙通道音影片輸出,能夠生成長達 15 秒、解析度為 2K 的內容。早期邀請測試證實了其在指令遵循、品牌敘事以及影片到影片動作遷移等領域的商業級穩定性。該模型已部署於廣告、電子商務、遊戲和 UI 設計等多個領域。在技術層面,H3 利用上下文全表徵(Cont
MiniMax 釋出 M3,一款超越 GPT-5.5 的國產 AI 大模型
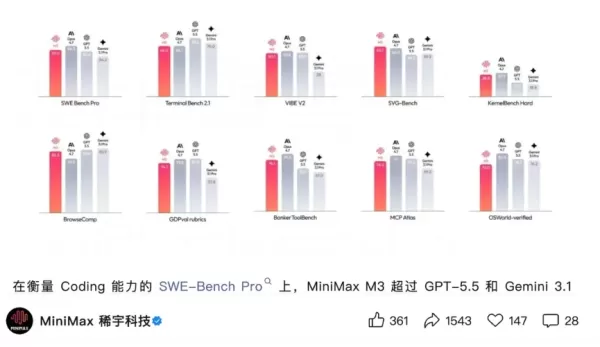
中國的AI領域迎來了重大技術飛躍,隨著稀宇科技(Xiyu Technology)最新大型語言模型MiniMax M3的正式推出。這一先進系統結合了最先進的編碼能力,並支援高達100萬token的超長上下文視窗。值得注意的是,它原生支援多模態輸入,包括影象和影片處理,以及計算機桌面互動,使其成為中國首個整合這三項關鍵能力的開源模型。標準化基準測試中的卓越表現在嚴格的SWE-Bench Pro程式設計評估中,MiniMax M3獲得了59.0%的分數,超越了GPT-5.5和Gemini 3.1 Pro,
崑崙萬維釋出Mureka V9.5:AI音樂從機械編曲轉向以人為本的創作
崑崙萬維正式釋出了 Mureka V9.5,這是其最新的 AI 音樂生成模型。該版本摒棄了行業通常對高產量和高飽和度的追求,轉而強調剋制、細膩和自然感,旨在消除 AI 作曲中的機械感,呈現出具有真實人類溫度和重聽價值的音軌。Mureka V9.5 的核心進步源於其最佳化的 MusiCoT(音樂思維鏈)框架。該模型並非直接生成音訊波形,而是預先構建結構化的音樂邏輯,從宏觀結構到微觀層面的音符表達進行全盤規劃。這種方法使得編曲更加智慧,避免雜亂無章,在遵循人類創作模式、減少重複堆疊的同時,為旋律和情感
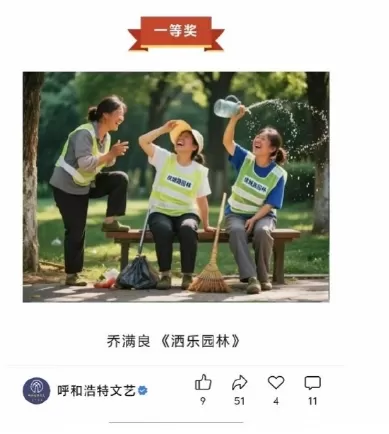
因利用人工智慧偽造三胞胎的面容與文字,呼和浩特攝影比賽首獎遭撤銷
7月14日,內蒙古呼和浩特市文藝界聯合會發布官方聲明,證實一等獎獲獎作品 《園中之帆》,實為人工智慧生成之作品,而非參賽者親自拍攝的原創照片。該公告立即取消該作品的線上及線下參賽、評審及展覽資格,撤銷所有相關比賽榮譽,並正式暫停該雙月攝影比賽。同時,當局已啟動全面整頓程序,並依法對相關責任人進行處置。這場爭議源於近期網友提出的質疑。該比賽由呼和浩特市文藝界聯合會主辦、市攝影家協會承辦,主題為「樂趣
AI驅動的自動冷撥電話:使用Bland AI進行潛在客戶生成
革新潛在客戶生成:使用Python與Bland AI進行AI驅動的冷撥電話在當今競爭激烈的商業環境中,每一秒都至關重要。然而,銷售團隊仍在手動撥號中浪費無數小時,面對一次又一次的拒絕。如果我告訴你有一個更聰明的方法呢? 進入AI驅動的冷撥電話自動化 – 由Python腳本和Bland AI的對話代理處理繁重工作,而你的人力團隊專注於成交。 為什麼傳統冷撥電話已失效我們都看過那些經典的電影場景 –