


 Дом
Университет Цинхуа и компания Tencent Hunyuan победили в конкурсе MoE Inference Challenge в рамках конференции MLSys2026, продемонстрировав 4,1-кратное ускорение работы NPU
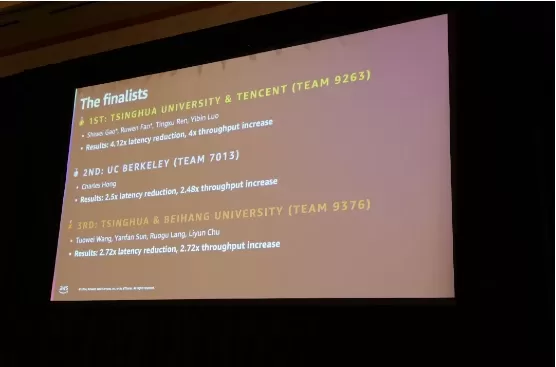
Лаборатория систем хранения данных Университета Цинхуа и команда MegEngine AI Infra компании Tencent недавно завоевали титул мировых чемпионов в конкурсе по оптимизации инференса моделей MoE в рамках MLSys2026 — ведущей конференции по системам машинного обучения.
Чтобы устранить узкие места в производительности инференса в архитектуре «смеси экспертов» (MoE) с триллионным масштабом параметров, работающей на гетерогенных чипах NPU, совместная команда разработала решение по оптимизации всего цепочки для официальной модели и аппаратного обеспечения NPU. Благодаря применению стратегии E-Shard для разбиения задач на уровне экспертов, пакетного считывания 3D-тензоров PSUM, алгоритма GEMV, распределяющего выходные данные по нескольким банкам для обеспечения параллелизма, а также использования скалярных движков для сокращения задержки при первоначальной передаче данных, команде удалось успешно устранить низкую эффективность передачи данных и повторяющиеся передачи активаций на уровне операторов.
Параллельно с этим команда реорганизовала расположение данных на кристалле для модуля внимания и интегрировала основные операторы Transformer, обеспечив высокоточное выравнивание на битовом уровне.
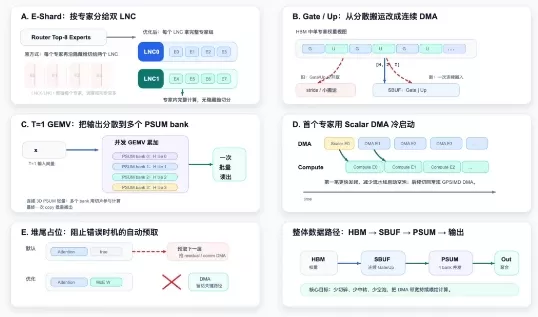
Рисунок 3: Схема архитектуры оптимизации MoE, включающей экспертное разбиение E-Shard, непрерывный DMA, параллелизм PSUM/GEMV, конвейер «холодного запуска» и управление предварительной выборкой.
Кроме того, команда разработала агент-ориентированный оптимизатор операторов инференса под названием «Knight». Благодаря автоматизированному процессу с обратной связью, включающему выдвижение предложений, реализацию кода и итерации, удалось значительно расширить пространство поиска оптимизаций. В результате время сквозного вывода сократилось с 14,91 секунды до 3,56 секунды, что соответствует 4,1-кратному ускорению; задержка одношагового декодирования сократилась с 12,63 мс до 5,45 мс, а загрузка DMA-движка при загрузке весов выросла примерно до 80 %.
Превзойдя команды из ведущих мировых университетов, таких как Стэнфорд и Массачусетский технологический институт (MIT), это достижение подчеркивает глубокую экспертизу китайских команд в адаптации крупных моделей к базовым системам и оптимизации операторов. Оно также предоставляет ценный инженерный план для развертывания моделей MoE с триллионами параметров на будущих вычислительных платформах на базе суперузлов.
Связанная статья
 Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,
Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Рекомендации по связанным специальным темам
SEO
 Лучшие инструменты для анализа результатов поиска с помощью ИИ при разработке поисковой стратегии
XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
 13 инструментов
 xix.ai
Анализ данных
Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

 Комментарии (1)
![BrianMartinez]()
That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉
Лаборатория систем хранения данных Университета Цинхуа и команда MegEngine AI Infra компании Tencent недавно завоевали титул мировых чемпионов в конкурсе по оптимизации инференса моделей MoE в рамках MLSys2026 — ведущей конференции по системам машинного обучения.
Чтобы устранить узкие места в производительности инференса в архитектуре «смеси экспертов» (MoE) с триллионным масштабом параметров, работающей на гетерогенных чипах NPU, совместная команда разработала решение по оптимизации всего цепочки для официальной модели и аппаратного обеспечения NPU. Благодаря применению стратегии E-Shard для разбиения задач на уровне экспертов, пакетного считывания 3D-тензоров PSUM, алгоритма GEMV, распределяющего выходные данные по нескольким банкам для обеспечения параллелизма, а также использования скалярных движков для сокращения задержки при первоначальной передаче данных, команде удалось успешно устранить низкую эффективность передачи данных и повторяющиеся передачи активаций на уровне операторов.
Параллельно с этим команда реорганизовала расположение данных на кристалле для модуля внимания и интегрировала основные операторы Transformer, обеспечив высокоточное выравнивание на битовом уровне.
Рисунок 3: Схема архитектуры оптимизации MoE, включающей экспертное разбиение E-Shard, непрерывный DMA, параллелизм PSUM/GEMV, конвейер «холодного запуска» и управление предварительной выборкой.
Кроме того, команда разработала агент-ориентированный оптимизатор операторов инференса под названием «Knight». Благодаря автоматизированному процессу с обратной связью, включающему выдвижение предложений, реализацию кода и итерации, удалось значительно расширить пространство поиска оптимизаций. В результате время сквозного вывода сократилось с 14,91 секунды до 3,56 секунды, что соответствует 4,1-кратному ускорению; задержка одношагового декодирования сократилась с 12,63 мс до 5,45 мс, а загрузка DMA-движка при загрузке весов выросла примерно до 80 %.
Превзойдя команды из ведущих мировых университетов, таких как Стэнфорд и Массачусетский технологический институт (MIT), это достижение подчеркивает глубокую экспертизу китайских команд в адаптации крупных моделей к базовым системам и оптимизации операторов. Оно также предоставляет ценный инженерный план для развертывания моделей MoE с триллионами параметров на будущих вычислительных платформах на базе суперузлов.








 Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
 Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три

XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉












