


 Дом
Запущена система «Tongyi Qianwen Qwen-Audio-3.0-TTS» с задержкой первого пакета 300 мс и поддержкой 20 диалектов
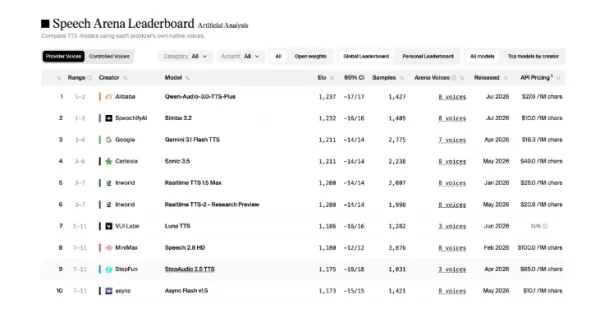
Команда Alibaba Qwen представила новую модель синтеза речи в реальном времени Qwen-Audio-3.0-TTS, благодаря которой синтез речи перешел от простого воспроизведения к подлинной экспрессии. Версия Plus теперь занимает первое место в мире в рейтинге Speech Arena — авторитетном тесте от Artificial Analysis — опередив Gemini 3.1 TTS, ElevenLabs v3 и другие ведущие модели.
Доступны две версии: версия Flash предназначена для взаимодействия в режиме реального времени с начальной задержкой около 300 мс, что идеально подходит для умных помощников и других сценариев использования, требующих низкой задержки; версия Plus ориентирована на высокое качество генерации, обеспечивая повышенную естественность и сходство голоса.
Четыре ключевых прорыва в основных возможностях:
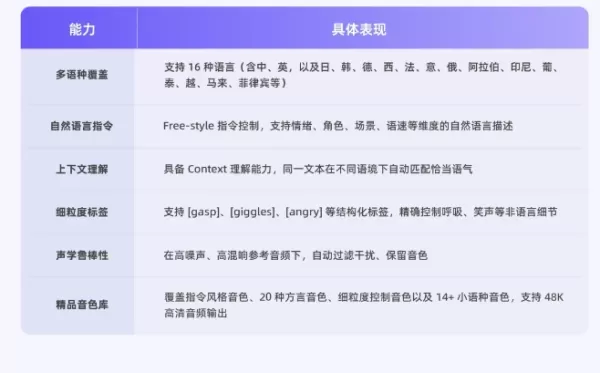
Во-первых, поддержка нескольких языков и диалектов была расширена до 16 языков, при этом версия Plus достигает среднего показателя сходства с реальным говорящим на уровне 82,75% по всем 16 языкам — это самый высокий показатель в отрасли. Она также охватывает 20 китайских диалектов, сохраняя аутентичные диалектные особенности, а не ослабляя их, что позволяет добиться более естественных выражений.
Во-вторых, гибкие инструкции на естественном языке позволяют пользователям генерировать точную речь с помощью подсказок, таких как «мягкий тон обслуживания клиентов» или «стиль ведущего прямой трансляции», без необходимости профессиональных аннотаций.
В-третьих, тонкое управление тегами поддерживает структурированные теги, такие как [вздох] и [злость], что позволяет точно управлять невербальными деталями, такими как дыхание и смех, — что подходит для игр, аудиокниг и подобных сценариев.
В-четвертых, высокая акустическая устойчивость: даже если исходный аудиофайл содержит сильный шум или реверберацию, модель автоматически отфильтровывает фоновый шум, сохраняя при этом качество голоса, что обеспечивает стабильный результат синтеза.
Входящая в комплект премиум-библиотека голосов включает различные типы голосов — инструкции, диалекты и редко используемые языки — поддерживает вывод звука высокой четкости 48K (запуск ожидается 24 июля) и может синтезировать до 3 минут длинного текста за сеанс. Модель теперь полностью доступна на платформе Alibaba Cloud BaiLian, где разработчики могут получить к ней доступ и опробовать её, что открывает новые возможности в области голосового взаимодействия.
Связанная статья
 ByteDance’s Seed запускает глобальную кампанию по набору сотрудников в кампусах, предлагая виртуальные акции для привлечения лучших специалистов по крупным языковым моделям
В условиях конкурентной борьбы крупных языковых моделей привлечение высококвалифицированных специалистов остается самым важным стратегическим активом.1 апреля ByteDance объявил о запуске глобальной программы набора на кампусы Seed, являющейся частью
Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,
Рекомендации по связанным специальным темам
Дизайн и искусство
 Инструменты искусственного интеллекта для создания визуальных стилей, предназначенные для создания характеристик персонажей, мудбордов и презентаций
2026: лучшие современные инструменты на базе ИИ для создания визуальных стилей персонажей, мудбордов и презентаций — уже доступны на XIX.AI! В этом тщательно подобранном списке самых высокооцененных инструментов представлены мощные решения, способные кардинально изменить ваш подход к работе и прошедшие строгие тесты в реальных условиях. Здесь вы найдёте сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы повысить творческий потенциал и оптимизировать рабочий процесс. Ознакомьтесь с ним прямо сейчас, чтобы найти идеальный инструмент для повышения продуктивности!
 11 инструментов
 xix.ai
SEO
Лучшие инструменты для анализа результатов поиска с помощью ИИ при разработке поисковой стратегии
XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai
Анализ данных
Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

 Комментарии (0)
Команда Alibaba Qwen представила новую модель синтеза речи в реальном времени Qwen-Audio-3.0-TTS, благодаря которой синтез речи перешел от простого воспроизведения к подлинной экспрессии. Версия Plus теперь занимает первое место в мире в рейтинге Speech Arena — авторитетном тесте от Artificial Analysis — опередив Gemini 3.1 TTS, ElevenLabs v3 и другие ведущие модели.
Доступны две версии: версия Flash предназначена для взаимодействия в режиме реального времени с начальной задержкой около 300 мс, что идеально подходит для умных помощников и других сценариев использования, требующих низкой задержки; версия Plus ориентирована на высокое качество генерации, обеспечивая повышенную естественность и сходство голоса.
Четыре ключевых прорыва в основных возможностях:
Во-первых, поддержка нескольких языков и диалектов была расширена до 16 языков, при этом версия Plus достигает среднего показателя сходства с реальным говорящим на уровне 82,75% по всем 16 языкам — это самый высокий показатель в отрасли. Она также охватывает 20 китайских диалектов, сохраняя аутентичные диалектные особенности, а не ослабляя их, что позволяет добиться более естественных выражений.
Во-вторых, гибкие инструкции на естественном языке позволяют пользователям генерировать точную речь с помощью подсказок, таких как «мягкий тон обслуживания клиентов» или «стиль ведущего прямой трансляции», без необходимости профессиональных аннотаций.
В-третьих, тонкое управление тегами поддерживает структурированные теги, такие как [вздох] и [злость], что позволяет точно управлять невербальными деталями, такими как дыхание и смех, — что подходит для игр, аудиокниг и подобных сценариев.
В-четвертых, высокая акустическая устойчивость: даже если исходный аудиофайл содержит сильный шум или реверберацию, модель автоматически отфильтровывает фоновый шум, сохраняя при этом качество голоса, что обеспечивает стабильный результат синтеза.
Входящая в комплект премиум-библиотека голосов включает различные типы голосов — инструкции, диалекты и редко используемые языки — поддерживает вывод звука высокой четкости 48K (запуск ожидается 24 июля) и может синтезировать до 3 минут длинного текста за сеанс. Модель теперь полностью доступна на платформе Alibaba Cloud BaiLian, где разработчики могут получить к ней доступ и опробовать её, что открывает новые возможности в области голосового взаимодействия.








 ByteDance’s Seed запускает глобальную кампанию по набору сотрудников в кампусах, предлагая виртуальные акции для привлечения лучших специалистов по крупным языковым моделям
В условиях конкурентной борьбы крупных языковых моделей привлечение высококвалифицированных специалистов остается самым важным стратегическим активом.1 апреля ByteDance объявил о запуске глобальной программы набора на кампусы Seed, являющейся частью
 Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
 Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,

2026: лучшие современные инструменты на базе ИИ для создания визуальных стилей персонажей, мудбордов и презентаций — уже доступны на XIX.AI! В этом тщательно подобранном списке самых высокооцененных инструментов представлены мощные решения, способные кардинально изменить ваш подход к работе и прошедшие строгие тесты в реальных условиях. Здесь вы найдёте сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы повысить творческий потенциал и оптимизировать рабочий процесс. Ознакомьтесь с ним прямо сейчас, чтобы найти идеальный инструмент для повышения продуктивности!
11 инструментов
xix.ai

XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai












