


 Дом
Графовые конволюционные сети революционизируют обучение в базах данных графов
В нашем все более взаимосвязанном цифровом ландшафте графовые технологии открывают беспрецедентные возможности. Графовые базы данных революционизируют способы хранения данных, богатых связями, а графовые сверточные сети (GCN) преобразуют способы анализа этих сложных связей. В этой статье рассматривается мощное пересечение этих технологий, демонстрирующее, как обучение GCN в базе данных ускоряет предиктивную аналитику, сохраняя целостность данных. Узнайте о практических стратегиях внедрения, измеримых преимуществах производительности и реальных приложениях из нашего комплексного тематического исследования.
Ключевые моменты
Графовые базы данных оптимизируют хранение и производительность запросов для взаимосвязанных наборов данных.
GCN используют топологию графов для повышения точности машинного обучения по сравнению с традиционными методами.
Обучение в базе данных позволяет отказаться от дорогостоящей передачи данных между системами.
Встроенная обработка графов позволяет непрерывно уточнять модели на основе свежих данных.
Архитектура TigerGraph уникальным образом поддерживает масштабируемые реализации GCN в базе данных.
Понятие графовых конволюционных сетей и баз данных графов
Что такое графовая конволюционная сеть (GCN)?

Графовые конволюционные сети представляют собой нейронную архитектуру, специально разработанную для реляционных структур данных. В то время как обычные нейронные сети обрабатывают входные данные на основе сетки (изображения) или последовательности (текст), GCN напрямую оперируют топологией графов, сохраняя и используя шаблоны связей в процессе обучения. Эти сети постепенно агрегируют информацию о соседях с помощью локализованных операций, генерируя сложные вкрапления узлов, которые кодируют как внутренние атрибуты, так и контекстуальные связи.
Их архитектура оказывается особенно эффективной для анализа социальных сетей, молекулярных исследований, рекомендательных систем и приложений с графами знаний, где контекст отношений существенно влияет на результаты. Благодаря итеративной передаче сообщений между связанными узлами, GCN превосходят традиционные алгоритмы, улавливая динамику сети более высокого порядка и обеспечивая более точные предсказания благодаря выученным представлениям, а не созданным вручную характеристикам.
Что такое графовая база данных?
В отличие от табличных баз данных, в графовых базах данных используются структуры "узел-край-узел", которые в полной мере отражают реальные отношения. Сущности становятся узлами, а их связи проявляются в виде ребер, создавая интуитивно понятные модели данных, которые позволяют эффективно просматривать отношения без сложных объединений. Такая архитектура обеспечивает превосходную производительность при выявлении мошенничества, составлении схем цепочек поставок, сетевом анализе и рекомендательных системах, где модели отношений определяют ценность бизнеса.
Явное представление связей позволяет графовым базам данных органично развиваться, принимая новые типы отношений и модификации схемы без дорогостоящей миграции. Эффективность их запросов растет линейно, а не экспоненциально с увеличением сложности отношений, что делает их незаменимыми для современных приложений, использующих связанные данные. Продвинутые системы, такие как TigerGraph, еще больше расширяют эти возможности за счет параллельной обработки и аналитики в реальном времени.
Зачем обучать GCN на базе графических данных?
Объединение обучения GCN с операциями в базе данных графов дает несколько стратегических преимуществ: Упрощенные конвейеры обработки данных устраняют накладные расходы на преобразование, собственные графовые операторы ускоряют вычисления, а обновления в реальном времени поддерживают актуальность модели - и все это в единой среде. Такая архитектурная синергия значительно снижает сложность инфраструктуры, повышая производительность моделей на изменяющихся наборах данных.
Ключевые преимущества обучения GCN в базе данных графов
Сокращение объемов перемещения данных
Традиционные архитектуры аналитики страдают от дорогостоящих операций извлечения-трансформирования-загрузки между средами хранения и вычислений. Обучение в базе данных устраняет эти узкие места, сохраняя петабайты графовых данных на месте, позволяя вычислениям происходить там, где находится информация, а не передавать ее по сетям.
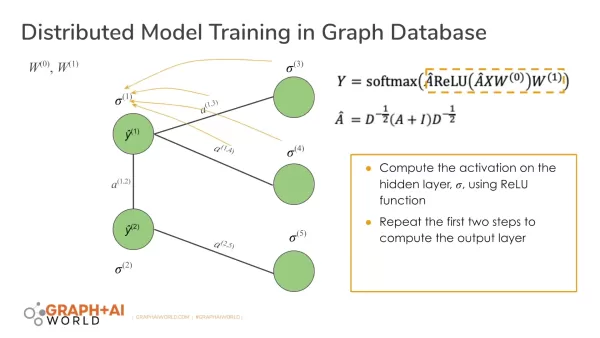
Такая локализованная обработка сокращает время ожидания на порядки, сводя к минимуму дублирование данных в хранилищах, что имеет решающее значение при обучении на обширных графах знаний или динамических социальных сетях, где терабайты данных могут быть взаимосвязаны.
Повышенная производительность
Графовые базы данных используют специализированные индексы и алгоритмы обхода, оптимизированные для шаблонов соединений, которые традиционные индексы поддерживают плохо. Используя эти собственные оптимизации во время обучения, GCN достигают высокой пропускной способности, что особенно важно при выполнении шагов агрегирования окрестностей, которые являются основой обучения графов. Архитектуры распределенных графов еще больше расширяют эти преимущества в горизонтальном направлении.
Обновление моделей в режиме реального времени
Динамичные среды требуют моделей, которые развиваются вместе с источниками данных. Конвейеры обучения в базе данных обеспечивают непрерывный процесс обучения - автоматическое включение новых узлов, ребер и атрибутов без полного переобучения. Это неоценимо для финансового наблюдения, сетей IoT и рекомендательных систем, где дрейф концепций влияет на достоверность модели.
Упрощенная инфраструктура
Содержание отдельных аналитических и операционных систем создает архитектурную сложность и проблемы синхронизации. Интегрированные платформы консолидируют хранение, обработку и машинное обучение графов, снижая административные издержки и повышая эффективность использования ресурсов за счет совместного использования вычислительных ресурсов.
Обучение GCN в TigerGraph
Хранение данных и создание графов
Подход TigerGraph, основанный на использовании схем, обеспечивает правильное моделирование отношений в домене еще до поступления данных. Гибкие определения вершин и ребер позволяют создавать сложные графы свойств - будь то моделирование биомедицинских взаимодействий, сетей цепочек поставок или цифровых двойников.
Реализация GCN
Полноценный по Тьюрингу язык GSQL в TigerGraph поддерживает реализацию сложных нейронных архитектур, включая механизмы внимания и стратегии выборки - и все это с использованием оптимизированных возможностей базы данных по хранению и параллельной обработке данных.
Обучение и прогнозирование
Механизм распределенных запросов обрабатывает как пакетные, так и потоковые обновления графов, что позволяет использовать все возможности от разработки моделей в автономном режиме до сценариев онлайн-обучения. Производственные развертывания выигрывают от высокой доступности TigerGraph при сохранении миллисекундной задержки.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Какие типы данных подходят для GCN в графовых базах данных?
GCN обеспечивают исключительную ценность для рекомендательных систем, биологических сетей, графов кибербезопасности и других областей, где взаимосвязи содержат прогностические сигналы, которые традиционная инженерия признаков не в состоянии уловить.
Каковы трудности обучения GCN в базе данных графов?
Эффективная реализация требует сочетания графовых алгоритмов с опытом нейронной архитектуры. Планирование ресурсов приобретает решающее значение при работе с графами с миллиардными границами, хотя распределенные архитектуры снижают эти проблемы.
В чем преимущества использования TigerGraph для обучения GCN?
Архитектура параллельной обработки TigerGraph обеспечивает линейную масштабируемость при сохранении гарантий ACID - уникальная поддержка как транзакционных, так и аналитических рабочих нагрузок на массивных графах.
Связанные вопросы
Как GCN сравнивают с другими методами машинного обучения на основе графов?
В отличие от неглубоких вкраплений или созданных вручную признаков, GCN изучают адаптивные представления, настроенные на локальные и глобальные структуры графов, и часто достигают более высокой точности за счет автоматического изучения признаков.
Каково будущее GCN и баз данных графов?
Слияние графовых баз данных и дифференцируемого программирования обещает трансформацию приложений - от обнаружения мошенничества в реальном времени до автоматизации научных открытий - по мере развития этих технологий.
Связанная статья
 Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в
Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
 9 инструментов
 xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai
Образование и обучение
Платформы для создания викторин с ИИ для учителей, репетиторов и программ обучения в группах
2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai
код
Инструменты на базе ИИ для проверки пулл-реквестов в командах GitHub, занимающихся рефакторингом, устранением ошибок и устранением уязвимостей
2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

 Комментарии (4)
![EricAllen]()
Graph-Datenbanken sind ja schon länger im Gespräch, aber dass jetzt auch noch GCNs dazukommen... das wird echt spannend! 😅 Ich frage mich, ob das in der Praxis schon stabil läuft oder ob da noch viel Forschungsarbeit nötig ist. Die Kombination klingt auf jeden Fall nach einem mächtigen Werkzeug für Netzwerkanalysen oder Empfehlungssysteme.
![GregoryAdams]()
이 기사가 요즘 뜨는 GNN에 대한 이야기네요. 제 전공 외에서는 '그래프'하면 차트(chart)를 떠올리던 친구들이 많아서, '인사이트를 발견하는 방식 자체를 바꾼다'는 설명이 와닿아요. 실제로 추천 시스템에서 얼마나 효과가 좋은지 궁금하네요. 기술 발전 속도에 조금 뒤쳐지는 느낌? 😅
![WilliamMiller]()
Finalmente algo que explica GCN de forma clara! Sempre tive dificuldade em entender como redes neurais aplicam em dados relacionais. Alguém já testou isso com dados de redes sociais? Será que detecta comunidades fake? 🤔
![RogerSanchez]()
이런 기술 발전이 실제 업계에서 어떻게 적용될지 상상을 해보니 정말 흥미롭네요. 특히 소셜 네트워크나 추천 시스템에서 어떤 변화를 가져올지 궁금해요. 근데 데이터 프라이버시 문제는 어떻게 해결할까요? 🤔
В нашем все более взаимосвязанном цифровом ландшафте графовые технологии открывают беспрецедентные возможности. Графовые базы данных революционизируют способы хранения данных, богатых связями, а графовые сверточные сети (GCN) преобразуют способы анализа этих сложных связей. В этой статье рассматривается мощное пересечение этих технологий, демонстрирующее, как обучение GCN в базе данных ускоряет предиктивную аналитику, сохраняя целостность данных. Узнайте о практических стратегиях внедрения, измеримых преимуществах производительности и реальных приложениях из нашего комплексного тематического исследования.
Ключевые моменты
Графовые базы данных оптимизируют хранение и производительность запросов для взаимосвязанных наборов данных.
GCN используют топологию графов для повышения точности машинного обучения по сравнению с традиционными методами.
Обучение в базе данных позволяет отказаться от дорогостоящей передачи данных между системами.
Встроенная обработка графов позволяет непрерывно уточнять модели на основе свежих данных.
Архитектура TigerGraph уникальным образом поддерживает масштабируемые реализации GCN в базе данных.
Понятие графовых конволюционных сетей и баз данных графов
Что такое графовая конволюционная сеть (GCN)?
Графовые конволюционные сети представляют собой нейронную архитектуру, специально разработанную для реляционных структур данных. В то время как обычные нейронные сети обрабатывают входные данные на основе сетки (изображения) или последовательности (текст), GCN напрямую оперируют топологией графов, сохраняя и используя шаблоны связей в процессе обучения. Эти сети постепенно агрегируют информацию о соседях с помощью локализованных операций, генерируя сложные вкрапления узлов, которые кодируют как внутренние атрибуты, так и контекстуальные связи.
Их архитектура оказывается особенно эффективной для анализа социальных сетей, молекулярных исследований, рекомендательных систем и приложений с графами знаний, где контекст отношений существенно влияет на результаты. Благодаря итеративной передаче сообщений между связанными узлами, GCN превосходят традиционные алгоритмы, улавливая динамику сети более высокого порядка и обеспечивая более точные предсказания благодаря выученным представлениям, а не созданным вручную характеристикам.
Что такое графовая база данных?
В отличие от табличных баз данных, в графовых базах данных используются структуры "узел-край-узел", которые в полной мере отражают реальные отношения. Сущности становятся узлами, а их связи проявляются в виде ребер, создавая интуитивно понятные модели данных, которые позволяют эффективно просматривать отношения без сложных объединений. Такая архитектура обеспечивает превосходную производительность при выявлении мошенничества, составлении схем цепочек поставок, сетевом анализе и рекомендательных системах, где модели отношений определяют ценность бизнеса.
Явное представление связей позволяет графовым базам данных органично развиваться, принимая новые типы отношений и модификации схемы без дорогостоящей миграции. Эффективность их запросов растет линейно, а не экспоненциально с увеличением сложности отношений, что делает их незаменимыми для современных приложений, использующих связанные данные. Продвинутые системы, такие как TigerGraph, еще больше расширяют эти возможности за счет параллельной обработки и аналитики в реальном времени.
Зачем обучать GCN на базе графических данных?
Объединение обучения GCN с операциями в базе данных графов дает несколько стратегических преимуществ: Упрощенные конвейеры обработки данных устраняют накладные расходы на преобразование, собственные графовые операторы ускоряют вычисления, а обновления в реальном времени поддерживают актуальность модели - и все это в единой среде. Такая архитектурная синергия значительно снижает сложность инфраструктуры, повышая производительность моделей на изменяющихся наборах данных.
Ключевые преимущества обучения GCN в базе данных графов
Сокращение объемов перемещения данных
Традиционные архитектуры аналитики страдают от дорогостоящих операций извлечения-трансформирования-загрузки между средами хранения и вычислений. Обучение в базе данных устраняет эти узкие места, сохраняя петабайты графовых данных на месте, позволяя вычислениям происходить там, где находится информация, а не передавать ее по сетям.
Такая локализованная обработка сокращает время ожидания на порядки, сводя к минимуму дублирование данных в хранилищах, что имеет решающее значение при обучении на обширных графах знаний или динамических социальных сетях, где терабайты данных могут быть взаимосвязаны.
Повышенная производительность
Графовые базы данных используют специализированные индексы и алгоритмы обхода, оптимизированные для шаблонов соединений, которые традиционные индексы поддерживают плохо. Используя эти собственные оптимизации во время обучения, GCN достигают высокой пропускной способности, что особенно важно при выполнении шагов агрегирования окрестностей, которые являются основой обучения графов. Архитектуры распределенных графов еще больше расширяют эти преимущества в горизонтальном направлении.
Обновление моделей в режиме реального времени
Динамичные среды требуют моделей, которые развиваются вместе с источниками данных. Конвейеры обучения в базе данных обеспечивают непрерывный процесс обучения - автоматическое включение новых узлов, ребер и атрибутов без полного переобучения. Это неоценимо для финансового наблюдения, сетей IoT и рекомендательных систем, где дрейф концепций влияет на достоверность модели.
Упрощенная инфраструктура
Содержание отдельных аналитических и операционных систем создает архитектурную сложность и проблемы синхронизации. Интегрированные платформы консолидируют хранение, обработку и машинное обучение графов, снижая административные издержки и повышая эффективность использования ресурсов за счет совместного использования вычислительных ресурсов.
Обучение GCN в TigerGraph
Хранение данных и создание графов
Подход TigerGraph, основанный на использовании схем, обеспечивает правильное моделирование отношений в домене еще до поступления данных. Гибкие определения вершин и ребер позволяют создавать сложные графы свойств - будь то моделирование биомедицинских взаимодействий, сетей цепочек поставок или цифровых двойников.
Реализация GCN
Полноценный по Тьюрингу язык GSQL в TigerGraph поддерживает реализацию сложных нейронных архитектур, включая механизмы внимания и стратегии выборки - и все это с использованием оптимизированных возможностей базы данных по хранению и параллельной обработке данных.
Обучение и прогнозирование
Механизм распределенных запросов обрабатывает как пакетные, так и потоковые обновления графов, что позволяет использовать все возможности от разработки моделей в автономном режиме до сценариев онлайн-обучения. Производственные развертывания выигрывают от высокой доступности TigerGraph при сохранении миллисекундной задержки.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Какие типы данных подходят для GCN в графовых базах данных?
GCN обеспечивают исключительную ценность для рекомендательных систем, биологических сетей, графов кибербезопасности и других областей, где взаимосвязи содержат прогностические сигналы, которые традиционная инженерия признаков не в состоянии уловить.
Каковы трудности обучения GCN в базе данных графов?
Эффективная реализация требует сочетания графовых алгоритмов с опытом нейронной архитектуры. Планирование ресурсов приобретает решающее значение при работе с графами с миллиардными границами, хотя распределенные архитектуры снижают эти проблемы.
В чем преимущества использования TigerGraph для обучения GCN?
Архитектура параллельной обработки TigerGraph обеспечивает линейную масштабируемость при сохранении гарантий ACID - уникальная поддержка как транзакционных, так и аналитических рабочих нагрузок на массивных графах.
Связанные вопросы
Как GCN сравнивают с другими методами машинного обучения на основе графов?
В отличие от неглубоких вкраплений или созданных вручную признаков, GCN изучают адаптивные представления, настроенные на локальные и глобальные структуры графов, и часто достигают более высокой точности за счет автоматического изучения признаков.
Каково будущее GCN и баз данных графов?
Слияние графовых баз данных и дифференцируемого программирования обещает трансформацию приложений - от обнаружения мошенничества в реальном времени до автоматизации научных открытий - по мере развития этих технологий.








 Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в
 Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
 Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai

2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

Graph-Datenbanken sind ja schon länger im Gespräch, aber dass jetzt auch noch GCNs dazukommen... das wird echt spannend! 😅 Ich frage mich, ob das in der Praxis schon stabil läuft oder ob da noch viel Forschungsarbeit nötig ist. Die Kombination klingt auf jeden Fall nach einem mächtigen Werkzeug für Netzwerkanalysen oder Empfehlungssysteme.
이 기사가 요즘 뜨는 GNN에 대한 이야기네요. 제 전공 외에서는 '그래프'하면 차트(chart)를 떠올리던 친구들이 많아서, '인사이트를 발견하는 방식 자체를 바꾼다'는 설명이 와닿아요. 실제로 추천 시스템에서 얼마나 효과가 좋은지 궁금하네요. 기술 발전 속도에 조금 뒤쳐지는 느낌? 😅
Finalmente algo que explica GCN de forma clara! Sempre tive dificuldade em entender como redes neurais aplicam em dados relacionais. Alguém já testou isso com dados de redes sociais? Será que detecta comunidades fake? 🤔
이런 기술 발전이 실제 업계에서 어떻게 적용될지 상상을 해보니 정말 흥미롭네요. 특히 소셜 네트워크나 추천 시스템에서 어떤 변화를 가져올지 궁금해요. 근데 데이터 프라이버시 문제는 어떻게 해결할까요? 🤔












