


 Дом
AntGroup открыла исходный код LingBot-Video — первой базовой модели для обработки видео, предназначенной для интеллекта с воплощением
9 июля компания Ant Group открыла исходный код LingBot-Video — первой в мире базовой модели с открытым исходным кодом для генерации видео, построенной на архитектуре «смеси экспертов» (Mixture-of-Experts, MoE) и специально разработанной для воплощенного интеллекта. Эта модель переосмысливает процесс предварительного обучения с использованием видео, ориентируясь на основные потребности роботов и воплощённого интеллекта, что обеспечивает систематическое повышение эффективности рассуждений, физической правдоподобности, понимания действий и выполнения задач. Она предлагает новую базу с открытым исходным кодом для базовых моделей видео, позволяющую выйти за рамки создания цифрового контента и перейти к воплощённому интеллекту.
В тесте RBench, совместно разработанном Пекинским университетом и ByteDance, LingBot-Video набрал 0,620 балла, превзойдя Wan2.6 (0,607), Seedance1.5Pro (0,584) и Cosmos3Super (0,581). RBench — комплексный тестовый набор для оценки видеороликов с робототехническими манипуляциями — специально предназначен для определения способности модели генерировать поведение роботов, соответствующее законам физики реального мира. Этот результат свидетельствует о том, что LingBot-Video лучше сохраняет рациональность действий и целостность выполнения задач при генерации видеороликов, связанных с роботами.
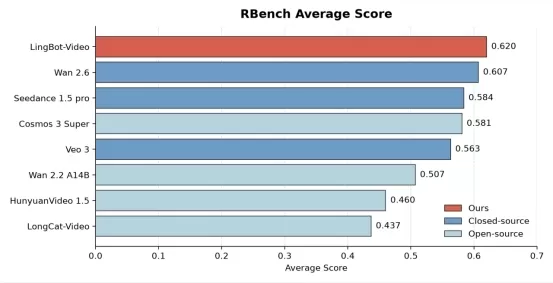
(Подпись к рисунку: LingBot-Video демонстрирует лучшие результаты в тесте RBench)
Чтобы дополнительно проверить способность LingBot-Video моделировать изменения в физическом мире, Ant Group провела его оценку на внутреннем тестовом наборе данных по двум параметрам: общее качество и конкретная область применения. Результаты показывают, что по сравнению с пятью моделями с открытым исходным кодом — NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 и LTX-2.3 — LingBot-Video превосходит основные базовые модели в области воплощённых сценариев.
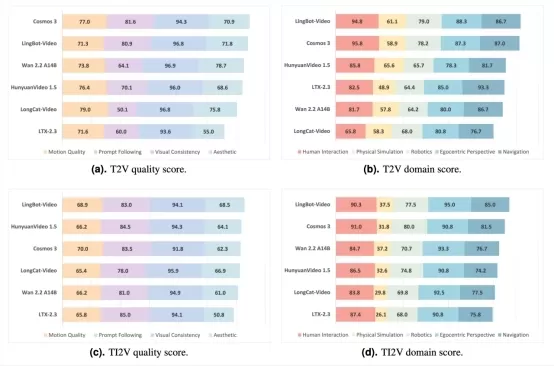
(Подпись к рисунку: Комплексная оценка показывает, что LingBot-Video демонстрирует более глубокое понимание физических явлений и согласованность действий в сценариях с воплощенным интеллектом)
В последние годы модели генерации видео быстро совершенствовались в плане визуального качества, плавности и творческого выражения. Однако для воплощенного интеллекта видео, которое выглядит реалистично и плавно, может не отражать реальные законы физики, что затрудняет поддержку непрерывного прогнозирования, планирования и выполнения задач для роботов. В то же время воплощённый интеллект также требует более высокой эффективности рассуждений для адаптации к взаимодействию в реальном времени и циклам управления.
Это побудило сферу генерации видео развиваться по двум различным направлениям: одно — в сторону кинематографа, служащего созданию контента; другое — в сторону робототехники, служащее пониманию, прогнозированию и взаимодействию с физическим миром. LingBot-Video представляет собой значительное исследование Ant Group, направленное на поиск нового пути генерации видео, адаптированного к воплощённому интеллекту.
LingBot-Video представляет собой систематические инновации в области архитектуры, данных и обучения.
С архитектурной точки зрения LingBot-Video использует схему DiT + MoE, заменяя традиционные плотные архитектуры на MoE. Это позволяет модели масштабировать мощность, сохраняя при этом управляемые затраты на вычисления при инференсе. Имея 30 миллиардов параметров, модель активирует лишь около 3 миллиардов во время генерации, обеспечивая примерно в три раза более высокую эффективность вывода по сравнению с плотной архитектурой того же размера. Такая конструкция придает модели визуальную выразительность за счет большого количества параметров, одновременно лучше отвечая требованиям эффективности воплощённого интеллекта.
Что касается данных, для LingBot-Video был создан механизм профилирования данных, объединяющий данные, связанные с роботами, такие как VLA, VLN и Ego, на основе обширных интернет-видео, охватывающих сценарии, включая ловкие манипуляции, мобильность роботов и взаимодействия от первого лица, что в сумме составляет 70 000 часов данных, отражающих реальные действия. Эти данные помогают модели изучать взаимосвязь между действиями и изменениями окружающей среды, а не просто поверхностную текстуру и визуальный стиль видео.
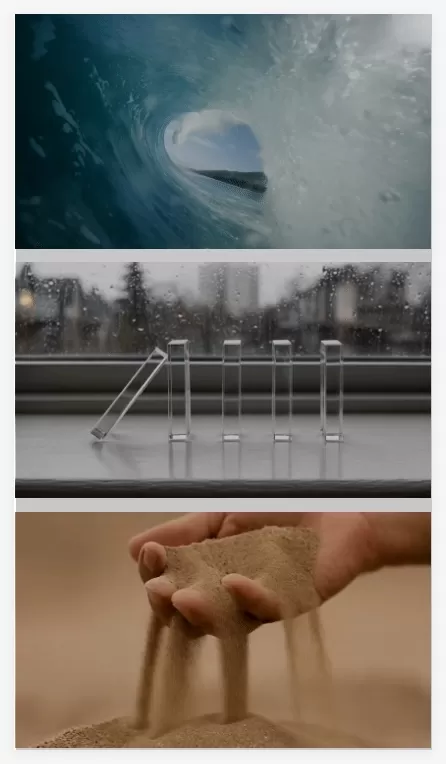
В процессе обучения в LingBot-Video была внедрена многомерная система вознаграждений для обучения с подкреплением. Помимо традиционных метрик, таких как эстетика, следование подсказкам и согласованность движений, модель также учитывает физическую правдоподобность и выполнение задач, благодаря чему сгенерированные результаты в большей степени соответствуют законам физики реального мира и ближе к потребностям роботов, выполняющих задачи в реальных условиях.
Связанная статья
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны
Рекомендации по связанным специальным темам
письмо
 Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
 8 инструментов
 xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

 Комментарии (0)
9 июля компания Ant Group открыла исходный код LingBot-Video — первой в мире базовой модели с открытым исходным кодом для генерации видео, построенной на архитектуре «смеси экспертов» (Mixture-of-Experts, MoE) и специально разработанной для воплощенного интеллекта. Эта модель переосмысливает процесс предварительного обучения с использованием видео, ориентируясь на основные потребности роботов и воплощённого интеллекта, что обеспечивает систематическое повышение эффективности рассуждений, физической правдоподобности, понимания действий и выполнения задач. Она предлагает новую базу с открытым исходным кодом для базовых моделей видео, позволяющую выйти за рамки создания цифрового контента и перейти к воплощённому интеллекту.
В тесте RBench, совместно разработанном Пекинским университетом и ByteDance, LingBot-Video набрал 0,620 балла, превзойдя Wan2.6 (0,607), Seedance1.5Pro (0,584) и Cosmos3Super (0,581). RBench — комплексный тестовый набор для оценки видеороликов с робототехническими манипуляциями — специально предназначен для определения способности модели генерировать поведение роботов, соответствующее законам физики реального мира. Этот результат свидетельствует о том, что LingBot-Video лучше сохраняет рациональность действий и целостность выполнения задач при генерации видеороликов, связанных с роботами.
(Подпись к рисунку: LingBot-Video демонстрирует лучшие результаты в тесте RBench)
Чтобы дополнительно проверить способность LingBot-Video моделировать изменения в физическом мире, Ant Group провела его оценку на внутреннем тестовом наборе данных по двум параметрам: общее качество и конкретная область применения. Результаты показывают, что по сравнению с пятью моделями с открытым исходным кодом — NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 и LTX-2.3 — LingBot-Video превосходит основные базовые модели в области воплощённых сценариев.
(Подпись к рисунку: Комплексная оценка показывает, что LingBot-Video демонстрирует более глубокое понимание физических явлений и согласованность действий в сценариях с воплощенным интеллектом)
В последние годы модели генерации видео быстро совершенствовались в плане визуального качества, плавности и творческого выражения. Однако для воплощенного интеллекта видео, которое выглядит реалистично и плавно, может не отражать реальные законы физики, что затрудняет поддержку непрерывного прогнозирования, планирования и выполнения задач для роботов. В то же время воплощённый интеллект также требует более высокой эффективности рассуждений для адаптации к взаимодействию в реальном времени и циклам управления.
Это побудило сферу генерации видео развиваться по двум различным направлениям: одно — в сторону кинематографа, служащего созданию контента; другое — в сторону робототехники, служащее пониманию, прогнозированию и взаимодействию с физическим миром. LingBot-Video представляет собой значительное исследование Ant Group, направленное на поиск нового пути генерации видео, адаптированного к воплощённому интеллекту.
LingBot-Video представляет собой систематические инновации в области архитектуры, данных и обучения.
С архитектурной точки зрения LingBot-Video использует схему DiT + MoE, заменяя традиционные плотные архитектуры на MoE. Это позволяет модели масштабировать мощность, сохраняя при этом управляемые затраты на вычисления при инференсе. Имея 30 миллиардов параметров, модель активирует лишь около 3 миллиардов во время генерации, обеспечивая примерно в три раза более высокую эффективность вывода по сравнению с плотной архитектурой того же размера. Такая конструкция придает модели визуальную выразительность за счет большого количества параметров, одновременно лучше отвечая требованиям эффективности воплощённого интеллекта.
Что касается данных, для LingBot-Video был создан механизм профилирования данных, объединяющий данные, связанные с роботами, такие как VLA, VLN и Ego, на основе обширных интернет-видео, охватывающих сценарии, включая ловкие манипуляции, мобильность роботов и взаимодействия от первого лица, что в сумме составляет 70 000 часов данных, отражающих реальные действия. Эти данные помогают модели изучать взаимосвязь между действиями и изменениями окружающей среды, а не просто поверхностную текстуру и визуальный стиль видео.
В процессе обучения в LingBot-Video была внедрена многомерная система вознаграждений для обучения с подкреплением. Помимо традиционных метрик, таких как эстетика, следование подсказкам и согласованность движений, модель также учитывает физическую правдоподобность и выполнение задач, благодаря чему сгенерированные результаты в большей степени соответствуют законам физики реального мира и ближе к потребностям роботов, выполняющих задачи в реальных условиях.








 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
 Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai












