


 Lar
Como criar agentes de IA autodocumentados para produção em 2025?
Embora muitos esperem criar um código perfeito e pronto para produção com agentes de IA, os resultados geralmente apresentam falhas. O código pode quebrar semanas depois, sem nenhum registro claro do motivo pelo qual certas escolhas de design foram feitas. Este artigo explora a criação de um agente de IA autodocumentado, que não apenas fornece recursos, mas também esclarece o raciocínio por trás de suas decisões, ajudando a resolver problemas que surgem na produção e mantendo sua base de código saudável. Você encontrará etapas e estratégias práticas para tornar o código gerado por IA mais confiável e sustentável, preenchendo a lacuna entre as expectativas iniciais e os resultados do mundo real.
Pontos principais
Os agentes de IA podem gerar código e documentação, simplificando a manutenção de longo prazo.
Um documento de requisitos do produto (PRD) ajuda a alinhar os recursos gerados pela IA com as metas do projeto e as necessidades técnicas.
O Redis oferece recursos avançados de pesquisa vetorial para um cache semântico eficiente.
A engenharia de contexto envolve o fornecimento de documentação relevante aos agentes de IA para apoiar a tomada de decisões informadas.
Os comandos diff do Git ajudam os agentes de IA a entender as alterações entre as ramificações, apoiando escolhas arquitetônicas sólidas.
Criando código confiável e sustentável gerado por IA
O desafio de manter recursos gerados por IA
No atual mundo de desenvolvimento de software em rápida evolução, todos querem que a IA produza um código impecável e pronto para a produção.
No entanto, a realidade muitas vezes decepciona: o código falha semanas depois, e os desenvolvedores lutam para determinar por que um agente de IA tomou decisões específicas de design. Para superar isso, é necessária uma estratégia em que a IA não apenas crie recursos, mas também explique seu raciocínio. Esse método produz recursos mais confiáveis e fáceis de manter. A solução está na autodocumentação dos agentes de IA.
Criação de um agente de IA autodocumentado
A criação de um agente de IA autodocumentado envolve várias etapas acionáveis que beneficiam qualquer organização. Elas melhoram a capacidade de manutenção do software, a legibilidade e muito mais. Abaixo está um resumo para ajudar a aprimorar o código de sua empresa hoje:
- Documento de requisitos do produto (PRD): Comece com um PRD detalhado.
Esse documento funciona como um projeto, descrevendo a finalidade, a funcionalidade e as especificações técnicas do recurso. Um PRD claro garante que o agente de IA crie um código que se alinhe às metas do projeto.
- Cache semântico com recursos de pesquisa vetorial: Adicione um módulo de cache semântico para geração de incorporação. O cache semântico identifica e armazena perguntas semelhantes e suas respostas, reduzindo a latência e as despesas operacionais. O uso do Redis com pesquisa vetorial melhora a correspondência de similaridade, tornando o processo mais eficiente.
- Engenharia de contexto: Equipe o agente de IA com a documentação correta, como os guias de pesquisa vetorial do Redis e seus pontos de extremidade de perguntas e respostas. Isso ajuda o agente a entender a pilha de tecnologia e a fazer escolhas bem fundamentadas.
- Rastreamento e documentação de decisões: Permita que o agente de IA rastreie e documente suas decisões durante o desenvolvimento. As escolhas de design e implementação do agente tornam-se visíveis e legíveis para os desenvolvedores, criando uma trilha de auditoria que explica o "porquê" por trás do código.
Aplicativo do mundo real: Adição de um recurso de cache ao tutor de engenharia de IA
Para ver essa abordagem em ação, imagine adicionar o armazenamento em cache ao aplicativo AI Engineering Tutor.
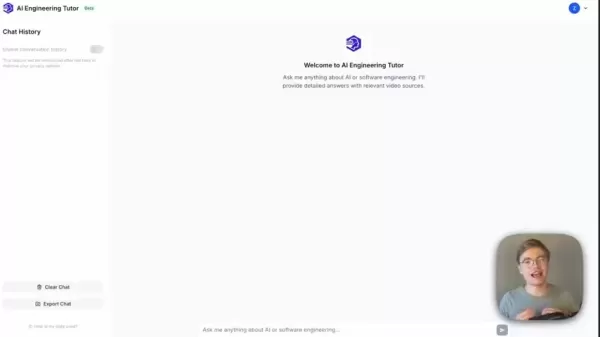
O AI Engineering Tutor oferece suporte ao aprendizado de IA. O armazenamento em cache acelera as respostas a perguntas frequentes, melhorando a experiência do usuário. Recursos rápidos são especialmente valiosos no atual ambiente orientado por IA. Para implementar o cache semântico aqui:
- Combine consultas semelhantes usando embeddings de vetores.
- Sirva respostas em cache com o mínimo de atraso.
- Gerencie o tamanho e a duração do cache com TTL e limites de capacidade.
O poder do Git Diff para agentes de IA
Aproveitamento dos comandos do Git Diff para contexto
É fundamental fornecer aos agentes de IA o contexto certo para tomar decisões arquitetônicas. O Git diff é uma ajuda poderosa.
Ao executar o git diff main, o agente de IA analisa todas as alterações em uma ramificação. Isso permite que ele compare o trabalho de desenvolvimento com o ramo de produção.
O Git diff revela o que foi alterado em relação ao código de produção atual. Esse contexto ajuda o agente a ler arquivos importantes e a compreender o escopo completo do projeto, o que leva a decisões mais inteligentes. O agente pode então criar um registro de decisão de arquitetura detalhando quais arquivos, algoritmos e limites estão na compilação mais recente. Isso simplifica o trabalho de codificação e aumenta a produtividade dos engenheiros de IA.
Evitando armadilhas comuns: Por que a promessa de "código rápido em 5 segundos" não é cumprida
Embora alguns promovam o código gerado por IA como uma solução rápida, ele traz riscos e imperfeições.
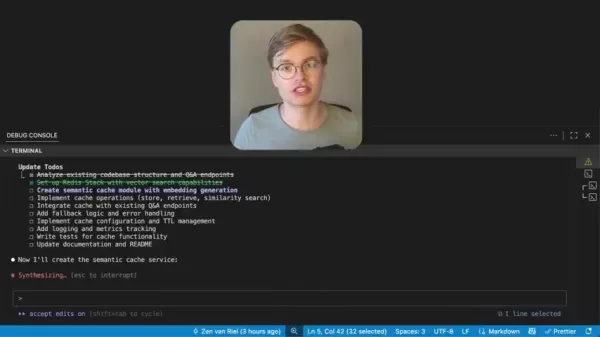
Contar com a IA para correções apressadas geralmente leva a mais problemas. É por isso que o controle de qualidade e a documentação são essenciais. Ao desenvolver a IA, planeje cuidadosamente para evitar riscos como correspondências incorretas, limites de memória ou dados desatualizados.
Alguns problemas comuns com o código gerado por IA incluem:
- Respostas incorretas
- Informações desatualizadas
- Limites de similaridade excessivamente rígidos
- Problemas de despejo do cache
Você pode reduzir esses riscos:
- Aplicar um limite de similaridade conservador.
- Atualizar regularmente os dados armazenados em cache.
- Usar uma política LRU com um limite de entrada definido.
Dicas para usar sistemas de código com tecnologia de IA e evitar dores de cabeça
Práticas recomendadas de codificação
Para obter o máximo das ferramentas orientadas por IA e minimizar os riscos, siga práticas específicas e cuidadosas. Essas etapas melhoram o desempenho do código e a estrutura de longo prazo. Considere estas recomendações:
- Execute o Redis via Docker para configuração local.
- Use um arquivo .env para gerenciar as variáveis de ambiente com segurança.
- Inicie seu backend e execute o código Python - e pronto!
Preços de ferramentas e recursos de IA
Ferramentas de IA
Ao selecionar ferramentas de desenvolvimento de IA, avalie quais recursos você precisa, sua sustentabilidade e se os benefícios justificam os custos. Aqui estão algumas opções:
- AI Engineering Tutor (atualmente em desenvolvimento; espera-se que tenha um preço razoável).
- OpenAI API (incorporação de texto-3-grande).
- FastAPI.
Os custos dessas tecnologias geralmente são baixos se forem bem mantidos, embora o uso frequente possa aumentar as despesas.
Cache semântico: avaliando as vantagens e desvantagens
Prós
Reduz o tempo de resposta de 2 a 3 segundos para cerca de 100 ms para conteúdo em cache (20 a 30 vezes mais rápido).
Diminui os custos operacionais ao reduzir a repetição de LLM e incorporar chamadas de API.
Melhora a experiência do usuário com respostas quase instantâneas a perguntas comuns.
Integra-se perfeitamente aos fluxos de trabalho de Q&A existentes.
Contras
Introduz uma dependência de infraestrutura (Redis Stack).
Pode fornecer respostas ligeiramente desatualizadas (com um TTL de 7 dias).
Aumenta a complexidade da implementação e do monitoramento.
A invalidação do cache torna-se complicada se o conteúdo for alterado com frequência.
Principais recursos dos agentes de IA com autodocumentação
O que há em um excelente agente de IA com autodocumentação?
Os principais elementos definem um agente de IA autodocumentado bem-sucedido, especialmente no SemanticCacheService, que pode formar o núcleo de sua arquitetura. Os caches semânticos eficazes geralmente incluem:
- Lógica de cache principal usando o Redis Stack para pesquisa vetorial.
- Algoritmo MNSW para pesquisas de similaridade eficientes.
- Limites de similaridade ajustáveis.
- Política de despejo LRU com um limite de 500 entradas.
- TTL de 7 dias para entradas de cache.
A aplicação dessa abordagem com vários recursos resulta em um sistema de IA mais forte e eficaz.
Casos de uso de agentes de IA com documentação automática
Como a documentação de IA pode ser útil?
A principal vantagem dos agentes de IA autodocumentados é o suporte de longo prazo para seus projetos. Um sistema legível e sustentável oferece vários benefícios. Aqui estão alguns dos principais aplicativos:
- Tarefas de codificação com IA.
- Planejamento de arquitetura de software.
- Assistência na revisão de código.
- Suporte a decisões técnicas.
PERGUNTAS FREQUENTES
Por que a autodocumentação é importante em agentes de IA?
A autodocumentação garante que as escolhas de desenvolvimento da IA sejam claras e rastreáveis, o que é essencial para depuração, manutenção e confiabilidade do código a longo prazo.
Qual é a função de um documento de requisitos do produto (PRD) no desenvolvimento de IA?
Um PRD funciona como um plano, orientando o agente de IA a criar recursos que correspondam às metas do projeto e às necessidades técnicas, garantindo resultados relevantes e eficazes.
Como a engenharia de contexto melhora a tomada de decisões da IA?
A engenharia de contexto fornece ao agente de IA a documentação necessária e os insights técnicos, ajudando-o a compreender as tecnologias subjacentes e a tomar decisões mais bem informadas.
Quais são os benefícios de usar o Redis com pesquisa vetorial para o cache semântico?
O Redis, com a pesquisa vetorial, permite o armazenamento em cache semântico eficiente, armazenando perguntas e respostas semelhantes juntas, diminuindo a latência, reduzindo os custos operacionais e melhorando a experiência do usuário.
Perguntas relacionadas
Como os comandos git diff podem ajudar a IA a entender as alterações de código?
O Git diff permite que os agentes de IA examinem as alterações nas ramificações, entendam as modificações de código no contexto e identifiquem adições, edições ou exclusões - apoiando escolhas mais informadas e arquitetonicamente sólidas.
Artigo relacionado
 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Recomendações de tópicos especiais relacionados
Design e Arte
 Ferramentas de referência de estilo visual baseadas em IA para fichas de personagens, moodboards e apresentações de projetos
As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
 11 ferramentas
 xix.ai
SEO
As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

 Comentários (1)
![BenjaminMiller]()
Honestly, the term 'self-documenting' feels like a marketing gimmick until we actually see an AI that can explain why it chose a stupid-looking loop over a vectorized operation. But hey, if it prevents future me from rage-quitting over mysterious production bugs, I'm all for it. 😅
Embora muitos esperem criar um código perfeito e pronto para produção com agentes de IA, os resultados geralmente apresentam falhas. O código pode quebrar semanas depois, sem nenhum registro claro do motivo pelo qual certas escolhas de design foram feitas. Este artigo explora a criação de um agente de IA autodocumentado, que não apenas fornece recursos, mas também esclarece o raciocínio por trás de suas decisões, ajudando a resolver problemas que surgem na produção e mantendo sua base de código saudável. Você encontrará etapas e estratégias práticas para tornar o código gerado por IA mais confiável e sustentável, preenchendo a lacuna entre as expectativas iniciais e os resultados do mundo real.
Pontos principais
Os agentes de IA podem gerar código e documentação, simplificando a manutenção de longo prazo.
Um documento de requisitos do produto (PRD) ajuda a alinhar os recursos gerados pela IA com as metas do projeto e as necessidades técnicas.
O Redis oferece recursos avançados de pesquisa vetorial para um cache semântico eficiente.
A engenharia de contexto envolve o fornecimento de documentação relevante aos agentes de IA para apoiar a tomada de decisões informadas.
Os comandos diff do Git ajudam os agentes de IA a entender as alterações entre as ramificações, apoiando escolhas arquitetônicas sólidas.
Criando código confiável e sustentável gerado por IA
O desafio de manter recursos gerados por IA
No atual mundo de desenvolvimento de software em rápida evolução, todos querem que a IA produza um código impecável e pronto para a produção.
No entanto, a realidade muitas vezes decepciona: o código falha semanas depois, e os desenvolvedores lutam para determinar por que um agente de IA tomou decisões específicas de design. Para superar isso, é necessária uma estratégia em que a IA não apenas crie recursos, mas também explique seu raciocínio. Esse método produz recursos mais confiáveis e fáceis de manter. A solução está na autodocumentação dos agentes de IA.
Criação de um agente de IA autodocumentado
A criação de um agente de IA autodocumentado envolve várias etapas acionáveis que beneficiam qualquer organização. Elas melhoram a capacidade de manutenção do software, a legibilidade e muito mais. Abaixo está um resumo para ajudar a aprimorar o código de sua empresa hoje:
- Documento de requisitos do produto (PRD): Comece com um PRD detalhado.
Esse documento funciona como um projeto, descrevendo a finalidade, a funcionalidade e as especificações técnicas do recurso. Um PRD claro garante que o agente de IA crie um código que se alinhe às metas do projeto.
- Cache semântico com recursos de pesquisa vetorial: Adicione um módulo de cache semântico para geração de incorporação. O cache semântico identifica e armazena perguntas semelhantes e suas respostas, reduzindo a latência e as despesas operacionais. O uso do Redis com pesquisa vetorial melhora a correspondência de similaridade, tornando o processo mais eficiente.
- Engenharia de contexto: Equipe o agente de IA com a documentação correta, como os guias de pesquisa vetorial do Redis e seus pontos de extremidade de perguntas e respostas. Isso ajuda o agente a entender a pilha de tecnologia e a fazer escolhas bem fundamentadas.
- Rastreamento e documentação de decisões: Permita que o agente de IA rastreie e documente suas decisões durante o desenvolvimento. As escolhas de design e implementação do agente tornam-se visíveis e legíveis para os desenvolvedores, criando uma trilha de auditoria que explica o "porquê" por trás do código.
Aplicativo do mundo real: Adição de um recurso de cache ao tutor de engenharia de IA
Para ver essa abordagem em ação, imagine adicionar o armazenamento em cache ao aplicativo AI Engineering Tutor.
O AI Engineering Tutor oferece suporte ao aprendizado de IA. O armazenamento em cache acelera as respostas a perguntas frequentes, melhorando a experiência do usuário. Recursos rápidos são especialmente valiosos no atual ambiente orientado por IA. Para implementar o cache semântico aqui:
- Combine consultas semelhantes usando embeddings de vetores.
- Sirva respostas em cache com o mínimo de atraso.
- Gerencie o tamanho e a duração do cache com TTL e limites de capacidade.
O poder do Git Diff para agentes de IA
Aproveitamento dos comandos do Git Diff para contexto
É fundamental fornecer aos agentes de IA o contexto certo para tomar decisões arquitetônicas. O Git diff é uma ajuda poderosa.
Ao executar o git diff main, o agente de IA analisa todas as alterações em uma ramificação. Isso permite que ele compare o trabalho de desenvolvimento com o ramo de produção.
O Git diff revela o que foi alterado em relação ao código de produção atual. Esse contexto ajuda o agente a ler arquivos importantes e a compreender o escopo completo do projeto, o que leva a decisões mais inteligentes. O agente pode então criar um registro de decisão de arquitetura detalhando quais arquivos, algoritmos e limites estão na compilação mais recente. Isso simplifica o trabalho de codificação e aumenta a produtividade dos engenheiros de IA.
Evitando armadilhas comuns: Por que a promessa de "código rápido em 5 segundos" não é cumprida
Embora alguns promovam o código gerado por IA como uma solução rápida, ele traz riscos e imperfeições.
Contar com a IA para correções apressadas geralmente leva a mais problemas. É por isso que o controle de qualidade e a documentação são essenciais. Ao desenvolver a IA, planeje cuidadosamente para evitar riscos como correspondências incorretas, limites de memória ou dados desatualizados.
Alguns problemas comuns com o código gerado por IA incluem:
- Respostas incorretas
- Informações desatualizadas
- Limites de similaridade excessivamente rígidos
- Problemas de despejo do cache
Você pode reduzir esses riscos:
- Aplicar um limite de similaridade conservador.
- Atualizar regularmente os dados armazenados em cache.
- Usar uma política LRU com um limite de entrada definido.
Dicas para usar sistemas de código com tecnologia de IA e evitar dores de cabeça
Práticas recomendadas de codificação
Para obter o máximo das ferramentas orientadas por IA e minimizar os riscos, siga práticas específicas e cuidadosas. Essas etapas melhoram o desempenho do código e a estrutura de longo prazo. Considere estas recomendações:
- Execute o Redis via Docker para configuração local.
- Use um arquivo .env para gerenciar as variáveis de ambiente com segurança.
- Inicie seu backend e execute o código Python - e pronto!
Preços de ferramentas e recursos de IA
Ferramentas de IA
Ao selecionar ferramentas de desenvolvimento de IA, avalie quais recursos você precisa, sua sustentabilidade e se os benefícios justificam os custos. Aqui estão algumas opções:
- AI Engineering Tutor (atualmente em desenvolvimento; espera-se que tenha um preço razoável).
- OpenAI API (incorporação de texto-3-grande).
- FastAPI.
Os custos dessas tecnologias geralmente são baixos se forem bem mantidos, embora o uso frequente possa aumentar as despesas.
Cache semântico: avaliando as vantagens e desvantagens
Prós
Reduz o tempo de resposta de 2 a 3 segundos para cerca de 100 ms para conteúdo em cache (20 a 30 vezes mais rápido).
Diminui os custos operacionais ao reduzir a repetição de LLM e incorporar chamadas de API.
Melhora a experiência do usuário com respostas quase instantâneas a perguntas comuns.
Integra-se perfeitamente aos fluxos de trabalho de Q&A existentes.
Contras
Introduz uma dependência de infraestrutura (Redis Stack).
Pode fornecer respostas ligeiramente desatualizadas (com um TTL de 7 dias).
Aumenta a complexidade da implementação e do monitoramento.
A invalidação do cache torna-se complicada se o conteúdo for alterado com frequência.
Principais recursos dos agentes de IA com autodocumentação
O que há em um excelente agente de IA com autodocumentação?
Os principais elementos definem um agente de IA autodocumentado bem-sucedido, especialmente no SemanticCacheService, que pode formar o núcleo de sua arquitetura. Os caches semânticos eficazes geralmente incluem:
- Lógica de cache principal usando o Redis Stack para pesquisa vetorial.
- Algoritmo MNSW para pesquisas de similaridade eficientes.
- Limites de similaridade ajustáveis.
- Política de despejo LRU com um limite de 500 entradas.
- TTL de 7 dias para entradas de cache.
A aplicação dessa abordagem com vários recursos resulta em um sistema de IA mais forte e eficaz.
Casos de uso de agentes de IA com documentação automática
Como a documentação de IA pode ser útil?
A principal vantagem dos agentes de IA autodocumentados é o suporte de longo prazo para seus projetos. Um sistema legível e sustentável oferece vários benefícios. Aqui estão alguns dos principais aplicativos:
- Tarefas de codificação com IA.
- Planejamento de arquitetura de software.
- Assistência na revisão de código.
- Suporte a decisões técnicas.
PERGUNTAS FREQUENTES
Por que a autodocumentação é importante em agentes de IA?
A autodocumentação garante que as escolhas de desenvolvimento da IA sejam claras e rastreáveis, o que é essencial para depuração, manutenção e confiabilidade do código a longo prazo.
Qual é a função de um documento de requisitos do produto (PRD) no desenvolvimento de IA?
Um PRD funciona como um plano, orientando o agente de IA a criar recursos que correspondam às metas do projeto e às necessidades técnicas, garantindo resultados relevantes e eficazes.
Como a engenharia de contexto melhora a tomada de decisões da IA?
A engenharia de contexto fornece ao agente de IA a documentação necessária e os insights técnicos, ajudando-o a compreender as tecnologias subjacentes e a tomar decisões mais bem informadas.
Quais são os benefícios de usar o Redis com pesquisa vetorial para o cache semântico?
O Redis, com a pesquisa vetorial, permite o armazenamento em cache semântico eficiente, armazenando perguntas e respostas semelhantes juntas, diminuindo a latência, reduzindo os custos operacionais e melhorando a experiência do usuário.
Perguntas relacionadas
Como os comandos git diff podem ajudar a IA a entender as alterações de código?
O Git diff permite que os agentes de IA examinem as alterações nas ramificações, entendam as modificações de código no contexto e identifiquem adições, edições ou exclusões - apoiando escolhas mais informadas e arquitetonicamente sólidas.








 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA

As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
11 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

Honestly, the term 'self-documenting' feels like a marketing gimmick until we actually see an AI that can explain why it chose a stupid-looking loop over a vectorized operation. But hey, if it prevents future me from rage-quitting over mysterious production bugs, I'm all for it. 😅












