


 家
Vertex AI:Googleの機械学習プラットフォーム完全ガイド
人工知能(AI)の急速な進化の中で、技術リーダーが直面する重要な課題は、実験的なプロジェクトから脱却し、企業向けソリューションを構築することです。消費者向けチャットボットが注目を集める一方、企業が成長するには対話型インターフェース以上のものが必要です。今日の激しい競争環境において、企業には堅牢でスケーラブルかつ安全なAIエコシステムが求められています。Googleは、Google Cloud上の統合AI・機械学習プラットフォーム「Vertex AI」でこのギャップを埋めることを目指しています。
Vertex AIは、生成AIを現代的なクラウドインフラと統合するための基盤層として位置付けられています。生データ基盤モデルと実運用グレードのアプリケーションの隔たりを埋めるために設計された包括的なツール群を提供します。単なる大規模言語モデル(LLM)のラッパーではなく、Vertex AIは生成AIがクラウドインフラの中核コンポーネントとなる、統一された機械学習およびAIエコシステムです。
Vertex AIの中核をなすのは「Model Garden」である。これは200以上の厳選された基盤モデルへのアクセスを提供する集中型マーケットプレイスだ。 これには、200万トークンという驚異的なコンテキストウィンドウを誇るマルチモーダルモデル「Gemini 2.5 Pro」も含まれます。本記事では、Vertex AIのアーキテクチャを分解し、Model Gardenがインテリジェンス分野における業界の「App Store」として機能する仕組みを検証するとともに、このプラットフォームを次世代エンタープライズソフトウェアの基盤として確立する技術的支柱を探ります。
中核アーキテクチャ:統合プラットフォーム
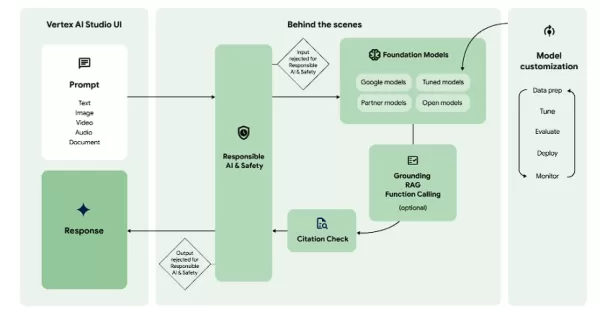
Vertex AIは単なるツールの寄せ集めではありません。機械学習を阻害するデータの断片化、ツールの非互換性、チームの分断を克服するために構築された、統合されたデータとAIのエコシステムです。 従来のAI開発は孤立した環境で行われ、データは複数のリポジトリに分散していました。例えば、顧客データはSQLデータウェアハウスに保存され、非構造化文書はデータレイクに保管されるといった具合です。データがサイロ化されると、AIモデルは部分的な情報しか把握できず、企業全体の文脈が欠如するため、偏った結果や高い幻覚率(hallucination rate)を招きます。
Vertex AIは、BigQueryやCloud Storageでの生データ取り込みから本番システムの監視まで、AIライフサイクル全体を統合することを目指しています。これはデータサイロ間の「結合組織」として機能します。Cloud StorageとBigQueryへのネイティブ統合により、Vertex AIはモデルがデータに直接アクセスすることを可能にし、複雑な抽出・変換・ロード(ETL)パイプラインの必要性を排除します。
基盤:GoogleのAIハイパーコンピューター
Vertex AIの生成AIレイヤーは、GoogleのAIハイパーコンピュータアーキテクチャを基盤としています。これは以下の要素で構成される統合型スーパーコンピューティングシステムです:
TPU v5p および v5e(テンソル処理ユニット)
GoogleのTensor Processing Unit(TPU)は、深層学習の基盤となる行列乗算演算に最適化されたカスタム設計の特定用途向け集積回路(ASIC)です。
- TPU v5p(パフォーマンス):大規模モデルトレーニング向けのフラッグシップアクセラレータです。 単一のTPU v5pポッドは最大8,960チップまで拡張可能で、Googleの高帯域幅チップ間相互接続(ICI)により4,800Gbpsで相互接続されます。技術リーダーにとって、これはGPT-3規模のモデル(1,750億パラメータ)のトレーニングを前世代比2.8倍高速化することを意味し、市場投入までの時間を大幅に短縮します。
- TPU v5e(効率性):コスト最適化性能を追求したv5eは、中規模トレーニングと高スループット推論の主力です。最大2.5倍の価格性能比を実現し、大規模予算なしで継続的な推論を必要とする企業に理想的な選択肢です。
柔軟性を実現する NVIDIA H100/A100 GPU
TPUは専用設計ですが、多くの開発チームはNVIDIA CUDAエコシステムに依存しています。Vertex AIはNVIDIAの最新ハードウェアを第一級でサポートします:
- NVIDIA H100 (Hopper): Llama 3.1 405Bなど大規模なオープンソースモデルのファインチューニングに最適。膨大なメモリ帯域幅を必要とするモデルに対応。
- Jupiter Networking:ネットワークボトルネックを防止するため、Googleは自社開発のデータセンターネットワークファブリック「Jupiter」を採用。GPU間の高速データ転送を実現し、リモートダイレクトメモリアクセス(RDMA)をサポートすることでCPUオーバーヘッドを回避。分散ノード間でもローカル処理に匹敵するパフォーマンスを提供します。
動的オーケストレーション
Vertex AIにおける重要な技術的進歩がダイナミックオーケストレーションです。従来の環境では、数週間にわたるトレーニングジョブ中にGPUノードが故障すると、プロセス全体がクラッシュする可能性がありました。
- 自動化された耐障害性:Vertex AIは、バックグラウンドでGoogle Kubernetes Engine(GKE)を基盤とする場合が多く、「自己修復」機能を備えたノードを含みます。ハードウェア障害が検出されると、プラットフォームは自動的にワークロードを健全なノードに移行します。
- 動的ワークロードスケジューラー:このツールにより、チームは緊急度に基づいてコンピューティング容量をリクエストできます。オプションには、コスト効率に優れた「フレックス開始」(リソースが空き次第開始)や、ミッションクリティカルなデプロイメント向けの「保証容量」が含まれます。
- サーバーレストレーニング:インフラ管理を回避したいチーム向けに、Vertex AI サーバーレストレーニングではコードとデータを提出するだけで利用可能です。プラットフォームがクラスターをプロビジョニングし、ジョブを実行、終了後に解体します。課金対象は使用したコンピューティング秒数のみです。
3つの導入ポイント:発見、実験、自動化
データサイエンティストからアプリケーション開発者まで、異なる技術的役割に対応するため、Vertex AI は主に 3 つのエントリーポイントを提供します:
- Model Garden: 発見のためのマーケットプレイス。
- Vertex AI Studio: 実験のためのプレイグラウンド。
- Vertex AI Agent Builder:自動化の工場。
Model Garden: 発見のためのマーケットプレイス
Google CloudのVertex AI Model Gardenは、ビジョン、テキスト、コード向けのマルチモーダルオプションを含む、自社開発、オープンソース、サードパーティの多様なAIモデルを発見、テスト、カスタマイズ、デプロイするための中央プラットフォームです。 Vertex AI の MLOps ツールとシームレスに統合され、テキスト生成、画像分析、コード補完など、タスクに適したモデルを選択し、Google Cloud 環境内で効率的にデプロイするための包括的なライブラリとして機能します。
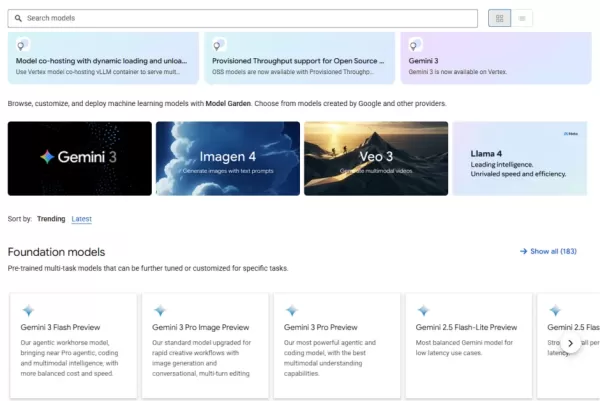
Model Gardenは200以上のモデルを3つの明確な階層に分類し、アーキテクトがパフォーマンス、コスト、制御のバランスを取れるようにします:
- ファーストパーティ(Google)モデル:Vertex AIで利用可能なGoogleの主力マルチモーダルモデル。複雑な推論向けのProから、低遅延・高ボリュームタスク向けのFlashまで、様々なサイズを提供。開発者は特定のユースケースに基づいてモデル選択を最適化可能。
- サードパーティ(プロプライエタリ)モデル:戦略的パートナーシップを通じ、Vertex AIはAnthropic(Claude 3.5)やMistral AIなどの主要企業モデルへの「Model-as-a-Service」アクセスを提供します。複数のAIプロバイダーごとに別々の課金やセキュリティを管理する必要がなく、技術チームは既存のGoogle Cloudプロジェクトから統一API経由で全てにアクセス可能です。
- オープンソース&オープンウェイトモデル:この層にはMetaのLlama 3.2、Mistral、Google独自のGemmaなどのモデルが含まれます。データ分離を最大限確保するため、自社の仮想プライベートクラウド内にモデルを自己展開することを好む組織に最適です。
非統合環境では、Llamaのようなオープンソースモデルを展開するには、PyTorch環境のセットアップ、CUDAドライバの設定、FlaskまたはFastAPIラッパーの作成が必要です。
Model Gardenは「Unified Managed Endpoints」により、この煩雑なセットアップ工程を排除します:
- ワンクリックデプロイ: 多くのモデルにおいて、「デプロイ」をクリックするだけで必要なTPU/GPUリソースが自動的にプロビジョニングされ、モデルが本番環境対応のコンテナにパッケージ化され、REST APIエンドポイントが提供されます。
- Hugging Face 統合:Vertex AI では、開発者が Hugging Face Hub から直接モデルを Vertex エンドポイントにデプロイできるようになり、利用可能なインテリジェンスの範囲が大幅に拡大しました。
- Private Service Connect (PSC): 規制の厳しい業界向けに、Private Service Connectを使用したモデルデプロイが可能。モデルエンドポイントがパブリックインターネットに公開されることはなく、すべてのデータトラフィックを企業ネットワーク内に保持します。
Vertex AI Studio: 実験のためのプレイグラウンド
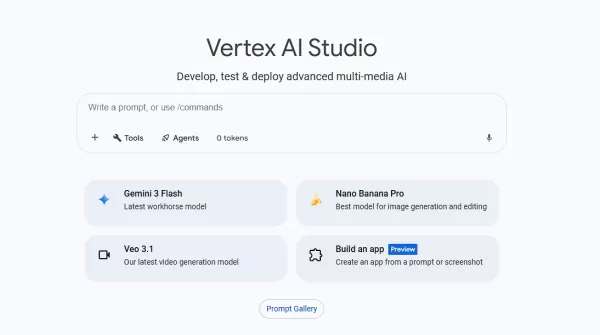
Model Gardenがモデル選定に焦点を当てる一方、Vertex AI Studioはモデルの精緻化を目的とします。従来のソフトウェア開発におけるコンパイラやデバッガーに例えられます。Vertex AI Studioは、プロンプトエンジニアリング、マルチモーダルテスト、高度なハイパーパラメータ調整を通じて、未加工のモデルを特定のビジネスツールに適合させるワークスペースです。
マルチモーダルプロトタイピング:テキストを超えた可能性
Studioの特筆すべき機能は、マルチモーダリティのネイティブサポートです。他のプラットフォームでは非テキストデータの処理に複雑なコーディングが必要な場合が多いのに対し、Vertex AI Studioではファイルをインターフェースに直接ドラッグ&ドロップするだけで、Gemini 2.5の推論能力などの機能をテストできます。
- 動画インテリジェンス:45分の技術基調講演をアップロードし、モデルに「特定のAPIの言及箇所を全て特定し、タイムスタンプ付きの要約を提供する」よう指示できます。
- 文書分析:モデルはテキストだけでなく、1,000ページに及ぶPDFの視覚的レイアウトも分析可能。図表や表、周囲のテキスト間の関係性を理解します。
- コード実行:Studioのプレイグラウンドでコード実行をサポート。複雑な数学問題の解決やCSVファイルの分析をモデルに依頼すると、安全なサンドボックス環境でPythonコードを記述・実行し、検証済みの回答を提供します。
高度なカスタマイズ:チューニングパスウェイ
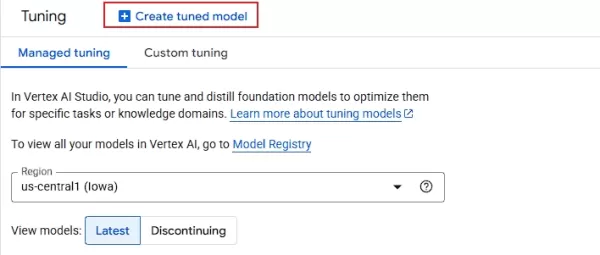
プロンプトエンジニアリング(ゼロショット学習や少ショット学習)の限界に達した場合、Vertex AI Studioはより強力なツール「モデルチューニング」を提供します。
- 教師あり微調整(SFT):開発者は「プロンプト/応答」ペアのデータセット(理想的には100例以上)を提供します。これにより、モデルは特定のブランドボイス、出力形式(特殊なJSONスキーマなど)、またはドメイン固有の用語を採用するよう訓練されます。
- コンテキストキャッシュ:法務ライブラリやコードベースなど大規模な静的データセットを扱う企業向けに、Studioはコンテキストキャッシュをサポートします。これにより、100万トークンのデータをモデルのメモリに「事前ロード」でき、後続のクエリにおけるレイテンシとコストを大幅に削減します。
- ディスティレーション(教師-生徒モデル):高度なアーキテクチャ技術です。大規模モデル(例:Gemini 2.5 Pro)を用いて、小型で高速なモデル(例:Gemini 2.0 Flash)を「訓練」できます。これにより、「Pro」レベルの性能を発揮しながら「Flash」並みの速度とコストで動作する軽量モデルが得られます。
Vertex AI Agent Builder: 自動化のファクトリー
Vertex AI Agent Builderは、基盤モデルと企業データ、外部APIを組み合わせてインテリジェントエージェントを作成できる高水準のオーケストレーションフレームワークです。
「真実」のアーキテクチャ:グラウンディングとRAG
企業向けAIの主な技術的課題は幻覚(hallucination)です。Agent Builderは高度なグラウンディングエンジンでこれを解決します。
- Google検索によるグラウンディング:リアルタイム情報が必要なクエリ(例:「ニューヨークの現在の住宅ローン金利は?」)に対し、エージェントはGoogle検索を実行し、関連事実を抽出して出典を引用できます。
- Vertex AI Search(RAG-as-a-Service):開発者はベクトルデータベースを手動で構築する代わりに(PineconeやWeaviateなどのツールを使用)、Vertex AI Searchを使用して自社のドキュメント(PDF、HTML、BigQueryテーブル)をインデックス化できます。 「チャンキング」、「埋め込み」、「検索」のステップを自動化し、エージェントの回答が完全に内部の「信頼できる情報源」に基づいていることを保証します。
- Vertex AI RAG Engine:大規模なカスタム実装向けに、このマネージドサービスはハイブリッド検索(ベクトルベースとキーワードベースの結果を組み合わせる)をサポートし、標準的な LLM 出力と比較して精度を最大 30% 向上させることができます。
マルチエージェントオーケストレーション(A2Aプロトコル)
複雑な企業ワークフローでは、複数の専門エージェントの連携が必要となる場合が多いです。Vertex AIが導入するエージェント間プロトコル(A2A)は、オープンスタンダードとして以下を実現します:
- 「旅行エージェント」が「財務エージェント」に相談し、航空券予約が企業予算内であることを確認する。
- 相互運用性:オープンプロトコルを使用するため、Vertex AI上で構築されたエージェントは、LangChainやCrewAIなどの他のフレームワークで開発されたエージェントとも通信できます。
開発者向けスタック:ADKとエージェントエンジン
技術プラットフォームのユーザー向けに、Agent Builderは2つの異なる開発パスを提供します:
- ノーコードコンソール:ビジネスユーザーによる迅速なプロトタイピングと設定のためのビジュアルなドラッグ&ドロップインターフェース。
- Agent Development Kit (ADK): エンジニア向けのコードファーストPythonツールキット。「プロンプト・アズ・コード」をサポートし、バージョン管理システムと連携。セッション永続化、スケーリング、状態管理を自動処理するマネージドランタイム「Vertex AI Agent Engine」へのデプロイが可能。
結論:「もしも」から「次なる一歩」へ
魅力的なAIデモから本番環境対応のエンタープライズアプリケーションへの移行は、デジタルトランスフォーメーションの取り組みにおいて「死の谷」と呼ばれる課題でした。これまで見てきたように、Vertex AIはこのギャップを埋めるために特別に設計されています。Google Cloudは、断片化されたデータ・インフラ・モデルオーケストレーションのサイロを統合することで、大規模言語モデルの純粋な処理能力から、AIライフサイクル全体の運用成熟度へと焦点を移行させます。
関連記事
 スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
Core Web Vitalsを修正してSEOランキングを向上させる方法
AIツールで報告書コメントの作成を効率化はじめに報告書コメント生成用のAIツールMagic SchoolAlmanac AIChat GPTMagic Schoolを使用した報告書コメントの生成Magic Schoolへのログイン報告書コメントツールの選択生徒向けのコメントのカスタマイズAlmanac AIを使用した報告書コメントの生成コースと評価基準の設定報告書の長さと生徒設定の構成Almanac AIによるコメントの生成Magic SchoolとAlmanac A
関連特集おすすめ
書き込み
 長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
 8 ツール
 xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

 コメント (1)
0/500
![RalphBaker]()
Interesting read! I've been exploring Vertex AI for a project at work, and the scalability is a game-changer compared to piecing together separate tools. The managed pipelines are a lifesaver for our small team. Still, the cost structure can get complex quickly for smaller-scale experiments. Anyone else find the initial setup a bit daunting? 🤔
人工知能(AI)の急速な進化の中で、技術リーダーが直面する重要な課題は、実験的なプロジェクトから脱却し、企業向けソリューションを構築することです。消費者向けチャットボットが注目を集める一方、企業が成長するには対話型インターフェース以上のものが必要です。今日の激しい競争環境において、企業には堅牢でスケーラブルかつ安全なAIエコシステムが求められています。Googleは、Google Cloud上の統合AI・機械学習プラットフォーム「Vertex AI」でこのギャップを埋めることを目指しています。
Vertex AIは、生成AIを現代的なクラウドインフラと統合するための基盤層として位置付けられています。生データ基盤モデルと実運用グレードのアプリケーションの隔たりを埋めるために設計された包括的なツール群を提供します。単なる大規模言語モデル(LLM)のラッパーではなく、Vertex AIは生成AIがクラウドインフラの中核コンポーネントとなる、統一された機械学習およびAIエコシステムです。
Vertex AIの中核をなすのは「Model Garden」である。これは200以上の厳選された基盤モデルへのアクセスを提供する集中型マーケットプレイスだ。 これには、200万トークンという驚異的なコンテキストウィンドウを誇るマルチモーダルモデル「Gemini 2.5 Pro」も含まれます。本記事では、Vertex AIのアーキテクチャを分解し、Model Gardenがインテリジェンス分野における業界の「App Store」として機能する仕組みを検証するとともに、このプラットフォームを次世代エンタープライズソフトウェアの基盤として確立する技術的支柱を探ります。
中核アーキテクチャ:統合プラットフォーム

Vertex AIは単なるツールの寄せ集めではありません。機械学習を阻害するデータの断片化、ツールの非互換性、チームの分断を克服するために構築された、統合されたデータとAIのエコシステムです。 従来のAI開発は孤立した環境で行われ、データは複数のリポジトリに分散していました。例えば、顧客データはSQLデータウェアハウスに保存され、非構造化文書はデータレイクに保管されるといった具合です。データがサイロ化されると、AIモデルは部分的な情報しか把握できず、企業全体の文脈が欠如するため、偏った結果や高い幻覚率(hallucination rate)を招きます。
Vertex AIは、BigQueryやCloud Storageでの生データ取り込みから本番システムの監視まで、AIライフサイクル全体を統合することを目指しています。これはデータサイロ間の「結合組織」として機能します。Cloud StorageとBigQueryへのネイティブ統合により、Vertex AIはモデルがデータに直接アクセスすることを可能にし、複雑な抽出・変換・ロード(ETL)パイプラインの必要性を排除します。
基盤:GoogleのAIハイパーコンピューター
Vertex AIの生成AIレイヤーは、GoogleのAIハイパーコンピュータアーキテクチャを基盤としています。これは以下の要素で構成される統合型スーパーコンピューティングシステムです:
TPU v5p および v5e(テンソル処理ユニット)
GoogleのTensor Processing Unit(TPU)は、深層学習の基盤となる行列乗算演算に最適化されたカスタム設計の特定用途向け集積回路(ASIC)です。
- TPU v5p(パフォーマンス):大規模モデルトレーニング向けのフラッグシップアクセラレータです。 単一のTPU v5pポッドは最大8,960チップまで拡張可能で、Googleの高帯域幅チップ間相互接続(ICI)により4,800Gbpsで相互接続されます。技術リーダーにとって、これはGPT-3規模のモデル(1,750億パラメータ)のトレーニングを前世代比2.8倍高速化することを意味し、市場投入までの時間を大幅に短縮します。
- TPU v5e(効率性):コスト最適化性能を追求したv5eは、中規模トレーニングと高スループット推論の主力です。最大2.5倍の価格性能比を実現し、大規模予算なしで継続的な推論を必要とする企業に理想的な選択肢です。
柔軟性を実現する NVIDIA H100/A100 GPU
TPUは専用設計ですが、多くの開発チームはNVIDIA CUDAエコシステムに依存しています。Vertex AIはNVIDIAの最新ハードウェアを第一級でサポートします:
- NVIDIA H100 (Hopper): Llama 3.1 405Bなど大規模なオープンソースモデルのファインチューニングに最適。膨大なメモリ帯域幅を必要とするモデルに対応。
- Jupiter Networking:ネットワークボトルネックを防止するため、Googleは自社開発のデータセンターネットワークファブリック「Jupiter」を採用。GPU間の高速データ転送を実現し、リモートダイレクトメモリアクセス(RDMA)をサポートすることでCPUオーバーヘッドを回避。分散ノード間でもローカル処理に匹敵するパフォーマンスを提供します。
動的オーケストレーション
Vertex AIにおける重要な技術的進歩がダイナミックオーケストレーションです。従来の環境では、数週間にわたるトレーニングジョブ中にGPUノードが故障すると、プロセス全体がクラッシュする可能性がありました。
- 自動化された耐障害性:Vertex AIは、バックグラウンドでGoogle Kubernetes Engine(GKE)を基盤とする場合が多く、「自己修復」機能を備えたノードを含みます。ハードウェア障害が検出されると、プラットフォームは自動的にワークロードを健全なノードに移行します。
- 動的ワークロードスケジューラー:このツールにより、チームは緊急度に基づいてコンピューティング容量をリクエストできます。オプションには、コスト効率に優れた「フレックス開始」(リソースが空き次第開始)や、ミッションクリティカルなデプロイメント向けの「保証容量」が含まれます。
- サーバーレストレーニング:インフラ管理を回避したいチーム向けに、Vertex AI サーバーレストレーニングではコードとデータを提出するだけで利用可能です。プラットフォームがクラスターをプロビジョニングし、ジョブを実行、終了後に解体します。課金対象は使用したコンピューティング秒数のみです。
3つの導入ポイント:発見、実験、自動化
データサイエンティストからアプリケーション開発者まで、異なる技術的役割に対応するため、Vertex AI は主に 3 つのエントリーポイントを提供します:
- Model Garden: 発見のためのマーケットプレイス。
- Vertex AI Studio: 実験のためのプレイグラウンド。
- Vertex AI Agent Builder:自動化の工場。
Model Garden: 発見のためのマーケットプレイス
Google CloudのVertex AI Model Gardenは、ビジョン、テキスト、コード向けのマルチモーダルオプションを含む、自社開発、オープンソース、サードパーティの多様なAIモデルを発見、テスト、カスタマイズ、デプロイするための中央プラットフォームです。 Vertex AI の MLOps ツールとシームレスに統合され、テキスト生成、画像分析、コード補完など、タスクに適したモデルを選択し、Google Cloud 環境内で効率的にデプロイするための包括的なライブラリとして機能します。

Model Gardenは200以上のモデルを3つの明確な階層に分類し、アーキテクトがパフォーマンス、コスト、制御のバランスを取れるようにします:
- ファーストパーティ(Google)モデル:Vertex AIで利用可能なGoogleの主力マルチモーダルモデル。複雑な推論向けのProから、低遅延・高ボリュームタスク向けのFlashまで、様々なサイズを提供。開発者は特定のユースケースに基づいてモデル選択を最適化可能。
- サードパーティ(プロプライエタリ)モデル:戦略的パートナーシップを通じ、Vertex AIはAnthropic(Claude 3.5)やMistral AIなどの主要企業モデルへの「Model-as-a-Service」アクセスを提供します。複数のAIプロバイダーごとに別々の課金やセキュリティを管理する必要がなく、技術チームは既存のGoogle Cloudプロジェクトから統一API経由で全てにアクセス可能です。
- オープンソース&オープンウェイトモデル:この層にはMetaのLlama 3.2、Mistral、Google独自のGemmaなどのモデルが含まれます。データ分離を最大限確保するため、自社の仮想プライベートクラウド内にモデルを自己展開することを好む組織に最適です。
非統合環境では、Llamaのようなオープンソースモデルを展開するには、PyTorch環境のセットアップ、CUDAドライバの設定、FlaskまたはFastAPIラッパーの作成が必要です。
Model Gardenは「Unified Managed Endpoints」により、この煩雑なセットアップ工程を排除します:
- ワンクリックデプロイ: 多くのモデルにおいて、「デプロイ」をクリックするだけで必要なTPU/GPUリソースが自動的にプロビジョニングされ、モデルが本番環境対応のコンテナにパッケージ化され、REST APIエンドポイントが提供されます。
- Hugging Face 統合:Vertex AI では、開発者が Hugging Face Hub から直接モデルを Vertex エンドポイントにデプロイできるようになり、利用可能なインテリジェンスの範囲が大幅に拡大しました。
- Private Service Connect (PSC): 規制の厳しい業界向けに、Private Service Connectを使用したモデルデプロイが可能。モデルエンドポイントがパブリックインターネットに公開されることはなく、すべてのデータトラフィックを企業ネットワーク内に保持します。
Vertex AI Studio: 実験のためのプレイグラウンド
Model Gardenがモデル選定に焦点を当てる一方、Vertex AI Studioはモデルの精緻化を目的とします。従来のソフトウェア開発におけるコンパイラやデバッガーに例えられます。Vertex AI Studioは、プロンプトエンジニアリング、マルチモーダルテスト、高度なハイパーパラメータ調整を通じて、未加工のモデルを特定のビジネスツールに適合させるワークスペースです。

マルチモーダルプロトタイピング:テキストを超えた可能性
Studioの特筆すべき機能は、マルチモーダリティのネイティブサポートです。他のプラットフォームでは非テキストデータの処理に複雑なコーディングが必要な場合が多いのに対し、Vertex AI Studioではファイルをインターフェースに直接ドラッグ&ドロップするだけで、Gemini 2.5の推論能力などの機能をテストできます。
- 動画インテリジェンス:45分の技術基調講演をアップロードし、モデルに「特定のAPIの言及箇所を全て特定し、タイムスタンプ付きの要約を提供する」よう指示できます。
- 文書分析:モデルはテキストだけでなく、1,000ページに及ぶPDFの視覚的レイアウトも分析可能。図表や表、周囲のテキスト間の関係性を理解します。
- コード実行:Studioのプレイグラウンドでコード実行をサポート。複雑な数学問題の解決やCSVファイルの分析をモデルに依頼すると、安全なサンドボックス環境でPythonコードを記述・実行し、検証済みの回答を提供します。
高度なカスタマイズ:チューニングパスウェイ

プロンプトエンジニアリング(ゼロショット学習や少ショット学習)の限界に達した場合、Vertex AI Studioはより強力なツール「モデルチューニング」を提供します。
- 教師あり微調整(SFT):開発者は「プロンプト/応答」ペアのデータセット(理想的には100例以上)を提供します。これにより、モデルは特定のブランドボイス、出力形式(特殊なJSONスキーマなど)、またはドメイン固有の用語を採用するよう訓練されます。
- コンテキストキャッシュ:法務ライブラリやコードベースなど大規模な静的データセットを扱う企業向けに、Studioはコンテキストキャッシュをサポートします。これにより、100万トークンのデータをモデルのメモリに「事前ロード」でき、後続のクエリにおけるレイテンシとコストを大幅に削減します。
- ディスティレーション(教師-生徒モデル):高度なアーキテクチャ技術です。大規模モデル(例:Gemini 2.5 Pro)を用いて、小型で高速なモデル(例:Gemini 2.0 Flash)を「訓練」できます。これにより、「Pro」レベルの性能を発揮しながら「Flash」並みの速度とコストで動作する軽量モデルが得られます。
Vertex AI Agent Builder: 自動化のファクトリー
Vertex AI Agent Builderは、基盤モデルと企業データ、外部APIを組み合わせてインテリジェントエージェントを作成できる高水準のオーケストレーションフレームワークです。
「真実」のアーキテクチャ:グラウンディングとRAG
企業向けAIの主な技術的課題は幻覚(hallucination)です。Agent Builderは高度なグラウンディングエンジンでこれを解決します。
- Google検索によるグラウンディング:リアルタイム情報が必要なクエリ(例:「ニューヨークの現在の住宅ローン金利は?」)に対し、エージェントはGoogle検索を実行し、関連事実を抽出して出典を引用できます。
- Vertex AI Search(RAG-as-a-Service):開発者はベクトルデータベースを手動で構築する代わりに(PineconeやWeaviateなどのツールを使用)、Vertex AI Searchを使用して自社のドキュメント(PDF、HTML、BigQueryテーブル)をインデックス化できます。 「チャンキング」、「埋め込み」、「検索」のステップを自動化し、エージェントの回答が完全に内部の「信頼できる情報源」に基づいていることを保証します。
- Vertex AI RAG Engine:大規模なカスタム実装向けに、このマネージドサービスはハイブリッド検索(ベクトルベースとキーワードベースの結果を組み合わせる)をサポートし、標準的な LLM 出力と比較して精度を最大 30% 向上させることができます。
マルチエージェントオーケストレーション(A2Aプロトコル)
複雑な企業ワークフローでは、複数の専門エージェントの連携が必要となる場合が多いです。Vertex AIが導入するエージェント間プロトコル(A2A)は、オープンスタンダードとして以下を実現します:
- 「旅行エージェント」が「財務エージェント」に相談し、航空券予約が企業予算内であることを確認する。
- 相互運用性:オープンプロトコルを使用するため、Vertex AI上で構築されたエージェントは、LangChainやCrewAIなどの他のフレームワークで開発されたエージェントとも通信できます。
開発者向けスタック:ADKとエージェントエンジン
技術プラットフォームのユーザー向けに、Agent Builderは2つの異なる開発パスを提供します:
- ノーコードコンソール:ビジネスユーザーによる迅速なプロトタイピングと設定のためのビジュアルなドラッグ&ドロップインターフェース。
- Agent Development Kit (ADK): エンジニア向けのコードファーストPythonツールキット。「プロンプト・アズ・コード」をサポートし、バージョン管理システムと連携。セッション永続化、スケーリング、状態管理を自動処理するマネージドランタイム「Vertex AI Agent Engine」へのデプロイが可能。
結論:「もしも」から「次なる一歩」へ
魅力的なAIデモから本番環境対応のエンタープライズアプリケーションへの移行は、デジタルトランスフォーメーションの取り組みにおいて「死の谷」と呼ばれる課題でした。これまで見てきたように、Vertex AIはこのギャップを埋めるために特別に設計されています。Google Cloudは、断片化されたデータ・インフラ・モデルオーケストレーションのサイロを統合することで、大規模言語モデルの純粋な処理能力から、AIライフサイクル全体の運用成熟度へと焦点を移行させます。








 スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
 Core Web Vitalsを修正してSEOランキングを向上させる方法
AIツールで報告書コメントの作成を効率化はじめに報告書コメント生成用のAIツールMagic SchoolAlmanac AIChat GPTMagic Schoolを使用した報告書コメントの生成Magic Schoolへのログイン報告書コメントツールの選択生徒向けのコメントのカスタマイズAlmanac AIを使用した報告書コメントの生成コースと評価基準の設定報告書の長さと生徒設定の構成Almanac AIによるコメントの生成Magic SchoolとAlmanac A

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

Interesting read! I've been exploring Vertex AI for a project at work, and the scalability is a game-changer compared to piecing together separate tools. The managed pipelines are a lifesaver for our small team. Still, the cost structure can get complex quickly for smaller-scale experiments. Anyone else find the initial setup a bit daunting? 🤔












