


 家
Vanna AI、自然言語処理によるノーコード・データベース・クエリーを可能に
自然言語データベース・インターフェースの出現は、データの民主化における変革的なシフトを示し、Vanna AIはこの進化の先駆者である。このオープンソースのPythonライブラリは、会話の英語を正確なSQLクエリに変換することで、ビジネスユーザーと複雑なデータシステム間のギャップを埋めます。革新的なRAG(Retrieval-Augmented Generation)アーキテクチャにより、Vannaはクエリの精度を維持しながら、専門的な技術知識がなくても洞察力を引き出すことができます。
主な利点
Vanna AIは、データ探索を簡素化する直感的な英語-SQLインターフェイスを提供します。
RAGアーキテクチャは、セマンティック理解を通じて文脈に沿った正確なクエリ生成を保証します。
完全なオープンソース実装により、企業のニーズに合わせたカスタマイズが可能
PostgreSQL、MySQL、SQLiteを含む幅広いSQLデータベースとの互換性
PythonデータワークフローやJupyter環境とのシームレスな統合
活発なオープンソース開発により、コミュニティでの採用が増加
組織横断的なデータアクセスの技術的障壁を低減
コアテクノロジーの概要
アーキテクチャ基盤
Vanna AIは、洗練された2段階のアプローチにより、最先端の自然言語処理とデータベースインテリジェンスを組み合わせます。システムはまず、ベクトル埋め込みによってスキーマ構造と既存のクエリを分析することで、データ環境を学習します。ユーザーがビジネス上の質問を投げかけると、プラットフォームはこの知識ベースに対してセマンティック検索を実行し、その後に特定のデータ環境に合わせて最適化されたSQLステートメントを生成します。
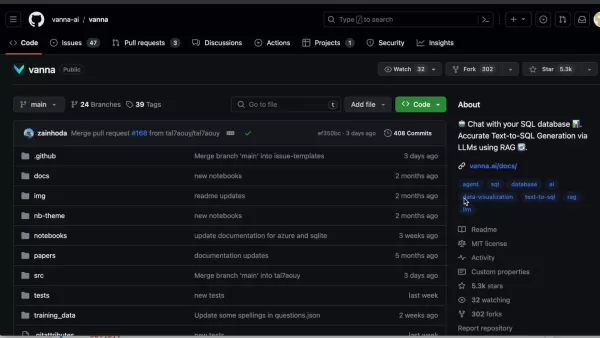
この二段階の方法論により、クエリはユーザーの意図に答えながら、データベースの関係とビジネスルールを尊重するようになります。オープンなアーキテクチャは、既存のPythonデータスタックとの統合を可能にし、特にJupyter notebookとの互換性による分析ワークフローに強みを発揮します。
主要技術コンポーネント
Vanna AIは、自然言語インターフェースを実現するためにいくつかの革新的な技術を実装しています:
- モデルの埋め込み:データベースのメタデータと自然言語を比較可能なベクトル表現に変換。
- ベクトル・データベース:クエリ生成のためのコンテクスト情報の保存と検索
- 言語モデル:検索されたコンテキストに基づいて質問を実行可能なSQLに変換します。
- クエリの検証:生成されたSQLがデータベースの構文ルールに適合していることを確認します。
- フィードバックループ:クエリ強化の成功による継続的な改善
実装ガイド
インストール手順
Pythonパッケージをインストールするには、pipコマンドを使用します:
pip install vanna
これは、必要な機械学習ライブラリやデータベースコネクタを含むすべての依存関係を処理します。企業での導入の場合、本番環境のスケーリングのためにコンテナによるインストールを検討することができます。
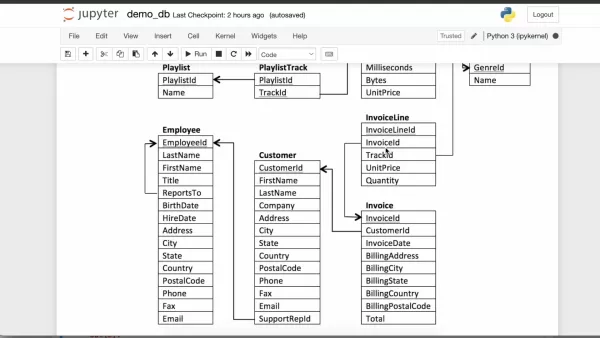
システム構成
既存のデータベースへの接続には、標準的な SQLAlchemy の接続文字列を使います:
import pandas as pd from sqlalchemy import create_engine from vanna.remote import VannaDefaultvn = VannaDefault(model='chinook', api_key='YOUR_API_KEY') vn.connect_to_sqlite('https://vanna.ai/Chinook.sqlite')
知識ベースの開発
Vanna AIのトレーニングには、以下のものが含まれます:
- 完全なデータベーススキーマの説明
- 一般的な使用例を表すサンプルクエリ
- ビジネス用語の定義
- データ関係文書
この構造化されたオンボーディングは、通常、エンドユーザがアクセスする前にデータベース管理者が1回だけ行う必要があります。
経済的考察
コスト構造分析
オープンソースソフトウェアとして、Vanna AIは完全な透明性を提供しながら、ライセンスコストを排除します。組織は以下の予算を組む必要がある:
- 複雑な展開のための実装サービス
- エンベッディング生成のためのコンピューティングリソース
- ベクトルデータベースインフラストラクチャ
- オプションのプレミアム・サポート・パッケージ
総所有コストは、多くの場合、より大きなコントロールを提供しながら、市販の代替製品よりも大幅に低いことがわかります。
ソリューション評価
主な利点
- 技術スキルレベルを超えたデータアクセスの民主化
- 専門的なSQLリソースへの依存を軽減
- 分析ワークフローの速度を加速
- セルフサービスによるレポート作成が可能
- 探索的データ分析を促進
実装の課題
- スキーマの初期理解期間が必要
- 複雑な分析質問には改良が必要な場合がある
- データベースの複雑さによってパフォーマンスが異なる
- 現在開発中の新機能
産業用アプリケーション
ビジネス・インテリジェンス
営業チームは、IT部門が関与することなく、顧客指標を即座に照会できます。また、経営幹部は、自然な質問を通じて、パフォーマンス・ダッシュボードにリアルタイムでアクセスできます:
「西部地域の製品ライン別の四半期収益傾向を教えてください。
データサイエンス
アナリストは、モデル開発の前にデータセットを会話形式で探索することで、フィーチャーエンジニアリングを加速します:
「1000ドルを超える取引額の分布は?
運用レポート
管理者は、保存された自然言語クエリによってレポート生成を自動化し、最新のデータでリフレッシュします。
よくある質問
データベース互換性
Vanna AIは、JDBC/ODBC接続を備えたクラウドデータウェアハウスを含む、すべての主要なSQL実装をサポートしています。パフォーマンスはデータベース固有の構文のニュアンスによって異なります。
精度のベンチマーク
テストによると、一般的なビジネスクエリの初期精度は85~95%で、組織固有の質問によるフィードバックトレーニング後は95%以上に向上します。
セキュリティ
クエリは既存のデータベース権限を尊重します。機密データの保護には、適切なスキーマ設計とアクセス制御の実装が必要です。
比較分析
代替ソリューション
Tableau Ask Dataのようなプロプライエタリなツールとは異なり、Vanna AIは完全なクエリの透明性とカスタマイズを提供します。オープンなアプローチにより、業界特有の用語や、基本的な可視化のニーズを超えた複雑な分析シナリオのチューニングが可能です。
関連記事
 Linux財団を支援する6つのテックジャイアント、AI脆弱性のノイズに対処するために1,250万ドルを拠出
AI自動化ツールによって生成される低品質なセキュリティレポートの洪水に対処するため、Anthropic、Amazon(AWS)、GitHub、Google、Microsoft、OpenAIの6大テック企業が、Linux Foundationのイニシアチブに対して総額1250万ドルの資金を提供しました。この投資は、オープンソースソフトウェア(FOSS)のメンテナーが手動でのスクリーニングという負担から解放され、本格的なセキュリティ脅威に集中できることを目的としています。AI技術が脆弱性発見のハー
アルトマン証言の中で、マスクはOpenAIを子供たちに譲ることを検討した
今朝、OpenAIのCEOサム・アルトマン氏は、同社の企業構造に異議を唱える元共同創設者エロン・マスク氏の訴訟に対応するため証言台に立った。「営利子会社を設立してAI搭載製品を市場に出すことで、他の創設者たちが『慈善団体を盗んだ』」というマスク氏の主張について問われると、アルトマン氏は明らかなためらいを示して応答した。「その枠組みを処理するのは難しい」と、アルトマン氏は一時の間を置いて語った。「私たちは世界最大の慈善団体の一つを設立した。財団は素晴らしい活動を行っており、今後もさらに多くのこ
サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
関連特集おすすめ
仕事
 中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
 9 ツール
 xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai
コード
リファクタリング、バグ、セキュリティ上の脆弱性を扱うGitHubチーム向けのAIプルリクエストレビューツール
2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai
テキスト読み上げ
自然なナレーションを実現する、おすすめのAIテキスト読み上げツール
2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

 コメント (1)
0/500
![WillieRamirez]()
Die Idee ist wirklich bahnbrechend – gerade für Leute wie mich, die mit SQL kämpfen. Aber ich frage mich, wie es mit Datenschutz und der Genauigkeit der abgerufenen Daten aussieht. Könnte in größeren Unternehmen ein Sicherheitsrisiko darstellen, wenn jeder einfach so auf die Datenbank zugreifen kann? Dennoch, ein spannender Schritt in Richtung Barrierefreiheit! 🔍
自然言語データベース・インターフェースの出現は、データの民主化における変革的なシフトを示し、Vanna AIはこの進化の先駆者である。このオープンソースのPythonライブラリは、会話の英語を正確なSQLクエリに変換することで、ビジネスユーザーと複雑なデータシステム間のギャップを埋めます。革新的なRAG(Retrieval-Augmented Generation)アーキテクチャにより、Vannaはクエリの精度を維持しながら、専門的な技術知識がなくても洞察力を引き出すことができます。
主な利点
Vanna AIは、データ探索を簡素化する直感的な英語-SQLインターフェイスを提供します。
RAGアーキテクチャは、セマンティック理解を通じて文脈に沿った正確なクエリ生成を保証します。
完全なオープンソース実装により、企業のニーズに合わせたカスタマイズが可能
PostgreSQL、MySQL、SQLiteを含む幅広いSQLデータベースとの互換性
PythonデータワークフローやJupyter環境とのシームレスな統合
活発なオープンソース開発により、コミュニティでの採用が増加
組織横断的なデータアクセスの技術的障壁を低減
コアテクノロジーの概要
アーキテクチャ基盤
Vanna AIは、洗練された2段階のアプローチにより、最先端の自然言語処理とデータベースインテリジェンスを組み合わせます。システムはまず、ベクトル埋め込みによってスキーマ構造と既存のクエリを分析することで、データ環境を学習します。ユーザーがビジネス上の質問を投げかけると、プラットフォームはこの知識ベースに対してセマンティック検索を実行し、その後に特定のデータ環境に合わせて最適化されたSQLステートメントを生成します。
この二段階の方法論により、クエリはユーザーの意図に答えながら、データベースの関係とビジネスルールを尊重するようになります。オープンなアーキテクチャは、既存のPythonデータスタックとの統合を可能にし、特にJupyter notebookとの互換性による分析ワークフローに強みを発揮します。
主要技術コンポーネント
Vanna AIは、自然言語インターフェースを実現するためにいくつかの革新的な技術を実装しています:
- モデルの埋め込み:データベースのメタデータと自然言語を比較可能なベクトル表現に変換。
- ベクトル・データベース:クエリ生成のためのコンテクスト情報の保存と検索
- 言語モデル:検索されたコンテキストに基づいて質問を実行可能なSQLに変換します。
- クエリの検証:生成されたSQLがデータベースの構文ルールに適合していることを確認します。
- フィードバックループ:クエリ強化の成功による継続的な改善
実装ガイド
インストール手順
Pythonパッケージをインストールするには、pipコマンドを使用します:
pip install vanna
これは、必要な機械学習ライブラリやデータベースコネクタを含むすべての依存関係を処理します。企業での導入の場合、本番環境のスケーリングのためにコンテナによるインストールを検討することができます。
システム構成
既存のデータベースへの接続には、標準的な SQLAlchemy の接続文字列を使います:
import pandas as pd from sqlalchemy import create_engine from vanna.remote import VannaDefaultvn = VannaDefault(model='chinook', api_key='YOUR_API_KEY') vn.connect_to_sqlite('https://vanna.ai/Chinook.sqlite')
知識ベースの開発
Vanna AIのトレーニングには、以下のものが含まれます:
- 完全なデータベーススキーマの説明
- 一般的な使用例を表すサンプルクエリ
- ビジネス用語の定義
- データ関係文書
この構造化されたオンボーディングは、通常、エンドユーザがアクセスする前にデータベース管理者が1回だけ行う必要があります。
経済的考察
コスト構造分析
オープンソースソフトウェアとして、Vanna AIは完全な透明性を提供しながら、ライセンスコストを排除します。組織は以下の予算を組む必要がある:
- 複雑な展開のための実装サービス
- エンベッディング生成のためのコンピューティングリソース
- ベクトルデータベースインフラストラクチャ
- オプションのプレミアム・サポート・パッケージ
総所有コストは、多くの場合、より大きなコントロールを提供しながら、市販の代替製品よりも大幅に低いことがわかります。
ソリューション評価
主な利点
- 技術スキルレベルを超えたデータアクセスの民主化
- 専門的なSQLリソースへの依存を軽減
- 分析ワークフローの速度を加速
- セルフサービスによるレポート作成が可能
- 探索的データ分析を促進
実装の課題
- スキーマの初期理解期間が必要
- 複雑な分析質問には改良が必要な場合がある
- データベースの複雑さによってパフォーマンスが異なる
- 現在開発中の新機能
産業用アプリケーション
ビジネス・インテリジェンス
営業チームは、IT部門が関与することなく、顧客指標を即座に照会できます。また、経営幹部は、自然な質問を通じて、パフォーマンス・ダッシュボードにリアルタイムでアクセスできます:
「西部地域の製品ライン別の四半期収益傾向を教えてください。
データサイエンス
アナリストは、モデル開発の前にデータセットを会話形式で探索することで、フィーチャーエンジニアリングを加速します:
「1000ドルを超える取引額の分布は?
運用レポート
管理者は、保存された自然言語クエリによってレポート生成を自動化し、最新のデータでリフレッシュします。
よくある質問
データベース互換性
Vanna AIは、JDBC/ODBC接続を備えたクラウドデータウェアハウスを含む、すべての主要なSQL実装をサポートしています。パフォーマンスはデータベース固有の構文のニュアンスによって異なります。
精度のベンチマーク
テストによると、一般的なビジネスクエリの初期精度は85~95%で、組織固有の質問によるフィードバックトレーニング後は95%以上に向上します。
セキュリティ
クエリは既存のデータベース権限を尊重します。機密データの保護には、適切なスキーマ設計とアクセス制御の実装が必要です。
比較分析
代替ソリューション
Tableau Ask Dataのようなプロプライエタリなツールとは異なり、Vanna AIは完全なクエリの透明性とカスタマイズを提供します。オープンなアプローチにより、業界特有の用語や、基本的な可視化のニーズを超えた複雑な分析シナリオのチューニングが可能です。








 Linux財団を支援する6つのテックジャイアント、AI脆弱性のノイズに対処するために1,250万ドルを拠出
AI自動化ツールによって生成される低品質なセキュリティレポートの洪水に対処するため、Anthropic、Amazon(AWS)、GitHub、Google、Microsoft、OpenAIの6大テック企業が、Linux Foundationのイニシアチブに対して総額1250万ドルの資金を提供しました。この投資は、オープンソースソフトウェア(FOSS)のメンテナーが手動でのスクリーニングという負担から解放され、本格的なセキュリティ脅威に集中できることを目的としています。AI技術が脆弱性発見のハー
 アルトマン証言の中で、マスクはOpenAIを子供たちに譲ることを検討した
今朝、OpenAIのCEOサム・アルトマン氏は、同社の企業構造に異議を唱える元共同創設者エロン・マスク氏の訴訟に対応するため証言台に立った。「営利子会社を設立してAI搭載製品を市場に出すことで、他の創設者たちが『慈善団体を盗んだ』」というマスク氏の主張について問われると、アルトマン氏は明らかなためらいを示して応答した。「その枠組みを処理するのは難しい」と、アルトマン氏は一時の間を置いて語った。「私たちは世界最大の慈善団体の一つを設立した。財団は素晴らしい活動を行っており、今後もさらに多くのこ
 サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai

2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

Die Idee ist wirklich bahnbrechend – gerade für Leute wie mich, die mit SQL kämpfen. Aber ich frage mich, wie es mit Datenschutz und der Genauigkeit der abgerufenen Daten aussieht. Könnte in größeren Unternehmen ein Sicherheitsrisiko darstellen, wenn jeder einfach so auf die Datenbank zugreifen kann? Dennoch, ein spannender Schritt in Richtung Barrierefreiheit! 🔍












