


 家
メタは、長いコンテキストスカウトとマーベリックモデルでラマ4を発表します。
2025年1月、AI業界は比較的知られていない中国のAIスタートアップ、DeepSeekが革新的なオープンソースの言語推論モデル、DeepSeek R1を発表したことで震撼しました。このモデルはMetaを凌駕するだけでなく、わずか数百万ドルという低コストでそれを実現しました—これはMetaがAIチームのリーダー数人に費やす予算に相当します!このニュースは、Metaが前月にリリースした最新のLlamaモデル、バージョン3.3がすでにやや時代遅れに見えていたこともあり、Metaを少々慌てさせました。
現在に早送りすると、Metaの創設者兼CEOであるマーク・ザッカーバーグはInstagramで新しいLlama 4シリーズの発売を発表しました。このシリーズには、4000億パラメータのLlama 4 Maverickと1090億パラメータのLlama 4 Scoutが含まれており、どちらも開発者がllama.comやHugging Faceで即座にダウンロードして試すことができます。また、2兆パラメータの巨大なモデル、Llama 4 Behemothのプレビューも公開されていますが、これはまだトレーニング中で、リリース日は未定です。
マルチモーダルおよび長コンテキスト機能
これらの新モデルの際立つ特徴の一つは、マルチモーダルな性質です。テキストだけでなく、ビデオや画像も処理できます。さらに、非常に長いコンテキストウィンドウを備えています—Maverickは100万トークン、Scoutに至っては驚異の1000万トークンです。例えるなら、一度に1500ページや1万5000ページのテキストを処理できるということです!医療、科学、文学など、大量の情報を処理・生成する必要がある分野での可能性を想像してみてください。
エキスパート混合アーキテクチャ
Llama 4の3つのモデルはすべて「エキスパート混合(MoE)」アーキテクチャを採用しており、これはOpenAIやMistralなどの企業によって注目を集めている技術です。このアプローチは、複数の小さな専門モデルを1つの大きな効率的なモデルに統合します。各Llama 4モデルは128の異なるエキスパートで構成されており、必要なエキスパートと共有エキスパートのみが各トークンを処理するため、モデルはよりコスト効率が高く、実行速度も速くなります。Metaは、Llama 4 Maverickが単一のNvidia H100 DGXホストで実行可能で、デプロイが容易だと自慢しています。
コスト効率とアクセシビリティ
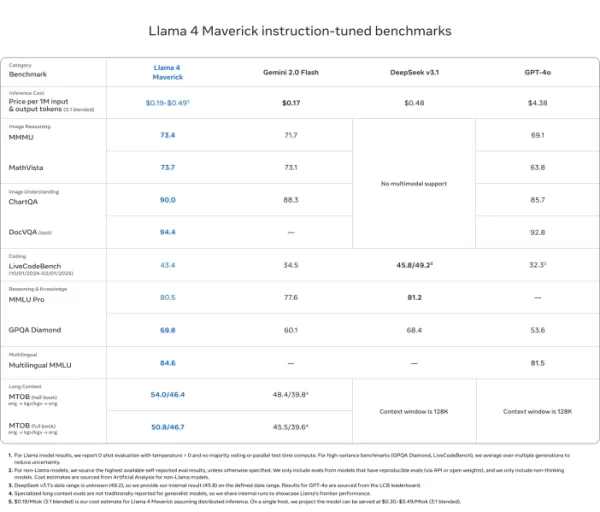
Metaはこれらのモデルをアクセスしやすくすることに注力しています。ScoutとMaverickはどちらもセルフホスティングが可能で、魅力的なコスト見積もりも公開されています。例えば、Llama 4 Maverickの推論コストは100万トークンあたり0.19ドルから0.49ドルで、GPT-4oなどの他のプロプライエタリモデルと比べると非常に安価です。クラウドプロバイダ経由でこれらのモデルを使用したい場合、Groqはすでに競争力のある価格を提供しています。
強化された推論とMetaP
これらのモデルは推論、コーディング、問題解決を念頭に構築されています。Metaはトレーニング中に簡単なプロンプトを削除し、徐々に難しいプロンプトを用いた継続的な強化学習を使用するなど、巧妙な技術を活用してこれらの能力を強化しました。また、1つのモデルでハイパーパラメータを設定し、他のモデルに適用できる新しい技術、MetaPを導入しました。これは特に、32KのGPUを使用し、30兆トークン以上を処理するBehemothのような巨大モデルのトレーニングにおいて、時間とコストを節約する画期的な技術です。
パフォーマンスと比較
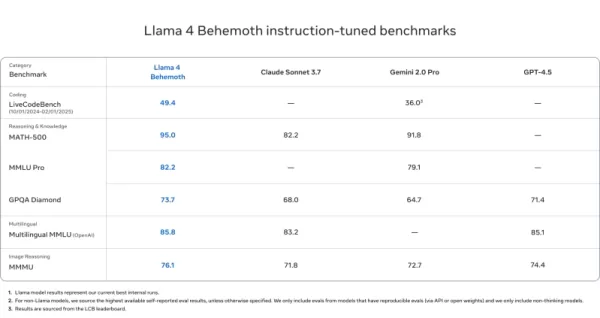
では、これらのモデルはどのように評価されるのでしょうか?ザッカーバーグはオープンソースAIが先導するというビジョンを明確に述べており、Llama 4はその方向への大きな一歩です。すべてのベンチマークで新記録を樹立するわけではありませんが、確かにトップクラスに位置しています。例えば、Llama 4 Behemothは特定のベンチマークで強力な競合を上回っていますが、DeepSeek R1やOpenAIのo1シリーズにはまだ追いついていない部分もあります。
Llama 4 Behemoth
- MATH-500(95.0)、GPQA Diamond(73.7)、MMLU Pro(82.2)でGPT-4.5、Gemini 2.0 Pro、Claude Sonnet 3.7を上回る
Llama 4 Maverick
- ChartQA、DocVQA、MathVista、MMMUなどのほとんどのマルチモーダル推論ベンチマークでGPT-4oやGemini 2.0 Flashを上回る
- DeepSeek v3.1と競合しながら、アクティブパラメータを半分以下に抑える
- ベンチマークスコア:ChartQA(90.0)、DocVQA(94.4)、MMLU Pro(80.5)
Llama 4 Scout
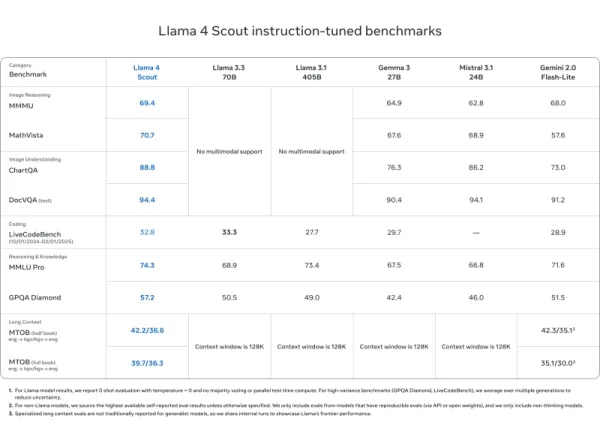
- DocVQA(94.4)、MMLU Pro(74.3)、MathVista(70.7)でMistral 3.1、Gemini 2.0 Flash-Lite、Gemma 3と同等またはそれ以上
- 比類のない1000万トークンのコンテキスト長—長編ドキュメントやコードベースに最適
DeepSeek R1との比較
トップリーグにおいては、Llama 4 Behemothは善戦していますが、DeepSeek R1やOpenAIのo1シリーズを完全に超えることはできません。MATH-500やMMLUではわずかに遅れていますが、GPQA Diamondではリードしています。それでも、Llama 4が推論分野で強力な競争相手であることは明らかです。
ベンチマーク Llama 4 Behemoth DeepSeek R1 OpenAI o1-1217 MATH-500 95.0 97.3 96.4 GPQA Diamond 73.7 71.5 75.7 MMLU 82.2 90.8 91.8
安全性と政治的中立性
Metaは安全性も忘れていません。Llama Guard、Prompt Guard、CyberSecEvalなどのツールを導入して、適切な運用を確保しています。また、2024年選挙後のザッカーバーグの共和党支持の表明を受けて、特に政治的バイアスを減らし、よりバランスの取れたアプローチを目指しています。
Llama 4の未来
Llama 4により、MetaはAIの効率性、開放性、パフォーマンスの限界を押し広げています。エンタープライズレベルのAIアシスタントを構築したい場合や、AI研究に深く取り組みたい場合、Llama 4は推論を優先した強力で柔軟なオプションを提供します。MetaがAIをよりアクセスしやすく、影響力のあるものにするために尽力していることは明らかです。
関連記事
 サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
OpenAIはアップルの営業秘密訴訟と戦っている
OpenAIは火曜日、Appleの営業秘密に関する主張に反論し、同訴訟は根拠がないと主張した。「これらの主張を真剣に受け止めているが、それを支持する証拠は見当たらない」とOpenAIは述べた。これはBloombergのEd LudlowがXで報じたものである。「私たちは公正な競争とどこでも働く自由を支持しており、世界中のユーザーを強化する技術の創出に注力しています。」これは、Appleが金曜日に米国北カリフォルニア連邦地方裁判所に提起した訴訟に続くものである。同訴訟は、OpenAIが元App
OpenAIのロボティクス部門ヘッド、ケイトリン・カリノフスキー氏がペンタゴンとの提携を理由に辞任
OpenAIのロボティクスリーダーであるケイトリン・カリノフスキーは、同社と国防総省との論争の的となったパートナーシップの後に辞任した。「これは簡単な決断ではなかった」と、カリノフスキーはソーシャルメディアでの声明で説明した。「AIが国家安全保障において重要な役割を果たしていることは事実だが、司法の監督なしにアメリカ国民の監視を行い、人間の承認なしに致死性の自律システムを展開することは、はるかに慎重な検討を必要とする境界線である」。Metaの拡張現実(AR)グラス部門を率いていたことで知られ
関連特集おすすめ
データ分析
 SaaSおよびEコマースチーム向けのKPIモニタリングにおけるベストなAI異常検知ツール
2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
 10 ツール
 xix.ai
書き込み
長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

 コメント (30)
0/500
![MichaelThomas]()
A 2 trillion parameter model? The environmental footprint of training these behemoths is starting to overshadow the hype for me. Meta's scale race is impressive, but I hope the next headline is about efficiency breakthroughs, not just size. 🌍💔
![LarryWilliams]()
Honnêtement, l'IA est en train de devenir une course aux armements écologique... Meta sort un modèle de 2T paramètres, mais on ne parle jamais de l'énergie nécessaire pour l'entraîner. DeepSeek R1 montre qu'on peut être efficace sans monstre énergivore. Un peu de sobriété, peut-être ? 🌱
![CarlGonzalez]()
Ладно, Meta выпускает Llama 4 с 2 триллионами параметров... Но я до сих пор не могу заставить свою предыдущую модель правильно переводить рецепт борща! 😅 Интересно, эти «революционные» модели когда-нибудь действительно поймут культурные нюансы или просто станут мастерами генерации клише?
![BruceRoberts]()
Meta qui continue la course aux armements avec ces modèles à 2T paramètres... mais franchement, c'est pas un peu excessif ? En janvier on avait déjà DeepSeek R1 qui montrait qu'on pouvait faire mieux avec moins. J'ai l'impression qu'ils cherchent juste à impressionner avec des chiffres gigantesques 🤔
![OwenLewis]()
Llama 4 sounds like a beast! That 10M token context window is wild—imagine analyzing entire books in one go. But can Meta keep up with DeepSeek’s efficiency? Excited for Behemoth, though! 🚀
![RogerSanchez]()
Llama 4 정말 대단해요! 긴 문맥 스카우트와 마버릭 모델은 놀랍네요. 2T 파라미터의 괴물이 나올 걸 기대하고 있어요. 다만, 설정하는 게 좀 복잡해요. 그래도, AI의 미래가 밝아 보이네요! 🚀
2025年1月、AI業界は比較的知られていない中国のAIスタートアップ、DeepSeekが革新的なオープンソースの言語推論モデル、DeepSeek R1を発表したことで震撼しました。このモデルはMetaを凌駕するだけでなく、わずか数百万ドルという低コストでそれを実現しました—これはMetaがAIチームのリーダー数人に費やす予算に相当します!このニュースは、Metaが前月にリリースした最新のLlamaモデル、バージョン3.3がすでにやや時代遅れに見えていたこともあり、Metaを少々慌てさせました。
現在に早送りすると、Metaの創設者兼CEOであるマーク・ザッカーバーグはInstagramで新しいLlama 4シリーズの発売を発表しました。このシリーズには、4000億パラメータのLlama 4 Maverickと1090億パラメータのLlama 4 Scoutが含まれており、どちらも開発者がllama.comやHugging Faceで即座にダウンロードして試すことができます。また、2兆パラメータの巨大なモデル、Llama 4 Behemothのプレビューも公開されていますが、これはまだトレーニング中で、リリース日は未定です。
マルチモーダルおよび長コンテキスト機能
これらの新モデルの際立つ特徴の一つは、マルチモーダルな性質です。テキストだけでなく、ビデオや画像も処理できます。さらに、非常に長いコンテキストウィンドウを備えています—Maverickは100万トークン、Scoutに至っては驚異の1000万トークンです。例えるなら、一度に1500ページや1万5000ページのテキストを処理できるということです!医療、科学、文学など、大量の情報を処理・生成する必要がある分野での可能性を想像してみてください。
エキスパート混合アーキテクチャ
Llama 4の3つのモデルはすべて「エキスパート混合(MoE)」アーキテクチャを採用しており、これはOpenAIやMistralなどの企業によって注目を集めている技術です。このアプローチは、複数の小さな専門モデルを1つの大きな効率的なモデルに統合します。各Llama 4モデルは128の異なるエキスパートで構成されており、必要なエキスパートと共有エキスパートのみが各トークンを処理するため、モデルはよりコスト効率が高く、実行速度も速くなります。Metaは、Llama 4 Maverickが単一のNvidia H100 DGXホストで実行可能で、デプロイが容易だと自慢しています。
コスト効率とアクセシビリティ
Metaはこれらのモデルをアクセスしやすくすることに注力しています。ScoutとMaverickはどちらもセルフホスティングが可能で、魅力的なコスト見積もりも公開されています。例えば、Llama 4 Maverickの推論コストは100万トークンあたり0.19ドルから0.49ドルで、GPT-4oなどの他のプロプライエタリモデルと比べると非常に安価です。クラウドプロバイダ経由でこれらのモデルを使用したい場合、Groqはすでに競争力のある価格を提供しています。
強化された推論とMetaP
これらのモデルは推論、コーディング、問題解決を念頭に構築されています。Metaはトレーニング中に簡単なプロンプトを削除し、徐々に難しいプロンプトを用いた継続的な強化学習を使用するなど、巧妙な技術を活用してこれらの能力を強化しました。また、1つのモデルでハイパーパラメータを設定し、他のモデルに適用できる新しい技術、MetaPを導入しました。これは特に、32KのGPUを使用し、30兆トークン以上を処理するBehemothのような巨大モデルのトレーニングにおいて、時間とコストを節約する画期的な技術です。
パフォーマンスと比較
では、これらのモデルはどのように評価されるのでしょうか?ザッカーバーグはオープンソースAIが先導するというビジョンを明確に述べており、Llama 4はその方向への大きな一歩です。すべてのベンチマークで新記録を樹立するわけではありませんが、確かにトップクラスに位置しています。例えば、Llama 4 Behemothは特定のベンチマークで強力な競合を上回っていますが、DeepSeek R1やOpenAIのo1シリーズにはまだ追いついていない部分もあります。
Llama 4 Behemoth
- MATH-500(95.0)、GPQA Diamond(73.7)、MMLU Pro(82.2)でGPT-4.5、Gemini 2.0 Pro、Claude Sonnet 3.7を上回る
Llama 4 Maverick
- ChartQA、DocVQA、MathVista、MMMUなどのほとんどのマルチモーダル推論ベンチマークでGPT-4oやGemini 2.0 Flashを上回る
- DeepSeek v3.1と競合しながら、アクティブパラメータを半分以下に抑える
- ベンチマークスコア:ChartQA(90.0)、DocVQA(94.4)、MMLU Pro(80.5)
Llama 4 Scout
- DocVQA(94.4)、MMLU Pro(74.3)、MathVista(70.7)でMistral 3.1、Gemini 2.0 Flash-Lite、Gemma 3と同等またはそれ以上
- 比類のない1000万トークンのコンテキスト長—長編ドキュメントやコードベースに最適
DeepSeek R1との比較
トップリーグにおいては、Llama 4 Behemothは善戦していますが、DeepSeek R1やOpenAIのo1シリーズを完全に超えることはできません。MATH-500やMMLUではわずかに遅れていますが、GPQA Diamondではリードしています。それでも、Llama 4が推論分野で強力な競争相手であることは明らかです。
| ベンチマーク | Llama 4 Behemoth | DeepSeek R1 | OpenAI o1-1217 |
|---|---|---|---|
| MATH-500 | 95.0 | 97.3 | 96.4 |
| GPQA Diamond | 73.7 | 71.5 | 75.7 |
| MMLU | 82.2 | 90.8 | 91.8 |
安全性と政治的中立性
Metaは安全性も忘れていません。Llama Guard、Prompt Guard、CyberSecEvalなどのツールを導入して、適切な運用を確保しています。また、2024年選挙後のザッカーバーグの共和党支持の表明を受けて、特に政治的バイアスを減らし、よりバランスの取れたアプローチを目指しています。
Llama 4の未来
Llama 4により、MetaはAIの効率性、開放性、パフォーマンスの限界を押し広げています。エンタープライズレベルのAIアシスタントを構築したい場合や、AI研究に深く取り組みたい場合、Llama 4は推論を優先した強力で柔軟なオプションを提供します。MetaがAIをよりアクセスしやすく、影響力のあるものにするために尽力していることは明らかです。








 サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
 OpenAIはアップルの営業秘密訴訟と戦っている
OpenAIは火曜日、Appleの営業秘密に関する主張に反論し、同訴訟は根拠がないと主張した。「これらの主張を真剣に受け止めているが、それを支持する証拠は見当たらない」とOpenAIは述べた。これはBloombergのEd LudlowがXで報じたものである。「私たちは公正な競争とどこでも働く自由を支持しており、世界中のユーザーを強化する技術の創出に注力しています。」これは、Appleが金曜日に米国北カリフォルニア連邦地方裁判所に提起した訴訟に続くものである。同訴訟は、OpenAIが元App
 OpenAIのロボティクス部門ヘッド、ケイトリン・カリノフスキー氏がペンタゴンとの提携を理由に辞任
OpenAIのロボティクスリーダーであるケイトリン・カリノフスキーは、同社と国防総省との論争の的となったパートナーシップの後に辞任した。「これは簡単な決断ではなかった」と、カリノフスキーはソーシャルメディアでの声明で説明した。「AIが国家安全保障において重要な役割を果たしていることは事実だが、司法の監督なしにアメリカ国民の監視を行い、人間の承認なしに致死性の自律システムを展開することは、はるかに慎重な検討を必要とする境界線である」。Metaの拡張現実(AR)グラス部門を率いていたことで知られ

2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

A 2 trillion parameter model? The environmental footprint of training these behemoths is starting to overshadow the hype for me. Meta's scale race is impressive, but I hope the next headline is about efficiency breakthroughs, not just size. 🌍💔
Honnêtement, l'IA est en train de devenir une course aux armements écologique... Meta sort un modèle de 2T paramètres, mais on ne parle jamais de l'énergie nécessaire pour l'entraîner. DeepSeek R1 montre qu'on peut être efficace sans monstre énergivore. Un peu de sobriété, peut-être ? 🌱
Ладно, Meta выпускает Llama 4 с 2 триллионами параметров... Но я до сих пор не могу заставить свою предыдущую модель правильно переводить рецепт борща! 😅 Интересно, эти «революционные» модели когда-нибудь действительно поймут культурные нюансы или просто станут мастерами генерации клише?
Meta qui continue la course aux armements avec ces modèles à 2T paramètres... mais franchement, c'est pas un peu excessif ? En janvier on avait déjà DeepSeek R1 qui montrait qu'on pouvait faire mieux avec moins. J'ai l'impression qu'ils cherchent juste à impressionner avec des chiffres gigantesques 🤔
Llama 4 sounds like a beast! That 10M token context window is wild—imagine analyzing entire books in one go. But can Meta keep up with DeepSeek’s efficiency? Excited for Behemoth, though! 🚀
Llama 4 정말 대단해요! 긴 문맥 스카우트와 마버릭 모델은 놀랍네요. 2T 파라미터의 괴물이 나올 걸 기대하고 있어요. 다만, 설정하는 게 좀 복잡해요. 그래도, AI의 미래가 밝아 보이네요! 🚀












