


 家
Googleの「Gemini Omni」は、画像、音声、テキストから動画を生成する
3年前、Googleはマルチモーダル大規模言語モデル(テキスト、画像、音声、動画を学習し、これらすべての形式にわたるコンテンツを生成できる統合型ニューラルネットワーク)の開発を目的として、Geminiを発表しました。
本日開催された開発者向けカンファレンス「Google I/O」において、同社はこのビジョンを実現すべく、新たなマルチモーダルモデル群「Gemini Omni」を発表しました。GoogleのCEOであるサンダー・ピチャイ氏は、Omniによってユーザーが「あらゆる入力から何でも作成できるようになる」と述べました。
Omniの当初の焦点は動画です。ユーザーは画像、音声、動画、テキストを組み合わせることが可能になりました。Omniは単にこれらの要素をつなぎ合わせるのではなく、すべてのモダリティを横断してインテリジェントに推論を行い、首尾一貫した出力を生成します。その結果、物理学、文化、歴史、科学に対する理解を示した高品質な動画が生まれます。
またOmniでは、Googleの「Nano Banana」ツールと同様に、複雑なソフトウェアを必要とせず、簡単なテキストコマンドで写真を編集することも可能です。
Googleは既に、テキストや画像を動画に変換し、アバターの演出やカスタマイズを可能にする専用動画モデル「Veo」を提供している。しかし、Google DeepMindのプロダクトマネジメントディレクターであるニコール・ブリヒトヴァ氏は、今回のリリースが単なるVeoのアップデート以上のものだと強調した。「これは、Geminiの知能と当社のメディアモデルのレンダリング機能を融合させるための次のステップです。」
月曜日のメディアブリーフィングで、DeepMindのチーフ・テクノロジストであるコレイ・カヴクチュオグル氏は、次のような例を挙げた。「タンパク質フォールディングのクレイアニメーション解説」というプロンプトを入力すると、Omniは即座にストップモーション動画を生成し、ナレーションで「タンパク質はアミノ酸の鎖として始まります。それらはαヘリックスやβシートと呼ばれる平らな部分のような構造に折りたたまれ、最終的に精密な3次元形状を形成します」と説明した。
Omniの長期的なビジョンはさらに広範で、音声から画像を生成したり、動画から音声を生成したりする機能も包含しています。
「Geminiを初めて発表した際、それは当社初のネイティブ・マルチモーダルAIモデルでした」と、ピチャイ氏はブリーフィングで述べた。「テキスト、コード、音声、画像、動画を組み合わせて学習させることで、世界に対する理解が深まると確信していました。ワールドモデルにより、AIはテキストの予測から現実のシミュレーションへと進化しています。Gemini Omniは、その方向への次のステップです。」
今回のリリースの一環として、ユーザーは自身のデジタルアバターが登場する動画を作成できるようになります。これは、OpenAIが提供していた(現在はサービス終了した)SoraアプリとCameosによって普及した機能です。ブリヒトヴァ氏によると、ディープフェイクを防ぐため、ユーザーは専用のオンボーディングプロセスを完了する必要があります。このプロセスでは、一連の数字を読み上げながら自分の声を録音します。その後、アバターは将来の使用のために保存されます。
さらに、Omniで作成されたすべての動画にはGoogleのSynthIDデジタル透かしが埋め込まれ、ユーザーはコンテンツがGemini製品を使用して生成されたかどうかを確認できるようになります。
このシリーズ初のモデルとなる「Gemini Omni Flash」は、本日、Geminiアプリ、YouTube Shorts、AIクリエイティブスタジオ「Flow」でリリースされる。Flashは10秒間の動画を生成できる。ブリヒトヴァ氏は、この再生時間はモデルの制限ではなく、現在多くのユーザーが短いクリップを好むと予想し、アクセシビリティを広げるための戦略的な決定であると説明した。より長い動画への対応は近い将来に予定されている。
GoogleはOmni Flashを主に一般消費者向けのツールとして位置付けているようだ。TechCrunchとの電話インタビューで、ブリヒトヴァ氏とDeepMindの研究エンジニアであるゲイブ・バース=マロン氏は、アバターのユースケースについて、賞を受賞したり月を訪れたりする自分の動画を作成したり、休暇中の動画の背景から通行人を削除したりするなど、個人的な用途であると説明した。
バース=マロン氏はこれを簡潔にこう要約した。「これらは、いわばパーソナライズされたミームのようなものです」
「私たちは間違いなく、一般ユーザーが簡単に使えるようにすることに重点を置きました」とブリヒトヴァ氏は語った。「動画モデルで一般消費者市場への進出に成功した例は多くありません。これは、私たちがそれを成し遂げようとする試みです。」
この使いやすさには注意点がある。ブリクトヴァ氏とバース=マロン氏は、編集プロンプトを極めて具体的に指定する必要があると指摘した。そうしないと、Omniが過剰に編集したり、ユーザーが残すつもりだった要素を意図せず変更したりする可能性がある。これはNano Bananaのユーザーも直面している課題だ。
画像提供:Google
Omniは当面は一般消費者向けですが、企業やクリエイティブ分野での応用可能性も明らかです。Googleは今後数週間以内にOmniをAPI経由で公開する予定です。すでにShortsで利用可能なこのアバター生成ツールは、コンテンツクリエイターの間で支持を集めると予想されます。さらに広く見れば、エンドツーエンドのマルチモーダルワークフローは、広告や映画制作に革命をもたらす可能性があります。
スタートアップのLuma AIは、独自の「統合」モデルを搭載した同様のエージェント型ツールを開発中であり、企画書と製品画像から広告キャンペーン全体を生成することが可能です。
「実は、このモデルのテキスト生成能力にはかなり自信を持っています。広告のような用途には非常に有用です」とブリヒトヴァ氏は述べた。「プロダクトプレイスメントや、単にスローガンが必要な場合でも、正確性は極めて重要です……映画製作者やその他のクリエイターも、このモデルを採用してくれると確信しています。」
より専門的なユースケースには、すべてのOmniタスクにおいて優れたパフォーマンスを発揮するよう設計された、近日公開予定のOmni Proモデルの方が適しているかもしれない。GoogleはまだPro版のリリース日を発表していないが、ブリヒトヴァ氏は、「Flashを超える大幅な機能の飛躍を達成した時点で」リリースすると示唆した。
関連記事
 Google、AIによるディープフェイクを使ったなりすまし詐欺からユーザーを守るため、偽の着信検知機能を導入
Googleは火曜日、AIによるディープフェイクを使ったなりすまし詐欺からユーザーを守るため、Androidに「偽の着信検出」機能を導入すると発表した。この機能は今月、Pixel端末を皮切りに、Android 12以降の端末向け「Phone by Google」アプリを通じて世界中で順次提供される。見知らぬ番号からの着信に応答することを避ける人が増えるにつれ、詐欺師たちは手口を変え、信頼できる電話
フロンティアAIラボ、異常挙動を示すモデルの封じ込め戦略の開示を拒否
最近の調査によると、主要なAI研究所のうち、封じ込め対応計画を公表または実証しているところはごくわずかであることが示されている。封じ込め計画とは、AIシステムが人間の制御を覆そうとした場合の対応手順を定義するもので、どのアクセス権限を取り消すか、またいつシステムを完全にシャットダウンするかを具体的に規定している。この調査結果は、安全な最先端AI開発の実践を推進することに注力する組織「Guideli
GoogleはIO 2026で音声操作型スマートグラスを初公開し、Metaの戦略に倣った。
Googleはスマートグラス市場に戦略的に再参入している。火曜日に開催された「Google I/O」イベントで、このテクノロジー大手は、Warby ParkerおよびGentle Monsterとの提携を発表し、AI搭載の新しいアイウェアシリーズを発売すると明らかにした。サムスンと共同で設計されたこれらのデバイスは、AndroidおよびiOSの両プラットフォームとのシームレスな連携に最適化されてお
関連特集おすすめ
デザインとアート
 キャラクターシート、ムードボード、ピッチデッキ向けのAIビジュアルスタイルリファレンスツール
2026年最新の、キャラクターシート、ムードボード、ピッチデッキに最適なAIビジュアルスタイルリファレンスツールがXIX.AIに登場!この厳選された高評価ツール一覧には、実環境での厳格なテストをクリアした、業界に革新をもたらす強力なツールが掲載されています。 無料版と有料版の比較、詳細なランキング、そして創造性を高め、ワークフローを効率化するためにぜひ試したいツールが満載です。今すぐチェックして、生産性を向上させるあなたにぴったりのツールを見つけましょう!
 11 ツール
 xix.ai
SEO
検索戦略に最適なAI SERP分析ツール
2026年版、検索戦略に最適な高評価のAI SERP分析ツールは、XIX.AIが実環境での厳格なテストを経て厳選し、毎週ランキングを更新しています。これらの強力なツールを活用すれば、隠れた最適化の機会を発見し、コンテンツのパフォーマンスを向上させ、検索分野で競争優位性を獲得することができます。今すぐ、検索戦略を強化するのに最適なツールを見つけてください。今すぐチェック!
13 ツール
xix.ai
データ分析
SaaSおよびEコマースチーム向けのKPIモニタリングにおけるベストなAI異常検知ツール
2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai
書き込み
長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

 コメント (0)
0/500
3年前、Googleはマルチモーダル大規模言語モデル(テキスト、画像、音声、動画を学習し、これらすべての形式にわたるコンテンツを生成できる統合型ニューラルネットワーク)の開発を目的として、Geminiを発表しました。
本日開催された開発者向けカンファレンス「Google I/O」において、同社はこのビジョンを実現すべく、新たなマルチモーダルモデル群「Gemini Omni」を発表しました。GoogleのCEOであるサンダー・ピチャイ氏は、Omniによってユーザーが「あらゆる入力から何でも作成できるようになる」と述べました。
Omniの当初の焦点は動画です。ユーザーは画像、音声、動画、テキストを組み合わせることが可能になりました。Omniは単にこれらの要素をつなぎ合わせるのではなく、すべてのモダリティを横断してインテリジェントに推論を行い、首尾一貫した出力を生成します。その結果、物理学、文化、歴史、科学に対する理解を示した高品質な動画が生まれます。
またOmniでは、Googleの「Nano Banana」ツールと同様に、複雑なソフトウェアを必要とせず、簡単なテキストコマンドで写真を編集することも可能です。
Googleは既に、テキストや画像を動画に変換し、アバターの演出やカスタマイズを可能にする専用動画モデル「Veo」を提供している。しかし、Google DeepMindのプロダクトマネジメントディレクターであるニコール・ブリヒトヴァ氏は、今回のリリースが単なるVeoのアップデート以上のものだと強調した。「これは、Geminiの知能と当社のメディアモデルのレンダリング機能を融合させるための次のステップです。」
月曜日のメディアブリーフィングで、DeepMindのチーフ・テクノロジストであるコレイ・カヴクチュオグル氏は、次のような例を挙げた。「タンパク質フォールディングのクレイアニメーション解説」というプロンプトを入力すると、Omniは即座にストップモーション動画を生成し、ナレーションで「タンパク質はアミノ酸の鎖として始まります。それらはαヘリックスやβシートと呼ばれる平らな部分のような構造に折りたたまれ、最終的に精密な3次元形状を形成します」と説明した。
Omniの長期的なビジョンはさらに広範で、音声から画像を生成したり、動画から音声を生成したりする機能も包含しています。
「Geminiを初めて発表した際、それは当社初のネイティブ・マルチモーダルAIモデルでした」と、ピチャイ氏はブリーフィングで述べた。「テキスト、コード、音声、画像、動画を組み合わせて学習させることで、世界に対する理解が深まると確信していました。ワールドモデルにより、AIはテキストの予測から現実のシミュレーションへと進化しています。Gemini Omniは、その方向への次のステップです。」
今回のリリースの一環として、ユーザーは自身のデジタルアバターが登場する動画を作成できるようになります。これは、OpenAIが提供していた(現在はサービス終了した)SoraアプリとCameosによって普及した機能です。ブリヒトヴァ氏によると、ディープフェイクを防ぐため、ユーザーは専用のオンボーディングプロセスを完了する必要があります。このプロセスでは、一連の数字を読み上げながら自分の声を録音します。その後、アバターは将来の使用のために保存されます。
さらに、Omniで作成されたすべての動画にはGoogleのSynthIDデジタル透かしが埋め込まれ、ユーザーはコンテンツがGemini製品を使用して生成されたかどうかを確認できるようになります。
このシリーズ初のモデルとなる「Gemini Omni Flash」は、本日、Geminiアプリ、YouTube Shorts、AIクリエイティブスタジオ「Flow」でリリースされる。Flashは10秒間の動画を生成できる。ブリヒトヴァ氏は、この再生時間はモデルの制限ではなく、現在多くのユーザーが短いクリップを好むと予想し、アクセシビリティを広げるための戦略的な決定であると説明した。より長い動画への対応は近い将来に予定されている。
GoogleはOmni Flashを主に一般消費者向けのツールとして位置付けているようだ。TechCrunchとの電話インタビューで、ブリヒトヴァ氏とDeepMindの研究エンジニアであるゲイブ・バース=マロン氏は、アバターのユースケースについて、賞を受賞したり月を訪れたりする自分の動画を作成したり、休暇中の動画の背景から通行人を削除したりするなど、個人的な用途であると説明した。
バース=マロン氏はこれを簡潔にこう要約した。「これらは、いわばパーソナライズされたミームのようなものです」
「私たちは間違いなく、一般ユーザーが簡単に使えるようにすることに重点を置きました」とブリヒトヴァ氏は語った。「動画モデルで一般消費者市場への進出に成功した例は多くありません。これは、私たちがそれを成し遂げようとする試みです。」
この使いやすさには注意点がある。ブリクトヴァ氏とバース=マロン氏は、編集プロンプトを極めて具体的に指定する必要があると指摘した。そうしないと、Omniが過剰に編集したり、ユーザーが残すつもりだった要素を意図せず変更したりする可能性がある。これはNano Bananaのユーザーも直面している課題だ。
画像提供:Google
Omniは当面は一般消費者向けですが、企業やクリエイティブ分野での応用可能性も明らかです。Googleは今後数週間以内にOmniをAPI経由で公開する予定です。すでにShortsで利用可能なこのアバター生成ツールは、コンテンツクリエイターの間で支持を集めると予想されます。さらに広く見れば、エンドツーエンドのマルチモーダルワークフローは、広告や映画制作に革命をもたらす可能性があります。
スタートアップのLuma AIは、独自の「統合」モデルを搭載した同様のエージェント型ツールを開発中であり、企画書と製品画像から広告キャンペーン全体を生成することが可能です。
「実は、このモデルのテキスト生成能力にはかなり自信を持っています。広告のような用途には非常に有用です」とブリヒトヴァ氏は述べた。「プロダクトプレイスメントや、単にスローガンが必要な場合でも、正確性は極めて重要です……映画製作者やその他のクリエイターも、このモデルを採用してくれると確信しています。」
より専門的なユースケースには、すべてのOmniタスクにおいて優れたパフォーマンスを発揮するよう設計された、近日公開予定のOmni Proモデルの方が適しているかもしれない。GoogleはまだPro版のリリース日を発表していないが、ブリヒトヴァ氏は、「Flashを超える大幅な機能の飛躍を達成した時点で」リリースすると示唆した。








 Google、AIによるディープフェイクを使ったなりすまし詐欺からユーザーを守るため、偽の着信検知機能を導入
Googleは火曜日、AIによるディープフェイクを使ったなりすまし詐欺からユーザーを守るため、Androidに「偽の着信検出」機能を導入すると発表した。この機能は今月、Pixel端末を皮切りに、Android 12以降の端末向け「Phone by Google」アプリを通じて世界中で順次提供される。見知らぬ番号からの着信に応答することを避ける人が増えるにつれ、詐欺師たちは手口を変え、信頼できる電話
 フロンティアAIラボ、異常挙動を示すモデルの封じ込め戦略の開示を拒否
最近の調査によると、主要なAI研究所のうち、封じ込め対応計画を公表または実証しているところはごくわずかであることが示されている。封じ込め計画とは、AIシステムが人間の制御を覆そうとした場合の対応手順を定義するもので、どのアクセス権限を取り消すか、またいつシステムを完全にシャットダウンするかを具体的に規定している。この調査結果は、安全な最先端AI開発の実践を推進することに注力する組織「Guideli
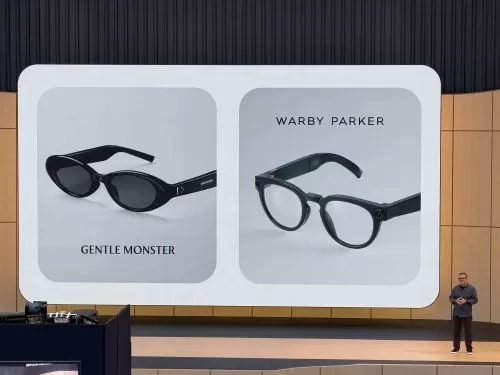 GoogleはIO 2026で音声操作型スマートグラスを初公開し、Metaの戦略に倣った。
Googleはスマートグラス市場に戦略的に再参入している。火曜日に開催された「Google I/O」イベントで、このテクノロジー大手は、Warby ParkerおよびGentle Monsterとの提携を発表し、AI搭載の新しいアイウェアシリーズを発売すると明らかにした。サムスンと共同で設計されたこれらのデバイスは、AndroidおよびiOSの両プラットフォームとのシームレスな連携に最適化されてお

2026年最新の、キャラクターシート、ムードボード、ピッチデッキに最適なAIビジュアルスタイルリファレンスツールがXIX.AIに登場!この厳選された高評価ツール一覧には、実環境での厳格なテストをクリアした、業界に革新をもたらす強力なツールが掲載されています。 無料版と有料版の比較、詳細なランキング、そして創造性を高め、ワークフローを効率化するためにぜひ試したいツールが満載です。今すぐチェックして、生産性を向上させるあなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai

2026年版、検索戦略に最適な高評価のAI SERP分析ツールは、XIX.AIが実環境での厳格なテストを経て厳選し、毎週ランキングを更新しています。これらの強力なツールを活用すれば、隠れた最適化の機会を発見し、コンテンツのパフォーマンスを向上させ、検索分野で競争優位性を獲得することができます。今すぐ、検索戦略を強化するのに最適なツールを見つけてください。今すぐチェック!
13 ツール
xix.ai

2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai












