


 家
Deepmind CEOのDemis Hassabisは、GoogleのGeminiとVeo AIモデルの将来の統合を発表しました
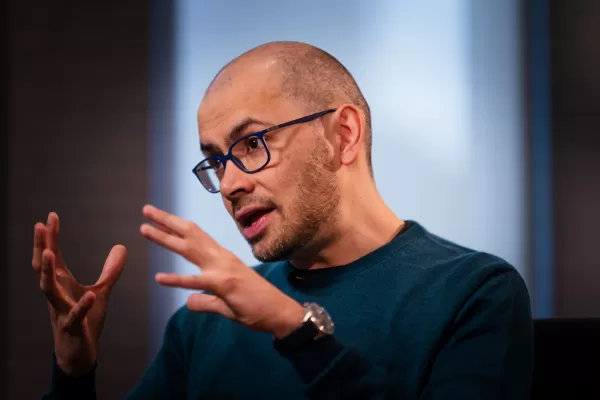
ポッドキャストPossibleの最近のエピソードで、LinkedIn共同創業者レイド・ホフマンが共同ホストを務め、Google DeepMind CEOデミス・ハサビスがGoogleの計画について興奮するニュースを共有しました。彼は、GoogleがGemini AIモデルをVeoビデオ生成モデルと統合しようとしていることを明らかにしました。この融合は、Geminiの物理世界の理解を強化し、現実のダイナミクスをより巧みに理解できるようにすることを目指しています。
ハサビスは、Geminiが最初からマルチモーダルになるように設計されていたと強調しました。「我々は常に、基盤モデルであるGeminiを最初からマルチモーダルに構築してきました」と彼は説明しました。このアプローチの動機は?日常生活で本当の意味で役立つユニバーサルデジタルアシスタントのビジョンです。「現実世界で実際にあなたを助けるアシスタント」とハサビスは詳しく述べました。
AI業界は、いわゆる「オムニ」モデル——さまざまなメディアを処理し統合できるモデル——に向かって着実に進化しています。たとえば、Googleの最新のGeminiイテレーションは、テキストだけでなくオーディオや画像も生成できます。一方、OpenAIのChatGPTデフォルトモデルは、その場で画像を生成でき、スタジオジブリ風のアートも含まれます。Amazonも遅れを取っておらず、今年後半に「any-to-any」モデルを展開する計画です。
これらのオムニモデルには、画像、ビデオ、オーディオ、テキストといった膨大なトレーニングデータが必要です。ハサビスは、Veoのビデオデータが主にYouTubeから来ていると示唆しました。YouTubeはGoogleが所有する宝の山です。「基本的に、YouTubeビデオ——大量のYouTubeビデオ——を見ることによって、[Veo 2]は世界の物理を理解できます」と彼は述べました。
Googleは以前、TechCrunchに対し、そのモデルがYouTubeクリエイターとの契約に基づいて「一部の」YouTubeコンテンツでトレーニングされている「可能性がある」と述べていました。昨年、GoogleがAIモデルのトレーニングのためにさらに多くのデータにアクセスするために利用規約を拡大したことは注目に値します。
関連記事
 Gemini SparkがGoogleフォトのライブラリを管理するようになりました
Googleは、Gemini SparkがGoogle Photosライブラリを管理できるようにすることで、AI統合を拡大している。ユーザーは現在、エージェントに画像の編集、アルバムの整理、お気に入りのショットから共有コレクションの生成、コンサートフライヤーをカレンダーイベントへの変換、その他のワークフローの自動化などの指示を出すことができる。Google Photos責任者のShimrit Ben-Yair氏はX上でこれらの新機能を発表し、米国在住のGemini AI ProおよびUltra
Geminiは、米国のユーザー向けに、無料でパーソナライズされたAI画像生成サービスを提供しています
月曜日、Googleは、「Gemini」アプリが「Nano Banana」を基盤としたパーソナライズされた画像生成機能を、より多くのユーザーに提供することを明らかにしました。本日より、米国内の条件を満たすすべてのユーザーが、この機能を無料で利用できるようになり、これまで「Plus」「Pro」「Ultra」のサブスクリプション加入者に限定されていた制限が撤廃されました。4月に初めて導入されたGemi
Geminiの新機能がまもなくGoogle TVに統合される見込み
水曜日、GoogleはGoogle TVに導入予定の一連の新しいAI駆動型機能を公開しました。これには、YouTube Shortsをホーム画面に直接表示するショート動画専用のセクションも含まれています。これらのアップデートの中心となるのは、Geminiを基盤とした機能の強化です。「Gemini」タブ内の「作成」ボタンをクリックすると、ユーザーは「Nano Banana」や「Veo」といった生成A
関連特集おすすめ
書き込み
 長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
 8 ツール
 xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

 コメント (2)
0/500
![EdwardJackson]()
The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
![RalphSanchez]()
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅
ポッドキャストPossibleの最近のエピソードで、LinkedIn共同創業者レイド・ホフマンが共同ホストを務め、Google DeepMind CEOデミス・ハサビスがGoogleの計画について興奮するニュースを共有しました。彼は、GoogleがGemini AIモデルをVeoビデオ生成モデルと統合しようとしていることを明らかにしました。この融合は、Geminiの物理世界の理解を強化し、現実のダイナミクスをより巧みに理解できるようにすることを目指しています。
ハサビスは、Geminiが最初からマルチモーダルになるように設計されていたと強調しました。「我々は常に、基盤モデルであるGeminiを最初からマルチモーダルに構築してきました」と彼は説明しました。このアプローチの動機は?日常生活で本当の意味で役立つユニバーサルデジタルアシスタントのビジョンです。「現実世界で実際にあなたを助けるアシスタント」とハサビスは詳しく述べました。
AI業界は、いわゆる「オムニ」モデル——さまざまなメディアを処理し統合できるモデル——に向かって着実に進化しています。たとえば、Googleの最新のGeminiイテレーションは、テキストだけでなくオーディオや画像も生成できます。一方、OpenAIのChatGPTデフォルトモデルは、その場で画像を生成でき、スタジオジブリ風のアートも含まれます。Amazonも遅れを取っておらず、今年後半に「any-to-any」モデルを展開する計画です。
これらのオムニモデルには、画像、ビデオ、オーディオ、テキストといった膨大なトレーニングデータが必要です。ハサビスは、Veoのビデオデータが主にYouTubeから来ていると示唆しました。YouTubeはGoogleが所有する宝の山です。「基本的に、YouTubeビデオ——大量のYouTubeビデオ——を見ることによって、[Veo 2]は世界の物理を理解できます」と彼は述べました。
Googleは以前、TechCrunchに対し、そのモデルがYouTubeクリエイターとの契約に基づいて「一部の」YouTubeコンテンツでトレーニングされている「可能性がある」と述べていました。昨年、GoogleがAIモデルのトレーニングのためにさらに多くのデータにアクセスするために利用規約を拡大したことは注目に値します。








 Gemini SparkがGoogleフォトのライブラリを管理するようになりました
Googleは、Gemini SparkがGoogle Photosライブラリを管理できるようにすることで、AI統合を拡大している。ユーザーは現在、エージェントに画像の編集、アルバムの整理、お気に入りのショットから共有コレクションの生成、コンサートフライヤーをカレンダーイベントへの変換、その他のワークフローの自動化などの指示を出すことができる。Google Photos責任者のShimrit Ben-Yair氏はX上でこれらの新機能を発表し、米国在住のGemini AI ProおよびUltra
 Geminiは、米国のユーザー向けに、無料でパーソナライズされたAI画像生成サービスを提供しています
月曜日、Googleは、「Gemini」アプリが「Nano Banana」を基盤としたパーソナライズされた画像生成機能を、より多くのユーザーに提供することを明らかにしました。本日より、米国内の条件を満たすすべてのユーザーが、この機能を無料で利用できるようになり、これまで「Plus」「Pro」「Ultra」のサブスクリプション加入者に限定されていた制限が撤廃されました。4月に初めて導入されたGemi
 Geminiの新機能がまもなくGoogle TVに統合される見込み
水曜日、GoogleはGoogle TVに導入予定の一連の新しいAI駆動型機能を公開しました。これには、YouTube Shortsをホーム画面に直接表示するショート動画専用のセクションも含まれています。これらのアップデートの中心となるのは、Geminiを基盤とした機能の強化です。「Gemini」タブ内の「作成」ボタンをクリックすると、ユーザーは「Nano Banana」や「Veo」といった生成A

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅












