


 家
Gemini API、Langchain、およびChroma DBの統合を使用してPDFで簡単にチャット
Retrieval-Augmented Generation (RAG)テクノロジーを使って、PDFドキュメントを会話のできるパートナーに変えましょう。この包括的なガイドでは、Gemini APIの高度な言語機能、Langchainのシームレスなフレームワーク、Chroma DBの効率的なベクトルストレージを使用して、PDFと対話できるインテリジェントなPythonシステムを作成する方法を示します。自然な対話を通じて、複雑なドキュメントから実用的な洞察を引き出す方法を発見してください。
キーポイント
PDFドキュメントクエリのための対話型Pythonアプリケーションの開発
高度な自然言語処理のためのGemini APIの実装
最適化された大規模言語モデルワークフローのためのLangchainの構成
Chroma DBを統合して、高性能なドキュメントインデックスを作成する
財務レポート分析を使用した実践的な実装
完全なソースコードとリソースを提供
Gemini API、Langchain、Chroma DBによるPDFチャットボットの構築
PDFインタラクションのためのRAGとLLMのパワー
検索拡張生成は、外部データ検索と言語モデルインテリジェンスを組み合わせたものです。私たちのシステムは、Gemini APIの高度な推論機能を使用しながら、Chroma DBのベクトル検索によってPDFコンテンツを動的に参照します。このアーキテクチャは、モデルの完全な再トレーニングを必要とすることなく、正確な回答を提供します。
Langchainはオーケストレーションレイヤーとして機能し、複雑なLLMオペレーションとパイプライン管理を簡素化します。Chroma DBは、ドキュメントの内容を数値埋め込みに変換することで、セマンティック検索を可能にし、関連する文章を迅速に特定できるようにします。
プロジェクトの概要ベスト・バイの2023年財務報告書とチャットする
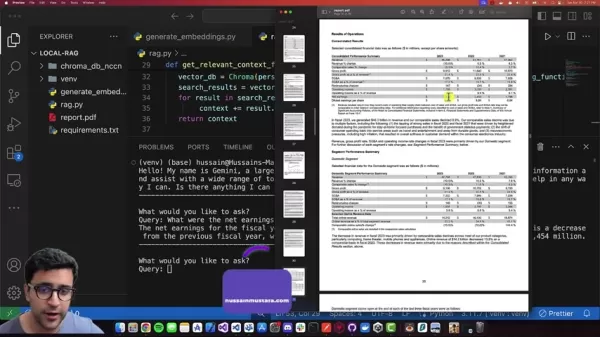
Best Buyの年次報告書を使って、実用的な財務分析ツールを実装します。これは、専門的なビジネス文書がいかにインタラクティブな知識ベースになり得るかを実証するものです。
完全な実装パッケージには、他のドキュメントタイプやユースケースに適応するために必要なコンポーネントがすべて含まれています。
報酬的を絞った質問と正確な回答
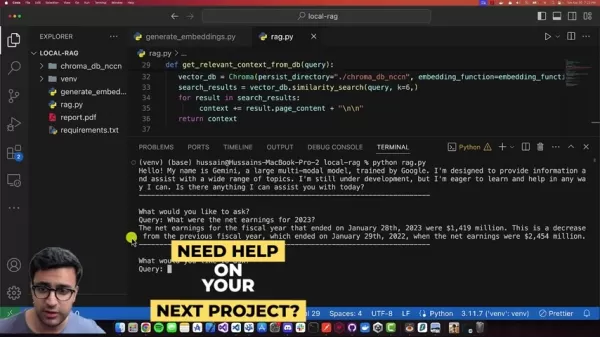
このシステムは、自然言語によるクエリで正確な純利益の数値を取得するなど、財務指標を抽出する精度の高さを示しています。
文書検索から得られる文脈の理解とGeminiの言語の熟練度が組み合わさることで、信頼できる適切な回答が得られます。
開発環境のセットアップ
仮想環境の構築
専用の仮想環境でプロジェクトの依存関係を分離します:
1.環境を初期化する:python3 -m venv venv
2.アクティベートする:
- macOS/Linux:
ソース venv/bin/activate - Windows:
venvScriptsactivate
Gemini APIキーの取得
Google AI Studioを通じてAPI認証情報を確保する:
- ai.google.devにアクセスする。
- 認証ワークフローに従う
- プロジェクトを作成または選択
- APIキーを生成し、安全に保存する
必要な依存関係のインストール
アクティベートされた環境に重要なパッケージをインストールする:
pip install langchain chromadb pypdf sentence-transformers google-generativeaiPDFチャットボットのコーディング
ライブラリのインポートとAPIキーの設定
主要なインポートには、ChromaDBコンポーネントとドキュメント処理ユーティリティが含まれます。セキュリティで保護されたキーを使用してGemini API認証を設定します。
PDFドキュメントのロード
PDFプロセッサを初期化し、以下の方法でドキュメントコレクションを作成します:
- ファイルローダパスの設定
- ドキュメントの内容を抽出する
- 処理されたデータを格納する
埋め込み設定
テ キ ス ト セグ メ ン テーシ ョ ン を設定 し て最適な処理を行 う :
- チャンクサイズの設定(1000トークン)
- オーバーラップの定義(100トークン)
- 処理効率と文脈保存のバランス
会話型PDFの長所と短所
長所
迅速な実装:モジュラーコンポーネントが開発を加速
高度な理解:Geminiはニュアンスに富んだ理解を提供
ストレージの最適化:Chromaは効率的なデータ検索を可能にする
短所
応答の正確さ:プロンプトの品質に左右される
システム要件:文書処理にリソースが必要
規模の限界:現在の文書容量の制約
PDFチャットボットの主な機能
機能内訳
システムが提供するもの
- 自然なPDFコンテンツとの対話
- 正確な質問応答
- カスタマイズ可能な柔軟なアーキテクチャ
- スケーラブルな文書処理
想定される使用例
想定されるPDFアプリケーションケース
複数のドメインに適応可能なソリューション
- 財務分析レポート解釈の自動化
- 学術研究文献レビューの高速化
- 教育支援インタラクティブな学習教材
- 法的レビュー契約分析アシスタント
よくある質問
RAGベースシステムとは何ですか?
知識検索と生成AI機能を組み合わせたハイブリッド・アーキテクチャです。
どのような文書を読み込むことができますか?
現在の実装はPDFに最適化されており、適応可能なアーキテクチャとなっています。
関連する質問
他のドキュメントタイプに適用できますか?
このフレームワークは、Langchainのドキュメント・ローダー・エコシステムを通じて、他のフォーマットへの拡張をサポートしています。DOCX、CSV、その他の形式への移行には以下が必要です:
- 適切なフォーマット専用ローダー
- コンテンツ構造の考慮
- エンベッディングの調整
回答精度を向上させるには?
強化方法
- 戦略的なテキストセグメンテーション
- 特殊な埋め込みモデル
- 高度なプロンプトエンジニアリング
- 検索手法の組み合わせ
関連記事
 MiniMax、グローバルのAI専門家に対するインセンティブを提供する「10xチームプログラム」を発表
MiniMax(稀宇科技)の汎用人工知能ラボは、グローバルな人材連携イニシアチブ「10xチーム」を正式に開始しました。このプログラムは、大規模モデルの専門分野における深い応用を探求するために、各業界のトップエキスパートを募集することを目的としています。深い業界知識と最先端のAIを統合することで、MiniMaxは汎用から専門的なシナリオへと大規模モデルの生産性を拡大し、最終的に業界の効率に「10倍の増加」をもたらすことを目指しています。業界の認知価値を検証し、マルチモーダルの中核リソースを開放す
韓国、国家AI計算センターの起工式を実施、2.5兆ウォンを投資し2028年の完成を目指す
韓国のアウトレッツ、EtNewsの報道によると、全羅南道順天のソラーシティデータセンターパークで、8月3日に韓国AI計算センター(KOACC)の起工式が行われた。総投資額2.5兆ウォン(約118億3800万元)を背景に、この施設は2028年の運用開始を目指しており、これまでに韓国がAIインフラに対して行った国家投資の中で最も大規模なものの一つとなっている。プロジェクトの株式配分は、政府と企業の深い連携を推進する戦略的な取り組みを示している。サムスンSDSが30%の株式を持つ最大株主として主導し
Linux財団を支援する6つのテックジャイアント、AI脆弱性のノイズに対処するために1,250万ドルを拠出
AI自動化ツールによって生成される低品質なセキュリティレポートの洪水に対処するため、Anthropic、Amazon(AWS)、GitHub、Google、Microsoft、OpenAIの6大テック企業が、Linux Foundationのイニシアチブに対して総額1250万ドルの資金を提供しました。この投資は、オープンソースソフトウェア(FOSS)のメンテナーが手動でのスクリーニングという負担から解放され、本格的なセキュリティ脅威に集中できることを目的としています。AI技術が脆弱性発見のハー
関連特集おすすめ
作曲
 ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
 9 ツール
 xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai
コード
リファクタリング、バグ、セキュリティ上の脆弱性を扱うGitHubチーム向けのAIプルリクエストレビューツール
2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai

 コメント (3)
0/500
![JohnWilson]()
Finally, a use for all those PDFs I've been ignoring! 🤓 This RAG thing is like giving my documents a brain. Quick question: does it work with multiple PDFs at once? I'd love to query a whole library. 😎
![RalphSmith]()
Интересно, но не слишком ли много технологий для простой задачи? 🤔 Мой знакомый разработчйк уже месяц говорит только о RAG, хотя пока не видел реальных проектов. Кто-нибудь пробовал подключить Gemini к PDF с русской кодировкой? Могут быть проблемы с кириллицей, как в прошлый раз с OpenAI API. Читал о такой системе в блоге, но там была большая задержка при обработке - вы как думаете?
![TerryHernández]()
Die Kombination von RAG mit Gemini API klingt vielversprechend! Ist das System leicht genug für lokale Deployment? 🤔 Der Datenschutz wäre dann ein großer Pluspunkt gegenüber Cloud-Lösungen.
Retrieval-Augmented Generation (RAG)テクノロジーを使って、PDFドキュメントを会話のできるパートナーに変えましょう。この包括的なガイドでは、Gemini APIの高度な言語機能、Langchainのシームレスなフレームワーク、Chroma DBの効率的なベクトルストレージを使用して、PDFと対話できるインテリジェントなPythonシステムを作成する方法を示します。自然な対話を通じて、複雑なドキュメントから実用的な洞察を引き出す方法を発見してください。
キーポイント
PDFドキュメントクエリのための対話型Pythonアプリケーションの開発
高度な自然言語処理のためのGemini APIの実装
最適化された大規模言語モデルワークフローのためのLangchainの構成
Chroma DBを統合して、高性能なドキュメントインデックスを作成する
財務レポート分析を使用した実践的な実装
完全なソースコードとリソースを提供
Gemini API、Langchain、Chroma DBによるPDFチャットボットの構築
PDFインタラクションのためのRAGとLLMのパワー
検索拡張生成は、外部データ検索と言語モデルインテリジェンスを組み合わせたものです。私たちのシステムは、Gemini APIの高度な推論機能を使用しながら、Chroma DBのベクトル検索によってPDFコンテンツを動的に参照します。このアーキテクチャは、モデルの完全な再トレーニングを必要とすることなく、正確な回答を提供します。
Langchainはオーケストレーションレイヤーとして機能し、複雑なLLMオペレーションとパイプライン管理を簡素化します。Chroma DBは、ドキュメントの内容を数値埋め込みに変換することで、セマンティック検索を可能にし、関連する文章を迅速に特定できるようにします。
プロジェクトの概要ベスト・バイの2023年財務報告書とチャットする
Best Buyの年次報告書を使って、実用的な財務分析ツールを実装します。これは、専門的なビジネス文書がいかにインタラクティブな知識ベースになり得るかを実証するものです。
完全な実装パッケージには、他のドキュメントタイプやユースケースに適応するために必要なコンポーネントがすべて含まれています。
報酬的を絞った質問と正確な回答
このシステムは、自然言語によるクエリで正確な純利益の数値を取得するなど、財務指標を抽出する精度の高さを示しています。
文書検索から得られる文脈の理解とGeminiの言語の熟練度が組み合わさることで、信頼できる適切な回答が得られます。
開発環境のセットアップ
仮想環境の構築
専用の仮想環境でプロジェクトの依存関係を分離します:
1.環境を初期化する:python3 -m venv venv
2.アクティベートする:
- macOS/Linux:
ソース venv/bin/activate - Windows:
venvScriptsactivate
Gemini APIキーの取得
Google AI Studioを通じてAPI認証情報を確保する:
- ai.google.devにアクセスする。
- 認証ワークフローに従う
- プロジェクトを作成または選択
- APIキーを生成し、安全に保存する
必要な依存関係のインストール
アクティベートされた環境に重要なパッケージをインストールする:
pip install langchain chromadb pypdf sentence-transformers google-generativeaiPDFチャットボットのコーディング
ライブラリのインポートとAPIキーの設定
主要なインポートには、ChromaDBコンポーネントとドキュメント処理ユーティリティが含まれます。セキュリティで保護されたキーを使用してGemini API認証を設定します。
PDFドキュメントのロード
PDFプロセッサを初期化し、以下の方法でドキュメントコレクションを作成します:
- ファイルローダパスの設定
- ドキュメントの内容を抽出する
- 処理されたデータを格納する
埋め込み設定
テ キ ス ト セグ メ ン テーシ ョ ン を設定 し て最適な処理を行 う :
- チャンクサイズの設定(1000トークン)
- オーバーラップの定義(100トークン)
- 処理効率と文脈保存のバランス
会話型PDFの長所と短所
長所
迅速な実装:モジュラーコンポーネントが開発を加速
高度な理解:Geminiはニュアンスに富んだ理解を提供
ストレージの最適化:Chromaは効率的なデータ検索を可能にする
短所
応答の正確さ:プロンプトの品質に左右される
システム要件:文書処理にリソースが必要
規模の限界:現在の文書容量の制約
PDFチャットボットの主な機能
機能内訳
システムが提供するもの
- 自然なPDFコンテンツとの対話
- 正確な質問応答
- カスタマイズ可能な柔軟なアーキテクチャ
- スケーラブルな文書処理
想定される使用例
想定されるPDFアプリケーションケース
複数のドメインに適応可能なソリューション
- 財務分析レポート解釈の自動化
- 学術研究文献レビューの高速化
- 教育支援インタラクティブな学習教材
- 法的レビュー契約分析アシスタント
よくある質問
RAGベースシステムとは何ですか?
知識検索と生成AI機能を組み合わせたハイブリッド・アーキテクチャです。
どのような文書を読み込むことができますか?
現在の実装はPDFに最適化されており、適応可能なアーキテクチャとなっています。
関連する質問
他のドキュメントタイプに適用できますか?
このフレームワークは、Langchainのドキュメント・ローダー・エコシステムを通じて、他のフォーマットへの拡張をサポートしています。DOCX、CSV、その他の形式への移行には以下が必要です:
- 適切なフォーマット専用ローダー
- コンテンツ構造の考慮
- エンベッディングの調整
回答精度を向上させるには?
強化方法
- 戦略的なテキストセグメンテーション
- 特殊な埋め込みモデル
- 高度なプロンプトエンジニアリング
- 検索手法の組み合わせ








 MiniMax、グローバルのAI専門家に対するインセンティブを提供する「10xチームプログラム」を発表
MiniMax(稀宇科技)の汎用人工知能ラボは、グローバルな人材連携イニシアチブ「10xチーム」を正式に開始しました。このプログラムは、大規模モデルの専門分野における深い応用を探求するために、各業界のトップエキスパートを募集することを目的としています。深い業界知識と最先端のAIを統合することで、MiniMaxは汎用から専門的なシナリオへと大規模モデルの生産性を拡大し、最終的に業界の効率に「10倍の増加」をもたらすことを目指しています。業界の認知価値を検証し、マルチモーダルの中核リソースを開放す
 韓国、国家AI計算センターの起工式を実施、2.5兆ウォンを投資し2028年の完成を目指す
韓国のアウトレッツ、EtNewsの報道によると、全羅南道順天のソラーシティデータセンターパークで、8月3日に韓国AI計算センター(KOACC)の起工式が行われた。総投資額2.5兆ウォン(約118億3800万元)を背景に、この施設は2028年の運用開始を目指しており、これまでに韓国がAIインフラに対して行った国家投資の中で最も大規模なものの一つとなっている。プロジェクトの株式配分は、政府と企業の深い連携を推進する戦略的な取り組みを示している。サムスンSDSが30%の株式を持つ最大株主として主導し
 Linux財団を支援する6つのテックジャイアント、AI脆弱性のノイズに対処するために1,250万ドルを拠出
AI自動化ツールによって生成される低品質なセキュリティレポートの洪水に対処するため、Anthropic、Amazon(AWS)、GitHub、Google、Microsoft、OpenAIの6大テック企業が、Linux Foundationのイニシアチブに対して総額1250万ドルの資金を提供しました。この投資は、オープンソースソフトウェア(FOSS)のメンテナーが手動でのスクリーニングという負担から解放され、本格的なセキュリティ脅威に集中できることを目的としています。AI技術が脆弱性発見のハー

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai

Finally, a use for all those PDFs I've been ignoring! 🤓 This RAG thing is like giving my documents a brain. Quick question: does it work with multiple PDFs at once? I'd love to query a whole library. 😎
Интересно, но не слишком ли много технологий для простой задачи? 🤔 Мой знакомый разработчйк уже месяц говорит только о RAG, хотя пока не видел реальных проектов. Кто-нибудь пробовал подключить Gemini к PDF с русской кодировкой? Могут быть проблемы с кириллицей, как в прошлый раз с OpenAI API. Читал о такой системе в блоге, но там была большая задержка при обработке - вы как думаете?
Die Kombination von RAG mit Gemini API klingt vielversprechend! Ist das System leicht genug für lokale Deployment? 🤔 Der Datenschutz wäre dann ein großer Pluspunkt gegenüber Cloud-Lösungen.












