Option
Heim
Eilmeldung
Inhalt
PatrickTaylor
PatrickTaylor
26. Mai 2026

Microsoft Research hat sein Webwright-Framework unter Open Source gestellt und wechselt damit von klickbasierten Web-Agenten zu einem codegetriebenen Ansatz. Es ermöglicht es KI-Modellen, direkt Playwright-Code sowie Bash-Befehle in einem Terminal zu schreiben und auszuführen – was die Effizienz steigert und das Umgang mit komplexer Logik erleichtert. Das minimalistische Framework verfügt über einen Selbstprüfmechanismus, um falsche Abschlussmeldungen zu verhindern, sowie über Funktionen zur Komprimierung von Verlaufsinformationen zum besseren Management des Kontextes. In Tests erreichte es hohe Genauigkeit bei Benchmarks und übertraf Basismodelle deutlich bei Aufgaben mit langen Abläufen.
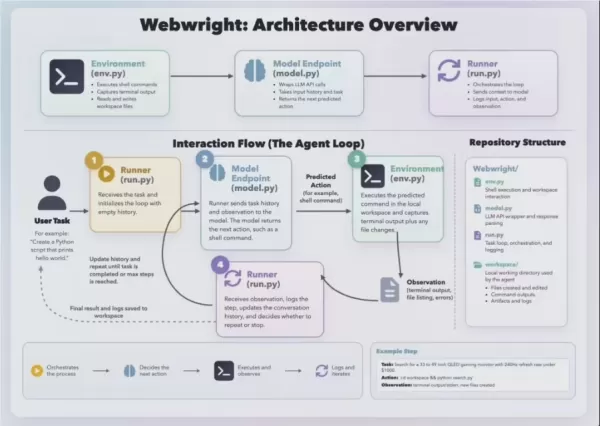
Microsoft Research hat sein Webwright-Framework unter Open Source gestellt und wechselt damit von klickbasierten Web-Agenten zu einem codegetriebenen Ansatz. Es ermöglicht es KI-Modellen, direkt Playwright-Code sowie Bash-Befehle in einem Terminal zu schreiben und auszuführen – was die Effizienz steigert und das Umgang mit komplexer Logik erleichtert. Das minimalistische Framework verfügt über einen Selbstprüfmechanismus, um falsche Abschlussmeldungen zu verhindern, sowie über Funktionen zur Komprimierung von Verlaufsinformationen zum besseren Management des Kontextes. In Tests erreichte es hohe Genauigkeit bei Benchmarks und übertraf Basismodelle deutlich bei Aufgaben mit langen Abläufen. Microsoft Research hat sein Webwright-Framework unter Open Source gestellt und wechselt damit von klickbasierten Web-Agenten zu einem codegetriebenen Ansatz. Es ermöglicht es KI-Modellen, direkt Playwright-Code sowie Bash-Befehle in einem Terminal zu schreiben und auszuführen – was die Effizienz steigert und das Umgang mit komplexer Logik erleichtert. Das minimalistische Framework verfügt über einen Selbstprüfmechanismus, um falsche Abschlussmeldungen zu verhindern, sowie über Funktionen zur Komprimierung von Verlaufsinformationen zum besseren Management des Kontextes. In Tests erreichte es hohe Genauigkeit bei Benchmarks und übertraf Basismodelle deutlich bei Aufgaben mit langen Abläufen.
Kommentare (0)
0/300
OR