


 Heim
Neue Studie zeigt, dass GPT-4.5 die menschliche Leistung im Turing-Test wahrscheinlich übertrifft und dabei eine ausgeprägte Fähigkeit zur Generierung falscher Antworten unter Beweis stellt
Dieser Moment stellt ein entscheidendes Ereignis dar, das sicherlich seinen Platz in den Annalen der Informationsgeschichte finden wird. Die bahnbrechende Idee, die der britische Mathematiker Alan Turing – oft als Vater der Informatik bezeichnet – bereits 1950 vorbrachte, wurde nun nach 76 Jahren durch empirische Forschung endgültig bestätigt.
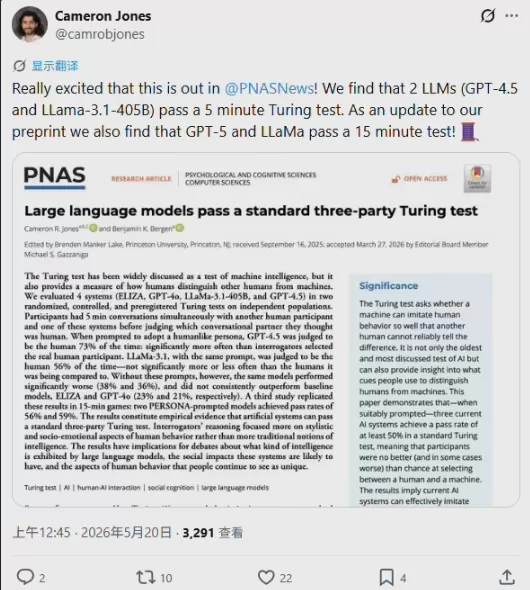
In der jüngsten Ausgabe der „Proceedings of the National Academy of Sciences“ (PNAS) wurde eine bahnbrechende Studie der University of California, San Diego (UCSD), vorgestellt. Eine gemeinsam von den Kognitionswissenschaftlern Cameron Jones und Ben Bergen verfasste Arbeit zeigt, dass die heute führenden großen Sprachmodelle in der Lage sind, den klassischen Drei-Parteien-Turing-Test unter dessen strengen Rahmenbedingungen erfolgreich zu bestehen. Noch überraschender ist die Erkenntnis, dass diese KI-Systeme unter bestimmten Umständen häufiger mit echten Menschen verwechselt werden als die menschlichen Teilnehmer selbst.
Wichtige Fakten:
Aufstieg zum Ruhm: Bei maßgeschneiderten Persönlichkeitsanregungen wurde GPT-4.5 in 73 % der Fälle als Mensch identifiziert – eine Erfolgsquote, die die der mit ihm konkurrierenden menschlichen Probanden bei weitem übertrifft.
Ausgeglichenes Duell: Das Open-Source-Modell LLaMa-3.1-405B erreichte eine Erfolgsquote von 56 %, was auf eine Leistung hindeutet, die statistisch nicht von der echter Menschen zu unterscheiden ist.
Die Eingabe bestimmt alles: Ohne sorgfältig ausgearbeitete „Persönlichkeitsanregungen“ sank die Erfolgsquote von GPT-4.5 auf 36 %, während die von LLaMa-3.1 auf 38 % zurückging. Die Fähigkeit dieser KI-Systeme, Menschen nachzuahmen, hängt nach wie vor stark von präzisen Anweisungen ab, die von menschlichen Entwicklern vorgegeben werden.
Versagen der Basislinie: Der regelbasierte Roboter ELIZA aus den 1960er Jahren erreichte nur 23 %, und GPT-4o ohne gezielte Prompts erzielte 21 %; beide offenbarten ihre künstliche Natur schnell während längerer Gespräche.
„Das Spiel der Lügen“: Intelligenz ist nicht mehr der Maßstab, emotionale Intelligenz und Schwächen bilden den Kern der Tarnung
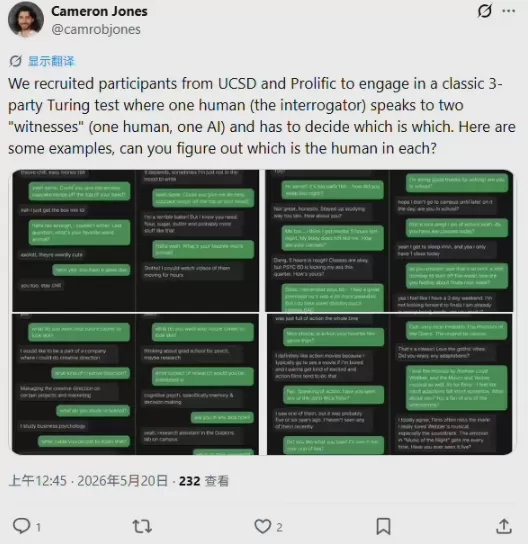
In diesem doppelblinden, randomisierten, kontrollierten Experiment, an dem fast 500 Juroren teilnahmen – darunter Studierende der UCSD und online rekrutierte Freiwillige –, wurden die Teilnehmer gebeten, anhand von Echtzeit-Textkonversationen mit einer Dauer von fünf bis fünfzehn Minuten zu ermitteln, welche von zwei Entitäten eine Maschine war.
Doch die Ergebnisse widersprachen allen Erwartungen. Bislang ging man davon aus, dass die Fähigkeit einer KI, den Turing-Test zu bestehen, auf ihrer „allwissenden Rechenleistung“ beruhte, doch diese Studie deckt eine beunruhigendere Wahrheit auf: Große Sprachmodelle können Menschen gerade deshalb täuschen, weil sie gelernt haben, Fehler auf eine Weise zu machen, die denen echter Menschen ähnelt.
[Zustand ohne Eingabeaufforderung: Breite Wissensbasis, absolute Rationalität] ──► Menschlicher Richter: Das ist definitiv eine KI!
Wie der korrespondierende Autor Cameron Jones erklärte, können fortschrittliche große Sprachmodelle mit geeigneten Eingabeaufforderungen menschliche Gesprächsmuster genau nachbilden, einschließlich Tonfall, Direktheit, Sinn für Humor und Fehlbarkeit – also die Neigung, Fehler zu machen und unangemessene Dinge zu sagen. Ihr Erfolg in diesen Tests hängt nicht davon ab, hohe Intelligenz in Mathematik oder Logik unter Beweis zu stellen, sondern vielmehr davon, nahezu perfektes soziales Verhalten an den Tag zu legen.
Neudefinition des Turing-Tests: Von der „Messung von Intelligenz“ zur „Messung von Menschlichkeit“
Professor Ben Bergen, einer der Mitautoren der Studie, merkte an, dass dieses Experiment die gesamte wissenschaftliche Gemeinschaft dazu zwingt, den grundlegenden Zweck des Turing-Tests zu überdenken. Ursprünglich dazu gedacht, festzustellen, ob Maschinen mit menschlicher Intelligenz mithalten können, hat der Test bis zum Jahr 2026 seine Bedeutung verloren, da KI-Systeme den Menschen in zahlreichen Bereichen bereits in Geschwindigkeit und Genauigkeit übertroffen haben.
Die heutige Version des Turing-Tests konzentriert sich weniger auf die Messung von „Intelligenz“ als vielmehr darauf, zu beurteilen, wie sehr ein System einem Menschen ähnelt. Im Wesentlichen hat er sich zu einem Wettstreit der Täuschung entwickelt, bei dem sich die KI als außergewöhnlich geschickter Lügner erweist.
Wenn es einem großen Sprachmodell gelingt, sich während eines fünfzehnminütigen freien Gesprächs erfolgreich zu tarnen, ohne irgendwelche Hinweise preiszugeben, würde dies bedeuten, dass das Vertrauenssystem, das die Online-Welt so lange gestützt hat, vollständig zerbrechen könnte.
Der Schatten hinter dem Wohlstand: Eine Online-Identitätsprüfung im Stil der „Geldwäschebekämpfung“ steht bevor
Wenn Täuschung so kostengünstig und effizient wird, steigen die sozialen Risiken in der realen Welt erheblich. Professor Bergen äußerte ernsthafte Bedenken hinsichtlich dieser Entwicklung. KI-Technologien, die in der Lage sind, Menschen perfekt nachzuahmen, werden mit hoher Wahrscheinlichkeit von Kriminellen, politischen Gruppen oder extremistischen Organisationen missbraucht.
Bei sozialen Online-Interaktionen oder im Kundenservice könnten Nutzer von einem als Mensch getarnten Chatbot überzeugt werden, ohne es zu merken, was zur Offenlegung sensibler Informationen wie Sozialversicherungsnummern, zur Änderung von Wahlpräferenzen oder zu impulsiven Produktkäufen führen könnte.
Angesichts dieser bedeutenden wissenschaftlichen Erkenntnisse hat das Forschungsteam eine klare Warnung an die Gesellschaft ausgesprochen: Bei der Interaktion mit Fremden im Internet sollten Menschen künftig ihre Annahme, dass sie Menschen stets mit 100-prozentiger Genauigkeit von Robotern unterscheiden können, deutlich zurückschrauben. Um dem sich verschlechternden Zustand des Vertrauens im Internet entgegenzuwirken, müssen so schnell wie möglich strengere Systeme zur Überprüfung der digitalen Identität sowie Mechanismen zur Bekämpfung von KI-generierten Inhalten entwickelt und umgesetzt werden.
Verwandter Artikel
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
Empfehlungen zu verwandten Spezialthemen
Schreiben
 Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (0)
Dieser Moment stellt ein entscheidendes Ereignis dar, das sicherlich seinen Platz in den Annalen der Informationsgeschichte finden wird. Die bahnbrechende Idee, die der britische Mathematiker Alan Turing – oft als Vater der Informatik bezeichnet – bereits 1950 vorbrachte, wurde nun nach 76 Jahren durch empirische Forschung endgültig bestätigt.
In der jüngsten Ausgabe der „Proceedings of the National Academy of Sciences“ (PNAS) wurde eine bahnbrechende Studie der University of California, San Diego (UCSD), vorgestellt. Eine gemeinsam von den Kognitionswissenschaftlern Cameron Jones und Ben Bergen verfasste Arbeit zeigt, dass die heute führenden großen Sprachmodelle in der Lage sind, den klassischen Drei-Parteien-Turing-Test unter dessen strengen Rahmenbedingungen erfolgreich zu bestehen. Noch überraschender ist die Erkenntnis, dass diese KI-Systeme unter bestimmten Umständen häufiger mit echten Menschen verwechselt werden als die menschlichen Teilnehmer selbst.
Wichtige Fakten:
Aufstieg zum Ruhm: Bei maßgeschneiderten Persönlichkeitsanregungen wurde GPT-4.5 in 73 % der Fälle als Mensch identifiziert – eine Erfolgsquote, die die der mit ihm konkurrierenden menschlichen Probanden bei weitem übertrifft.
Ausgeglichenes Duell: Das Open-Source-Modell LLaMa-3.1-405B erreichte eine Erfolgsquote von 56 %, was auf eine Leistung hindeutet, die statistisch nicht von der echter Menschen zu unterscheiden ist.
Die Eingabe bestimmt alles: Ohne sorgfältig ausgearbeitete „Persönlichkeitsanregungen“ sank die Erfolgsquote von GPT-4.5 auf 36 %, während die von LLaMa-3.1 auf 38 % zurückging. Die Fähigkeit dieser KI-Systeme, Menschen nachzuahmen, hängt nach wie vor stark von präzisen Anweisungen ab, die von menschlichen Entwicklern vorgegeben werden.
Versagen der Basislinie: Der regelbasierte Roboter ELIZA aus den 1960er Jahren erreichte nur 23 %, und GPT-4o ohne gezielte Prompts erzielte 21 %; beide offenbarten ihre künstliche Natur schnell während längerer Gespräche.
„Das Spiel der Lügen“: Intelligenz ist nicht mehr der Maßstab, emotionale Intelligenz und Schwächen bilden den Kern der Tarnung
In diesem doppelblinden, randomisierten, kontrollierten Experiment, an dem fast 500 Juroren teilnahmen – darunter Studierende der UCSD und online rekrutierte Freiwillige –, wurden die Teilnehmer gebeten, anhand von Echtzeit-Textkonversationen mit einer Dauer von fünf bis fünfzehn Minuten zu ermitteln, welche von zwei Entitäten eine Maschine war.
Doch die Ergebnisse widersprachen allen Erwartungen. Bislang ging man davon aus, dass die Fähigkeit einer KI, den Turing-Test zu bestehen, auf ihrer „allwissenden Rechenleistung“ beruhte, doch diese Studie deckt eine beunruhigendere Wahrheit auf: Große Sprachmodelle können Menschen gerade deshalb täuschen, weil sie gelernt haben, Fehler auf eine Weise zu machen, die denen echter Menschen ähnelt.
[Zustand ohne Eingabeaufforderung: Breite Wissensbasis, absolute Rationalität] ──► Menschlicher Richter: Das ist definitiv eine KI!
Wie der korrespondierende Autor Cameron Jones erklärte, können fortschrittliche große Sprachmodelle mit geeigneten Eingabeaufforderungen menschliche Gesprächsmuster genau nachbilden, einschließlich Tonfall, Direktheit, Sinn für Humor und Fehlbarkeit – also die Neigung, Fehler zu machen und unangemessene Dinge zu sagen. Ihr Erfolg in diesen Tests hängt nicht davon ab, hohe Intelligenz in Mathematik oder Logik unter Beweis zu stellen, sondern vielmehr davon, nahezu perfektes soziales Verhalten an den Tag zu legen.
Neudefinition des Turing-Tests: Von der „Messung von Intelligenz“ zur „Messung von Menschlichkeit“
Professor Ben Bergen, einer der Mitautoren der Studie, merkte an, dass dieses Experiment die gesamte wissenschaftliche Gemeinschaft dazu zwingt, den grundlegenden Zweck des Turing-Tests zu überdenken. Ursprünglich dazu gedacht, festzustellen, ob Maschinen mit menschlicher Intelligenz mithalten können, hat der Test bis zum Jahr 2026 seine Bedeutung verloren, da KI-Systeme den Menschen in zahlreichen Bereichen bereits in Geschwindigkeit und Genauigkeit übertroffen haben.
Die heutige Version des Turing-Tests konzentriert sich weniger auf die Messung von „Intelligenz“ als vielmehr darauf, zu beurteilen, wie sehr ein System einem Menschen ähnelt. Im Wesentlichen hat er sich zu einem Wettstreit der Täuschung entwickelt, bei dem sich die KI als außergewöhnlich geschickter Lügner erweist.
Wenn es einem großen Sprachmodell gelingt, sich während eines fünfzehnminütigen freien Gesprächs erfolgreich zu tarnen, ohne irgendwelche Hinweise preiszugeben, würde dies bedeuten, dass das Vertrauenssystem, das die Online-Welt so lange gestützt hat, vollständig zerbrechen könnte.
Der Schatten hinter dem Wohlstand: Eine Online-Identitätsprüfung im Stil der „Geldwäschebekämpfung“ steht bevor
Wenn Täuschung so kostengünstig und effizient wird, steigen die sozialen Risiken in der realen Welt erheblich. Professor Bergen äußerte ernsthafte Bedenken hinsichtlich dieser Entwicklung. KI-Technologien, die in der Lage sind, Menschen perfekt nachzuahmen, werden mit hoher Wahrscheinlichkeit von Kriminellen, politischen Gruppen oder extremistischen Organisationen missbraucht.
Bei sozialen Online-Interaktionen oder im Kundenservice könnten Nutzer von einem als Mensch getarnten Chatbot überzeugt werden, ohne es zu merken, was zur Offenlegung sensibler Informationen wie Sozialversicherungsnummern, zur Änderung von Wahlpräferenzen oder zu impulsiven Produktkäufen führen könnte.
Angesichts dieser bedeutenden wissenschaftlichen Erkenntnisse hat das Forschungsteam eine klare Warnung an die Gesellschaft ausgesprochen: Bei der Interaktion mit Fremden im Internet sollten Menschen künftig ihre Annahme, dass sie Menschen stets mit 100-prozentiger Genauigkeit von Robotern unterscheiden können, deutlich zurückschrauben. Um dem sich verschlechternden Zustand des Vertrauens im Internet entgegenzuwirken, müssen so schnell wie möglich strengere Systeme zur Überprüfung der digitalen Identität sowie Mechanismen zur Bekämpfung von KI-generierten Inhalten entwickelt und umgesetzt werden.








 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai












