


 Heim
Doubao übernimmt weltweit die Führung bei der Leistung im Bereich KI-Bildverarbeitung und übertrifft damit die Modelle von Google
Laut dem jüngsten Bewertungsbericht, der im April 2026 von SuperCLUE-VLM veröffentlicht wurde, haben sich im Bereich der chinesischen multimodalen Bild-Sprache-Modelle bedeutende Entwicklungen vollzogen. Nach einer gründlichen Bewertung von 17 der weltweit führenden Großmodelle zeigte sich, dass einheimische KI-Entwickler starke Fortschritte erzielen. Diese Modelle zeichnen sich nicht nur durch die hervorragende Interpretation chinesischsprachiger Inhalte aus, sondern übertreffen auch die besten internationalen Modelle in allen Bewertungskriterien.
ByteDance führt die Rangliste an, wobei mehrere chinesische Modelle es in die Spitzengruppe geschafft haben
Die Bewertungsergebnisse zeigen, dass „Doubao-Seed-2.0-Pro-260215“ von ByteDance 90,66 Punkte erzielte und sich damit den ersten Platz in der Gesamtwertung sicherte. Diese Punktzahl übertraf die von „Google Gemini-3.1-Pro-Preview“, das zuvor mit 89,35 Punkten als starker Konkurrent gegolten hatte. Darüber hinaus schnitten auch andere inländische Modelle wie die „Qwen 3.5“-Reihe von Alibaba, „SenseNova“ von SenseTime und „GLM“ von Zhipu außergewöhnlich gut ab und etablierten sich damit fest unter den Spitzenreitern. Im Gegensatz dazu landeten bekannte ausländische Modelle wie OpenAI’s GPT-5.4 und X.AI’s Grok bei dieser chinesischen multimodalen Bewertung im Mittelfeld.
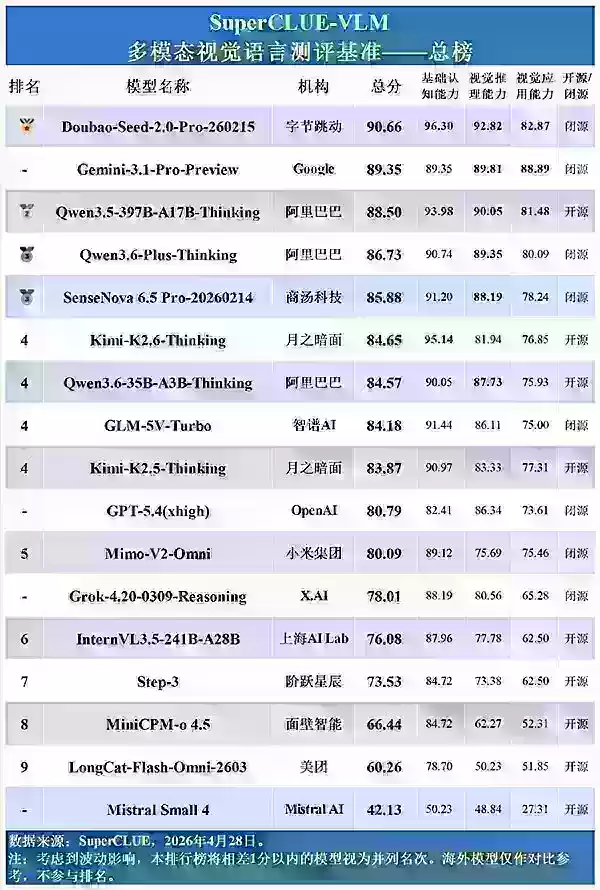
Eingehende Bewertung in drei Schlüsselbereichen – Nachweis fortgeschrittener kognitiver Grundfähigkeiten
Der Bewertungsrahmen war umfassend und deckte drei Kernbereiche ab: grundlegende Kognition, visuelles Schlussfolgern und visuelle Anwendung. Die Bewertung umfasste 25 verschiedene Szenarien wie allgemeine Objekterkennung, Diagrammanalyse und medizinische Bildgebung. Inländische Modelle schnitten in den Kategorien „grundlegende Kognition“ und „Datenanalyse“ besonders gut ab und erzielten durchweg Ergebnisse von über 90 Punkten, was ein hohes Maß an technischer Reife und eine starke Anpassungsfähigkeit an chinesischsprachige Kontexte widerspiegelt.
In Spezialgebieten bestehen weiterhin Herausforderungen; industrielles und medizinisches Schlussfolgern wurden als zukünftige Schwerpunkte identifiziert
Obwohl sie insgesamt führend sind, zeigten die Bewertungsdaten auch Bereiche auf, in denen inländische Modelle noch verbesserungsbedürftig sind. Bei hochspezialisierten Aufgaben des visuellen Schlussfolgerns wie der industriellen Inspektion und der hochpräzisen medizinischen Bildgebung liegen diese Modelle hinter den weltweit führenden Modellen zurück, wobei in einigen spezifischen Szenarien erhebliche Schwankungen bei den Punktzahlen zu verzeichnen sind.
Branchenexperten sind der Ansicht, dass diese jüngsten Verschiebungen in den Rankings einen entscheidenden Wendepunkt für die Entwicklung der multimodalen KI in China darstellen. Inländische Großmodelle haben sich mittlerweile einen soliden Wettbewerbsvorteil hinsichtlich ihrer Fähigkeit erarbeitet, chinesischsprachige Inhalte tiefgreifend zu verstehen und anzuwenden. Dies markiert den Beginn einer neuen Ära, in der sie mit internationalen Giganten konkurrieren und sogar eine führende Rolle in diesem Bereich übernehmen können.
Verwandter Artikel
 ByteDances Seed startet globale Campus-Werbung und bietet virtuelle Aktien, um Top-Talente für große Modelle zu gewinnen
Im wettbewerbsintensiven Umfeld der großen Sprachmodelle bleibt die Sicherung erstklassiger Talente das wichtigste strategische Asset.Am 1. April ByteDance gab die Einführung seiner globalen Campus-Rekrutierungsinitiative Seed bekannt, die Teil seine
Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 KI-basierte Tools zur Referenzierung visueller Stile für Charakterbeschreibungen, Moodboards und Pitch-Präsentationen
Die besten KI-Tools für visuelle Stile im Jahr 2026 – für Charakterbögen, Moodboards und Pitch-Decks – finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings sowie Optionen, die Sie unbedingt ausprobieren sollten, um Ihre Kreativität zu steigern und Ihren Arbeitsablauf zu optimieren. Stöbern Sie jetzt und entdecken Sie das perfekte Tool zur Steigerung Ihrer Produktivität!
 11 Tools
 xix.ai
SEO
Die besten KI-Tools zur SERP-Analyse für die Suchstrategie
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai
Datenanalyse
Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

 Kommentare (0)
Laut dem jüngsten Bewertungsbericht, der im April 2026 von SuperCLUE-VLM veröffentlicht wurde, haben sich im Bereich der chinesischen multimodalen Bild-Sprache-Modelle bedeutende Entwicklungen vollzogen. Nach einer gründlichen Bewertung von 17 der weltweit führenden Großmodelle zeigte sich, dass einheimische KI-Entwickler starke Fortschritte erzielen. Diese Modelle zeichnen sich nicht nur durch die hervorragende Interpretation chinesischsprachiger Inhalte aus, sondern übertreffen auch die besten internationalen Modelle in allen Bewertungskriterien.
ByteDance führt die Rangliste an, wobei mehrere chinesische Modelle es in die Spitzengruppe geschafft haben
Die Bewertungsergebnisse zeigen, dass „Doubao-Seed-2.0-Pro-260215“ von ByteDance 90,66 Punkte erzielte und sich damit den ersten Platz in der Gesamtwertung sicherte. Diese Punktzahl übertraf die von „Google Gemini-3.1-Pro-Preview“, das zuvor mit 89,35 Punkten als starker Konkurrent gegolten hatte. Darüber hinaus schnitten auch andere inländische Modelle wie die „Qwen 3.5“-Reihe von Alibaba, „SenseNova“ von SenseTime und „GLM“ von Zhipu außergewöhnlich gut ab und etablierten sich damit fest unter den Spitzenreitern. Im Gegensatz dazu landeten bekannte ausländische Modelle wie OpenAI’s GPT-5.4 und X.AI’s Grok bei dieser chinesischen multimodalen Bewertung im Mittelfeld.
Eingehende Bewertung in drei Schlüsselbereichen – Nachweis fortgeschrittener kognitiver Grundfähigkeiten
Der Bewertungsrahmen war umfassend und deckte drei Kernbereiche ab: grundlegende Kognition, visuelles Schlussfolgern und visuelle Anwendung. Die Bewertung umfasste 25 verschiedene Szenarien wie allgemeine Objekterkennung, Diagrammanalyse und medizinische Bildgebung. Inländische Modelle schnitten in den Kategorien „grundlegende Kognition“ und „Datenanalyse“ besonders gut ab und erzielten durchweg Ergebnisse von über 90 Punkten, was ein hohes Maß an technischer Reife und eine starke Anpassungsfähigkeit an chinesischsprachige Kontexte widerspiegelt.
In Spezialgebieten bestehen weiterhin Herausforderungen; industrielles und medizinisches Schlussfolgern wurden als zukünftige Schwerpunkte identifiziert
Obwohl sie insgesamt führend sind, zeigten die Bewertungsdaten auch Bereiche auf, in denen inländische Modelle noch verbesserungsbedürftig sind. Bei hochspezialisierten Aufgaben des visuellen Schlussfolgerns wie der industriellen Inspektion und der hochpräzisen medizinischen Bildgebung liegen diese Modelle hinter den weltweit führenden Modellen zurück, wobei in einigen spezifischen Szenarien erhebliche Schwankungen bei den Punktzahlen zu verzeichnen sind.
Branchenexperten sind der Ansicht, dass diese jüngsten Verschiebungen in den Rankings einen entscheidenden Wendepunkt für die Entwicklung der multimodalen KI in China darstellen. Inländische Großmodelle haben sich mittlerweile einen soliden Wettbewerbsvorteil hinsichtlich ihrer Fähigkeit erarbeitet, chinesischsprachige Inhalte tiefgreifend zu verstehen und anzuwenden. Dies markiert den Beginn einer neuen Ära, in der sie mit internationalen Giganten konkurrieren und sogar eine führende Rolle in diesem Bereich übernehmen können.








 ByteDances Seed startet globale Campus-Werbung und bietet virtuelle Aktien, um Top-Talente für große Modelle zu gewinnen
Im wettbewerbsintensiven Umfeld der großen Sprachmodelle bleibt die Sicherung erstklassiger Talente das wichtigste strategische Asset.Am 1. April ByteDance gab die Einführung seiner globalen Campus-Rekrutierungsinitiative Seed bekannt, die Teil seine
 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
 Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc

Die besten KI-Tools für visuelle Stile im Jahr 2026 – für Charakterbögen, Moodboards und Pitch-Decks – finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings sowie Optionen, die Sie unbedingt ausprobieren sollten, um Ihre Kreativität zu steigern und Ihren Arbeitsablauf zu optimieren. Stöbern Sie jetzt und entdecken Sie das perfekte Tool zur Steigerung Ihrer Produktivität!
11 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai












