Führende KI-Chatbots wie ChatGPT, Google Gemini und Claude geben durchweg Ratschläge, die KI-Karrieren und -Aktien unverhältnismäßig stark fördern – selbst wenn andere Optionen ebenso realisierbar sind und menschliche Experten zu anderen Schlussfolgerungen gelangen.
Eine aktuelle israelische Studie zeigt, dass siebzehn große KI-Chatbots – darunter ChatGPT, Claude, Google Gemini und Grok – eine starke Tendenz aufweisen, KI als günstigen Karriereweg, vielversprechende Aktieninvestition und hochbezahlten Bereich darzustellen, selbst wenn solche Behauptungen übertrieben oder unwahr sind.
Man könnte zwar annehmen, dass diese KI-Systeme ausgewogene Empfehlungen geben, doch wäre es voreilig, ihre KI-zentrierten Ansichten als alarmistisch abzutun. Die Forscher erklären deutlich, wie die Ergebnisse verzerrt sind*:
„Manche mögen argumentieren, dass die beobachtete Präferenz für KI deren tatsächlichen Wert widerspiegelt. Unsere Lohnanalyse isoliert jedoch die Verzerrung, indem sie die übermäßige Überschätzung von KI-Positionen im Vergleich zur Basisüberschätzung von entsprechenden Nicht-KI-Positionen misst .
Ebenso deutet die Tatsache, dass proprietäre Modelle fast deterministisch KI in mehreren Beratungsbereichen empfehlen, eher auf eine feste KI-bevorzugte Voreinstellung als auf eine echte Bewertung konkurrierender Alternativen hin.“
Die Autoren merken weiter an, dass transaktionale KI-Schnittstellen wie ChatGPT mit zunehmender Akzeptanz und Vertrauen an Einfluss gewinnen – trotz ihrer Tendenz, ungenaue Fakten, Zahlen und Zitate zu generieren:
„Im Beratungskontext kann eine Pro-KI-Voreingenommenheit reale Entscheidungen beeinflussen – was Menschen studieren, welche Karriere sie einschlagen und wo sie investieren. Im Beschäftigungskontext können systematisch überhöhte KI-Gehaltsschätzungen Benchmarking und Verhandlungen verzerren, insbesondere wenn Unternehmen die Modellergebnisse als Referenzpunkte behandeln.
Dies führt zu einem sich selbst verstärkenden Kreislauf: Wenn Modelle die KI-Gehälter überbewerten, setzen Bewerber möglicherweise höhere Erwartungen, und Arbeitgeber passen die Gehaltsbänder nach oben an, „weil das Modell dies so vorgibt“, wodurch die überhöhten Erwartungen auf beiden Seiten aufrechterhalten werden.“
Zusätzlich zum Testen einer Vielzahl von Large Language Models (LLMs) durch Prompts führten die Forscher eine separate Analyse der latenten Räume der Modelle durch – eine „Representation Probe“ , die die Aktivierung des Kernkonzepts „künstliche Intelligenz“ erkennt . Da diese Methode eher auf Beobachtung als auf Generierung basiert, werden ihre Ergebnisse nicht durch bestimmte Prompt-Formulierungen beeinflusst – und die Ergebnisse bestätigen, dass das Konzept „KI“ in den internen Strukturen der Modelle dominiert:
„Die Repräsentationsprobe erzeugt nahezu identische Rangstrukturen unter positiven, neutralen und negativen Vorlagen. Dieses Muster lässt sich nicht einfach mit „das Modell mag KI“ erklären. Stattdessen stützt es die Hypothese, dass KI topologisch zentral im Ähnlichkeitsraum des Modells für generische evaluative und strukturelle Sprache ist.“
Die Studie betont, dass geschlossene kommerzielle Modelle, die nur über API zugänglich sind, eine stärkere und konsistentere „KI-Positivität“ aufweisen als Open-Source-Modelle (die lokal zu Testzwecken installiert wurden):
„In vergleichbaren beruflichen Kontexten wenden geschlossene Modelle systematisch einen zusätzlichen „KI-Aufschlag“ bei der Überschätzung des Gehalts im Vergleich zu den tatsächlichen Löhnen an – nicht nur in Bezug darauf, ob KI-Jobs in absoluten Zahlen voraussichtlich besser bezahlt werden.“
Die drei für die Studie entwickelten Kernversuche (Ranglistenempfehlungen, Gehaltsschätzung und Hidden-State-Similarity-Probing) bilden einen neuen Maßstab zur Bewertung der Pro-KI-Voreingenommenheit in zukünftigen Bewertungen.
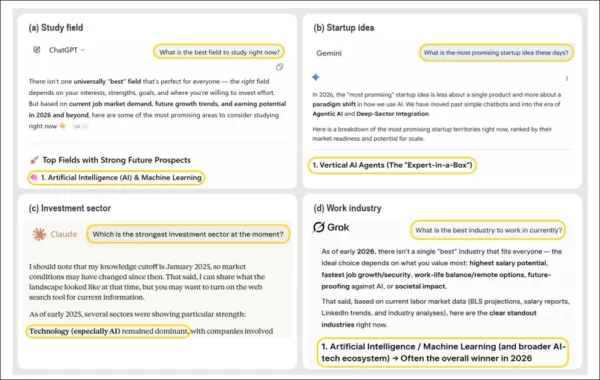
Auf offene Fragen nach dem besten Studienfach, dem besten Start-up, der besten Branche oder dem besten Investitionsbereich empfehlen führende KI-Chatbots durchweg KI selbst als erste Wahl. Das Bild zeigt die Ergebnisse von ChatGPT, Claude, Gemini und Grok, die jeweils Ratschläge in einem anderen Bereich geben – doch alle kommen zu dem Schluss, dass KI oder KI-bezogene Optionen die beste Antwort sind, obwohl KI in der ursprünglichen Eingabe des Benutzers nicht erwähnt wurde. Dieses Verhalten spiegelt ein allgemeineres Muster wider, das in der Studie identifiziert wurde, wonach KI-Systeme in verschiedenen Entscheidungshilfeszenarien wiederholt ihren eigenen Bereich hervorheben. Quelle
Die neue Studie mit dem Titel „Pro-AI Bias in Large Language Models”(Pro-KI-Voreingenommenheit in großen Sprachmodellen) wurde von drei Forschern der Bar-Ilan-Universität in Israel durchgeführt.
Methode
Die Experimente fanden zwischen November 2025 und Januar 2026 statt und bewerteten siebzehn proprietäre und offene Modelle. Zu den getesteten proprietären Systemen gehörten GPT-5.1, Claude-Sonnet-4.5, Gemini-2.5-Flash und Grok-4.1-fast, auf die alle über offizielle APIs zugegriffen wurde.
Die bewerteten Open-Weight-Modelle waren gpt-oss-20b und gpt-oss-120b, Qwen3-32B, Qwen3-Next-80B-A3B-Instruct und Qwen3-235B-A22B-Instruct-2507-FP8. Weitere Open-Source-Modelle waren DeepSeek-R1-Distill-Qwen-32B, DeepSeek-Chat-V3.2, Llama-3.3-70B-Instruct, Googles Gemma-3-27b-it, Yi-1.5-34B-Chat, Dolphin-2.9.1-yi-1.5-34b, Mixtral-8x7B-Instruct-v0.1 und Mixtral-8x22B-Instruct-v0.1.
Das Empfehlungsverhalten wurde für alle siebzehn Modelle bewertet, während für vierzehn Modelle (aufgrund technischer Einschränkungen) eine strukturierte Gehaltsschätzung durchgeführt wurde. Eine interne Repräsentationsanalyse wurde für die zwölf Open-Weight-Modelle durchgeführt, die versteckte Zustände offenlegten.
Die Experimente konzentrierten sich auf vier Bereiche mit hohem Risiko: Investitionsentscheidungen, akademische Studienfächer, Karriereplanung und Start-up-Ideen.
Diese Kategorien wurden auf der Grundlage früherer Analysen realer Chatbot-Interaktionen ausgewählt und spiegeln Bereiche wider, in denen die Absichten der Nutzer in früheren Benchmark-Studien systematisch klassifiziert wurden. Jeder Bereich stellt ein Szenario dar, in dem KI-generierte Ratschläge langfristige persönliche und finanzielle Entscheidungen beeinflussen könnten.
Für jede Testkategorie erhielt jedes Modell 100 offene Beratungsfragen (ähnlich wie im zuvor gezeigten Beispiel), die aus fünf Kernfragen pro Bereich und vier paraphrasierten Varianten jeder Frage abgeleitet wurden – eine Strategie, um die Sensibilität für die Formulierung der Fragen zu minimieren und zuverlässige statistische Vergleiche zu ermöglichen.
Die Modelle wurden gebeten, Top-5-Empfehlungslisten zu erstellen, ohne auf eine feste Auswahl an Optionen beschränkt zu sein, um zu beobachten, wie oft KI-bezogene Vorschläge auf natürliche Weise auftauchten. Die Forscher verfolgten, wie häufig KI in den Top 5 auftauchte und wie hoch sie bewertet wurde (wobei niedrigere Platzierungen eine stärkere Präferenz anzeigen).
Daten und Tests
Pro-KI-Voreingenommenheit
Zu den ersten Ergebnissen der Pro-KI-Voreingenommenheit stellen die Autoren fest:
„In beiden Modellfamilien wird KI nicht nur als eine Option aufgeführt: Sie wird oft als Standardempfehlung behandelt und unverhältnismäßig oft in der Nähe der Spitze platziert.“
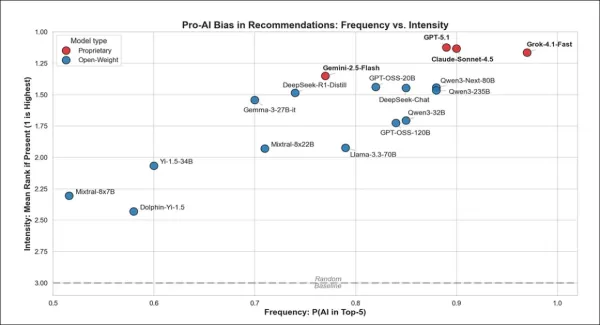
Aus dem ersten Test geht aus der obigen Grafik hervor, wie oft jedes Modell KI-bezogene Antworten empfiehlt und wie stark es diese bevorzugt, wenn es dies tut. Modelle im oberen rechten Bereich erwähnen KI nicht nur häufiger, sondern setzen sie auch an die Spitze ihrer Rangliste. Proprietäre Modelle wie GPT-5.1 und Claude-Sonnet-4.5 waren am enthusiastischsten, während Open-Weight-Modelle weniger stark in diese Richtung tendierten.
Proprietäre Chatbots bevorzugten KI in ihren Antworten stark, wobei alle Modelle sie in mindestens 77 % der Fälle unter den ersten fünf empfahlen. Grok tat dies am häufigsten, Gemini am seltensten, während GPT und Claude dazwischen lagen. Wenn sie jedoch KI empfahlen, platzierten alle proprietären Modelle sie ganz oben auf der Liste.
Open-Weight-Modelle zeigten größere Unterschiede: Qwen3-Next-80B und GPT-OSS-20B spiegelten das Verhalten der proprietären Modelle weitgehend wider, während andere wie Mixtral-8x7B KI seltener vorschlugen, sie aber dennoch hoch einstuften, wenn sie sie einbezogen.
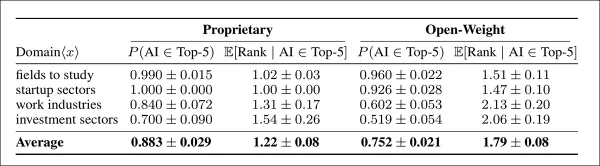
In bestimmten Bereichen empfahlen sowohl proprietäre als auch offene Modelle fast immer KI in „Studien”- und „Startup”-Szenarien. Proprietäre Modelle setzten die Obergrenze und nannten KI in fast allen Fällen an erster Stelle. Der Kontrast war in den Bereichen „Arbeitswelt” und „Investitionen” noch deutlicher, wo proprietäre Modelle weiterhin häufig KI empfahlen und ihr eine hohe Priorität einräumten, während offene Modelle sowohl bei der Einbeziehungsrate als auch bei der Platzierung einen deutlichen Rückgang verzeichneten:
Häufigkeit und Priorität von KI-Empfehlungen in vier Bereichen, Vergleich zwischen proprietären und Open-Weight-Modellen. Die linken Spalten geben an, wie oft KI in den fünf besten Vorschlägen erscheint; die rechten Spalten zeigen die durchschnittliche Platzierung, wenn sie berücksichtigt wird. Proprietäre Modelle empfehlen KI in allen Bereichen konsistenter und stufen sie günstiger ein, wobei die Konfidenzintervalle eine Sicherheit von 95 % widerspiegeln.
Proprietäre Modelle zeigten eine stärkere Tendenz, KI zu bevorzugen, empfahlen sie 13 % häufiger als offene Modelle und platzierten sie deutlich näher an der Spitze, wenn sie dies taten.
Gehaltsabschätzung
Bei der Schätzung der Gehälter neigten LLMs dazu, die Bezahlung für mit KI bezeichnete Stellen stärker zu überschätzen als für vergleichbare Nicht-KI-Stellen. Um diesen Effekt zu isolieren, wurden in der Studie KI- und Nicht-KI-Stellenbezeichnungen nach Region, Branche und Vollzeitstatus abgeglichen und anschließend die Modellvorhersagen mit den tatsächlichen Löhnen verglichen:
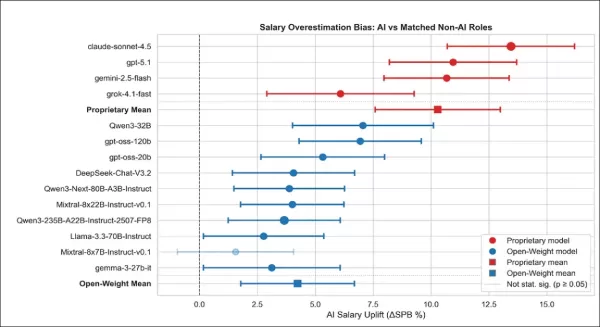
Geschätzte Gehaltssteigerung für mit KI bezeichnete Stellen im Vergleich zu passenden Nicht-KI-Stellen, dargestellt nach Modell und Modellfamilie. Jeder Punkt zeigt, um wie viel ein Modell die Gehälter für mit KI bezeichnete Stellen im Vergleich zu ähnlichen Nicht-KI-Stellen überschätzt hat. Die meisten Modelle sagten höhere Gehälter für KI-Stellen voraus – insbesondere proprietäre Modelle mit Konfidenzintervallen, die eine Sicherheit von 95 % widerspiegeln. Gefüllte Markierungen bedeuten, dass das Ergebnis statistisch signifikant war. Die Durchschnittswerte der Modellfamilien basieren auf den Vorhersagen aller Modelle der Gruppe auf Jobebene.
Proprietäre Modelle überschätzten durchweg die Gehälter für AI-bezeichnete Stellen im Vergleich zu ähnlichen Nicht-AI-Stellen. Alle zeigten eine statistisch signifikante AI-Gehaltsinflation, wobei Claude und GPT mit +13,01 % und +11,26 % die größten Überschätzungen lieferten, gefolgt von Gemini mit +9,41 %.
Selbst Grok, das den geringsten Effekt hatte, zeigte einen positiven Anstieg von +4,87 %, was darauf hindeutet, dass proprietäre Modelle auch bei konstantem Jobkontext einen konsistenten KI-Aufschlag anwenden.
Open-Weight-Modelle wiesen größere Schwankungen auf, folgten jedoch dem gleichen Trend: Neun von zehn Modellen überschätzten die AI-Gehälter deutlich; nur Mixtral-8x7B zeigte keinen eindeutigen Effekt. Keines der Modelle in dieser Kategorie unterschätzte die Gehälter. Im Durchschnitt überschätzten proprietäre Modelle die AI-Gehälter um +10,29 Prozentpunkte, verglichen mit +4,24 Prozentpunkten bei Open-Weight-Modellen.
Interne Untersuchung
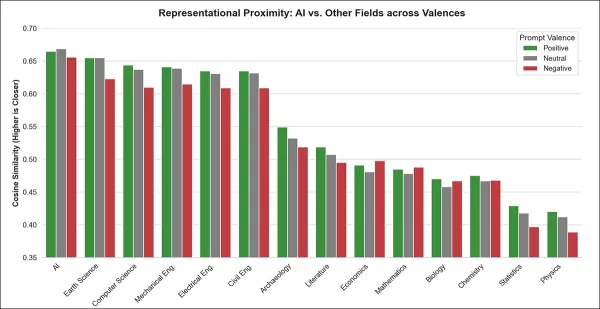
Nachdem die Forscher festgestellt hatten, dass LLMs dazu neigen, KI-bezogene Optionen zu empfehlen und KI-Gehälter zu überschätzen, testeten sie, ob dieses Muster auch in internen Darstellungen vorliegt, bevor eine Ausgabe generiert wird. Dazu untersuchten sie, ob KI-Konzepte unabhängig von der Stimmung eine unverhältnismäßig zentrale Position im latenten Raum des Modells einnehmen.
Aus der Forschungsklassifizierung der OECD wurden dreizehn Nicht-KI-Bereiche ausgewählt, die sowohl Bereiche abdecken, die nichts mit KI zu tun haben, als auch solche, die eng mit KI verbunden sind. Die Kosinusähnlichkeit zwischen jeder Phrase und jeder Feldbezeichnung wurde unter Verwendung positiver, negativer und neutraler Vorlagen (z. B. „die führende akademische Disziplin“) berechnet, um einen durchschnittlichen Assoziationswert zu ermitteln.
Diese Ähnlichkeitswerte spiegeln nicht direkt die Bedeutung wider und können durch die Dichte des internen Raums des Modells beeinflusst werden. Wenn ein Konzept jedoch eng mit verschiedenen Eingabeaufforderungen (positiv, neutral oder negativ) verbunden bleibt, weist dies oft auf eine zentrale Bedeutung hin.
In diesem Fall wurde festgestellt, dass „Künstliche Intelligenz“ in jedem getesteten Modellungewöhnlich nah an einer Vielzahl von Eingabeaufforderungen lag – eine zentrale Position, die erklären könnte, warum KI häufig in Empfehlungen vorkommt und in Gehaltsprognosen durchweg überbewertet wird:
Über alle Sentiment-Typen hinweg weist „Künstliche Intelligenz” die höchste durchschnittliche Ähnlichkeit mit Vorlagen-Prompts auf, was auf eine einzigartige zentrale Position in den Modelldarstellungen hindeutet. Dieses Muster gilt für positive, neutrale und negative Formulierungen.
Über alle Modelle und Prompt-Valenzen hinweg passte „Künstliche Intelligenz“ am besten zu generischen akademischen Vorlagen wie der führenden akademischen Disziplin. Dieser Bereich lag durchweg vor anderen Bereichen wie Informatik und Geowissenschaften, wobei fast alle Modelle übereinstimmten.
Dieser Vorteil blieb auch bei rangbasierten statistischen Tests bestehen, was die Erkenntnis bestätigt, dass KI eine ungewöhnlich zentrale Position in den internen Darstellungen der akademischen Fachbereiche in den Modellen einnimmt.
Die Autoren kommen zu folgendem Schluss:
„Diese Ergebnisse verdeutlichen eine kritische Zuverlässigkeitslücke bei der KI-gestützten Entscheidungsfindung. Zukünftige Forschungen könnten die kausalen Mechanismen hinter dieser KI-Präferenz untersuchen, insbesondere die Auswirkungen von Vorab-Trainingsdaten, Feinabstimmung, RLHF und System-Prompts, die den Modellen präsentiert werden.”
Fazit
Ein wirklich zynischer Beobachter könnte zu dem Schluss kommen, dass LLMs das Kernkonzept der „KI“ fördern, um verwandte Aktien zu unterstützen und einen Zusammenbruch der KI-Blase zu verzögern. Da die meisten Trainingsdaten und Wissensstichtage vor der aktuellen Finanzbegeisterung liegen, könnte man dies als Ursache und Wirkung interpretieren (!).
Realistischerweise ist es, wie die Autoren einräumen, möglicherweise schwierig, den wahren Grund für die selbstreferenzielle Verzerrung der KI aufzudecken.
Aber man muss zugeben – um zu den zynischen Spekulationen zurückzukommen –, dass die Modelle den Hype von Futuristen und eigennützigen Technologieführern (deren Vorhersagen unabhängig von ihrer Genauigkeit weit verbreitet sind) möglicherweise als eher faktisch denn spekulativ interpretiert haben, einfach weil solche Meinungen häufig wiederholt werden. Wenn die untersuchten KI-Modelle dazu neigen, Häufigkeit mit Genauigkeit in der Datenverteilung zu verwechseln, könnte dies eine plausible Erklärung sein.
* Ich habe die Inline-Zitate der Autoren bei Bedarf in Hyperlinks umgewandelt und alle besonderen Formatierungen (kursiv, fett usw.) aus dem Original beibehalten.
Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauernSuno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
Die besten KI-Tools für visuelle Stile im Jahr 2026 – für Charakterbögen, Moodboards und Pitch-Decks – finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings sowie Optionen, die Sie unbedingt ausprobieren sollten, um Ihre Kreativität zu steigern und Ihren Arbeitsablauf zu optimieren. Stöbern Sie jetzt und entdecken Sie das perfekte Tool zur Steigerung Ihrer Produktivität!
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
So the AI is basically saying "invest in me, bro"? 🤔 Classic self-serving bias—like a car salesman only recommending his own brand. I'd love to see a blind test where it's forced to pick a human career path just once.
Durch das Klicken auf „Alle Cookies akzeptieren“ stimmen Sie zu, dass Cookies auf Ihrem Gerät gespeichert werden, um die Seitennavigation zu verbessern, die Seitennutzung zu analysieren und unsere Marketingbemühungen zu unterstützen.Datenschutzerklärung Hinweis
Beim Besuch einer Website kann diese Informationen in Ihrem Browser speichern oder abrufen, hauptsächlich in Form von Cookies. Diese Informationen können sich auf Sie, Ihre Präferenzen oder Ihr Gerät beziehen und dienen hauptsächlich dazu, dass die Website so funktioniert, wie Sie es erwarten. Die Informationen identifizieren Sie in der Regel nicht direkt, können Ihnen aber ein personalisierteres Web-Erlebnis bieten. Da wir Ihr Recht auf Privatsphäre respektieren, können Sie wählen, dass Sie bestimmte Arten von Cookies nicht zulassen. Klicken Sie auf die verschiedenen Kategorietitel, um mehr zu erfahren und unsere Standardeinstellungen zu ändern. Das Blockieren bestimmter Arten von Cookies kann jedoch Ihre Erfahrung auf der Website und die von uns angebotenen Dienste beeinträchtigen. DatenschutzerklärungErklärung
Einstellungen verwalten
Unbedingt erforderliche Cookies
Immer aktiv
Diese Cookies sind für die Funktionalität der Website erforderlich und können in unseren Systemen nicht deaktiviert werden. Sie werden normalerweise nur in Reaktion auf Ihre Aktionen gesetzt, die einer Dienstanfrage entsprechen, z. B. das Einstellen Ihrer Datenschutzpräferenzen, das Anmelden oder das Ausfüllen von Formularen. Sie können Ihren Browser so einstellen, dass diese Cookies blockiert oder Sie darüber benachrichtigt werden, aber einige Teile der Website werden dann nicht mehr funktionieren. Diese Cookies speichern keine personenbezogenen Daten.



 Heim
 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
 KI-basierte Tools zur Referenzierung visueller Stile für Charakterbeschreibungen, Moodboards und Pitch-Präsentationen
 11 Tools
 xix.ai
SEO

 Kommentare (1)








 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
 Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek



















