


 Heim
Die Erweiterung der agentenbasierten KI erfordert fortschrittliche Speichersysteme
Agentische KI markiert einen bedeutenden Wandel von einfachen Chatbots hin zur Verwaltung komplexer Arbeitsabläufe, und ihre Skalierung erfordert einen neuen Ansatz für die Speicherarchitektur.
Da die Grundmodelle auf Billionen von Parametern anwachsen und die Kontextfenster auf Millionen von Tokens erweitert werden, übersteigt der Rechenaufwand für die Speicherung der Historie unsere Fähigkeit, diese effektiv zu verarbeiten.
Unternehmen, die diese Systeme implementieren, stoßen nun auf einen Engpass, da das immense Volumen des „Langzeitgedächtnisses” (technisch gesehen der Key-Value (KV)-Cache) die Fähigkeiten aktueller Hardware-Designs übersteigt.
Die bestehende Infrastruktur bietet nur begrenzte Möglichkeiten: Entweder wird der Inferenzkontext im knappen GPU-Speicher (HBM) mit hoher Bandbreite gespeichert oder er wird auf einen langsameren Allzweckspeicher verschoben. Die erste Option ist für große Kontexte zu kostspielig, während die zweite Option zu Latenzen führt, die agentenbasierte Interaktionen in Echtzeit unpraktisch machen.
Um diese wachsende Lücke zu schließen, die die Skalierung der agentenbasierten KI behindert, hat NVIDIA die Inference Context Memory Storage (ICMS)-Plattform innerhalb seiner Rubin-Architektur eingeführt und damit eine neue Speicherebene geschaffen, die speziell für die temporären, hohen Anforderungen des KI-Speichers entwickelt wurde.
„KI verändert den gesamten Computing-Stack – und jetzt auch den Speicher“, erklärte Huang. „KI hat sich über Chatbots mit Einzelantworten hinaus zu intelligenten Mitarbeitern entwickelt, die die physische Welt verstehen, über längere Zeiträume nachdenken, faktenbasiert bleiben, Tools für praktische Aufgaben nutzen und sowohl das Kurzzeit- als auch das Langzeitgedächtnis aufrechterhalten.“
Das zentrale operative Problem ergibt sich aus der Funktionsweise transformatorbasierter Modelle. Um zu verhindern, dass bei jedem neu generierten Wort die gesamte Konversation neu berechnet werden muss, speichern die Modelle vorherige Zustände im KV-Cache. In agentenbasierten Workflows dient dieser Cache als persistenter Speicher über Tools und Sitzungen hinweg und wächst proportional zur Sequenzlänge.
Dadurch entsteht eine einzigartige Datenkategorie. Im Gegensatz zu Finanzunterlagen oder Kundenprotokollen handelt es sich beim KV-Cache um abgeleitete Daten; er ist für die unmittelbare Leistung von entscheidender Bedeutung, benötigt jedoch nicht die robusten Haltbarkeitsgarantien von Unternehmensdateisystemen. Allzweck-Speichersysteme, die auf Standard-CPUs laufen, verbrauchen Energie für die Verwaltung und Replikation von Metadaten, von denen agentenbasierte Workloads nicht profitieren.
Die bestehende Hierarchie, die von GPU-HBM (G1) bis zu gemeinsam genutztem Speicher (G4) reicht, erweist sich zunehmend als ineffizient:
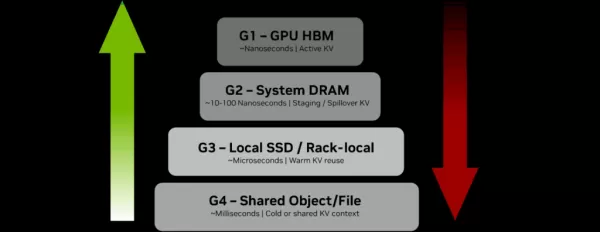
(Quelle: NVIDIA) Wenn Kontextdaten von der GPU (G1) zum System-RAM (G2) und schließlich zum gemeinsam genutzten Speicher (G4) übertragen werden, sinkt die Effizienz erheblich. Die Übertragung des aktiven Kontexts in die G4-Ebene führt zu Verzögerungen im Millisekundenbereich und erhöht die Energiekosten pro Token, wodurch teure GPUs während des Wartens auf Daten ungenutzt bleiben.
Für Unternehmen führt dies zu höheren Gesamtbetriebskosten (TCO), da Strom durch Infrastruktur-Overhead statt durch aktive Rechenaufgaben verbraucht wird.
Eine neue Speicherebene für die KI-Fabrik
Die Lösung der Branche besteht darin, dieser Hierarchie eine speziell angefertigte Ebene hinzuzufügen. Die ICMS-Plattform schafft eine „G3.5“-Ebene – eine Ethernet-verbundene Flash-Speicherebene, die speziell für groß angelegte Inferenzaufgaben entwickelt wurde.
Bei dieser Methode wird der Speicher direkt in den Rechen-Pod integriert. Durch den Einsatz des NVIDIA BlueField-4-Datenprozessors verlagert die Plattform die Verwaltung dieser Kontextdaten weg von der Host-CPU. Das System bietet Petabytes an gemeinsamer Kapazität pro Pod und verbessert die Skalierung der agentenbasierten KI, indem es Agenten ermöglicht, große Mengen an Verlaufsdaten zu speichern, ohne teure HBM zu verbrauchen.
Der operative Vorteil ist sowohl in Bezug auf den Durchsatz als auch auf den Energieverbrauch messbar. Durch die Speicherung relevanter Kontexte in dieser Zwischenschicht, die schneller als Standard-Speicher, aber kostengünstiger als HBM ist, kann das System den Speicher vorab in die GPU „vorladen”. Dies reduziert die Leerlaufzeit des GPU-Decoders und ermöglicht bis zu fünfmal höhere Tokens pro Sekunde (TPS) bei Workloads mit langem Kontext.
Aus energetischer Sicht sind die Vorteile ebenso bedeutend. Da die Architektur den Overhead von Allzweck-Speicherprotokollen eliminiert, erreicht sie eine fünfmal bessere Energieeffizienz als herkömmliche Ansätze.
Integration der Datenebene
Die Bereitstellung dieser Architektur erfordert eine Veränderung in der Sichtweise von IT-Teams auf Speichernetzwerke. Die ICMS-Plattform basiert auf NVIDIA Spectrum-X Ethernet, um die hohe Bandbreite und geringe Jitter-Konzentration zu liefern, die erforderlich sind, um Flash-Speicher fast wie lokalen Speicher zu behandeln.
Für Infrastrukturteams in Unternehmen ist die Orchestrierungsebene der wichtigste Integrationspunkt. Frameworks wie NVIDIA Dynamo und die Inference Transfer Library (NIXL) übernehmen die Bewegung von KV-Blöcken zwischen verschiedenen Ebenen.
Diese Tools arbeiten mit der Speicherschicht zusammen, um sicherzustellen, dass der richtige Kontext genau dann in den GPU-Speicher (G1) oder den Host-Speicher (G2) geladen wird, wenn das KI-Modell ihn benötigt. Das NVIDIA DOCA-Framework unterstützt dies zusätzlich durch eine KV-Kommunikationsschicht, die den Kontext-Cache als primäre Ressource behandelt.
Führende Speicheranbieter setzen diese Architektur bereits ein. Unternehmen wie AIC, Cloudian, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage, Supermicro, VAST Data und WEKA entwickeln Plattformen mit BlueField-4. Diese Lösungen werden voraussichtlich in der zweiten Hälfte dieses Jahres verfügbar sein.
Neudefinition der Infrastruktur für die Skalierung agentenbasierter KI
Die Einführung einer dedizierten Kontext-Speicherebene hat Auswirkungen auf die Kapazitätsplanung und die Gestaltung von Rechenzentren.
- Neuklassifizierung von Daten: CIOs müssen den KV-Cache als eigenständigen Datentyp anerkennen. Er ist „temporär, aber latenzempfindlich“ und unterscheidet sich damit von „dauerhaften und kalten“ Compliance-Daten. Die G3.5-Ebene verwaltet erstere, sodass sich der dauerhafte G4-Speicher auf langfristige Protokolle und Artefakte konzentrieren kann.
- Orchestrierungsreife: Der Erfolg hängt von Software ab, die Workloads intelligent zuweisen kann. Das System verwendet topologiebewusste Orchestrierung (über NVIDIA Grove), um Jobs in der Nähe ihres zwischengespeicherten Kontexts zu positionieren und so die Datenbewegung im Netzwerk zu reduzieren.
- Leistungsdichte: Durch die Unterbringung von mehr nutzbarer Kapazität auf dem gleichen Rack-Platz können Unternehmen die Lebensdauer ihrer bestehenden Einrichtungen verlängern. Dies erhöht jedoch die Rechendichte pro Quadratmeter, was eine sorgfältige Planung der Kühlung und Stromverteilung erforderlich macht.
Der Übergang zu agentenbasierter KI erfordert eine physische Neugestaltung des Rechenzentrums. Die gängige Praxis, Rechenleistung vollständig von langsamen, persistenten Speichern zu trennen, ist für die Echtzeit-Abruf-Anforderungen von Agenten mit umfangreichen Speichern ungeeignet.
Durch die Einführung einer speziellen Kontextebene können Unternehmen das Wachstum des Modellspeichers von den Kosten für GPU-HBM trennen. Diese agentenbasierte KI-Architektur ermöglicht es mehreren Agenten, einen großen Speicherpool mit geringem Stromverbrauch gemeinsam zu nutzen, wodurch die Kosten für die Bearbeitung komplexer Abfragen gesenkt und die Skalierbarkeit durch die Unterstützung von Hochdurchsatz-Schlussfolgerungen verbessert werden.
Wenn Unternehmen sich auf ihre nächste Runde von Infrastrukturinvestitionen vorbereiten, wird die Bewertung der Effizienz der Speicherhierarchie genauso wichtig sein wie die Auswahl der GPU selbst.
Siehe auch: Der KI-Chip-Krieg 2025: Was Unternehmensleiter über die Realität der Lieferkette gelernt haben
Möchten Sie mehr über KI und Big Data von Branchenführern erfahren? Besuchen Sie die AI & Big Data Expo in Amsterdam, Kalifornien und London. Die umfassende Veranstaltung ist Teil der TechEx und findet zusammen mit anderen führenden Technologieveranstaltungen statt. Klicken Sie hier für weitere Informationen.
AI News wird von TechForge Media unterstützt. Entdecken Sie hier weitere bevorstehende Veranstaltungen und Webinare zum Thema Unternehmenstechnologie.
Verwandter Artikel
 Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (0)
Agentische KI markiert einen bedeutenden Wandel von einfachen Chatbots hin zur Verwaltung komplexer Arbeitsabläufe, und ihre Skalierung erfordert einen neuen Ansatz für die Speicherarchitektur.
Da die Grundmodelle auf Billionen von Parametern anwachsen und die Kontextfenster auf Millionen von Tokens erweitert werden, übersteigt der Rechenaufwand für die Speicherung der Historie unsere Fähigkeit, diese effektiv zu verarbeiten.
Unternehmen, die diese Systeme implementieren, stoßen nun auf einen Engpass, da das immense Volumen des „Langzeitgedächtnisses” (technisch gesehen der Key-Value (KV)-Cache) die Fähigkeiten aktueller Hardware-Designs übersteigt.
Die bestehende Infrastruktur bietet nur begrenzte Möglichkeiten: Entweder wird der Inferenzkontext im knappen GPU-Speicher (HBM) mit hoher Bandbreite gespeichert oder er wird auf einen langsameren Allzweckspeicher verschoben. Die erste Option ist für große Kontexte zu kostspielig, während die zweite Option zu Latenzen führt, die agentenbasierte Interaktionen in Echtzeit unpraktisch machen.
Um diese wachsende Lücke zu schließen, die die Skalierung der agentenbasierten KI behindert, hat NVIDIA die Inference Context Memory Storage (ICMS)-Plattform innerhalb seiner Rubin-Architektur eingeführt und damit eine neue Speicherebene geschaffen, die speziell für die temporären, hohen Anforderungen des KI-Speichers entwickelt wurde.
„KI verändert den gesamten Computing-Stack – und jetzt auch den Speicher“, erklärte Huang. „KI hat sich über Chatbots mit Einzelantworten hinaus zu intelligenten Mitarbeitern entwickelt, die die physische Welt verstehen, über längere Zeiträume nachdenken, faktenbasiert bleiben, Tools für praktische Aufgaben nutzen und sowohl das Kurzzeit- als auch das Langzeitgedächtnis aufrechterhalten.“
Das zentrale operative Problem ergibt sich aus der Funktionsweise transformatorbasierter Modelle. Um zu verhindern, dass bei jedem neu generierten Wort die gesamte Konversation neu berechnet werden muss, speichern die Modelle vorherige Zustände im KV-Cache. In agentenbasierten Workflows dient dieser Cache als persistenter Speicher über Tools und Sitzungen hinweg und wächst proportional zur Sequenzlänge.
Dadurch entsteht eine einzigartige Datenkategorie. Im Gegensatz zu Finanzunterlagen oder Kundenprotokollen handelt es sich beim KV-Cache um abgeleitete Daten; er ist für die unmittelbare Leistung von entscheidender Bedeutung, benötigt jedoch nicht die robusten Haltbarkeitsgarantien von Unternehmensdateisystemen. Allzweck-Speichersysteme, die auf Standard-CPUs laufen, verbrauchen Energie für die Verwaltung und Replikation von Metadaten, von denen agentenbasierte Workloads nicht profitieren.
Die bestehende Hierarchie, die von GPU-HBM (G1) bis zu gemeinsam genutztem Speicher (G4) reicht, erweist sich zunehmend als ineffizient:
Wenn Kontextdaten von der GPU (G1) zum System-RAM (G2) und schließlich zum gemeinsam genutzten Speicher (G4) übertragen werden, sinkt die Effizienz erheblich. Die Übertragung des aktiven Kontexts in die G4-Ebene führt zu Verzögerungen im Millisekundenbereich und erhöht die Energiekosten pro Token, wodurch teure GPUs während des Wartens auf Daten ungenutzt bleiben.
Für Unternehmen führt dies zu höheren Gesamtbetriebskosten (TCO), da Strom durch Infrastruktur-Overhead statt durch aktive Rechenaufgaben verbraucht wird.
Eine neue Speicherebene für die KI-Fabrik
Die Lösung der Branche besteht darin, dieser Hierarchie eine speziell angefertigte Ebene hinzuzufügen. Die ICMS-Plattform schafft eine „G3.5“-Ebene – eine Ethernet-verbundene Flash-Speicherebene, die speziell für groß angelegte Inferenzaufgaben entwickelt wurde.
Bei dieser Methode wird der Speicher direkt in den Rechen-Pod integriert. Durch den Einsatz des NVIDIA BlueField-4-Datenprozessors verlagert die Plattform die Verwaltung dieser Kontextdaten weg von der Host-CPU. Das System bietet Petabytes an gemeinsamer Kapazität pro Pod und verbessert die Skalierung der agentenbasierten KI, indem es Agenten ermöglicht, große Mengen an Verlaufsdaten zu speichern, ohne teure HBM zu verbrauchen.
Der operative Vorteil ist sowohl in Bezug auf den Durchsatz als auch auf den Energieverbrauch messbar. Durch die Speicherung relevanter Kontexte in dieser Zwischenschicht, die schneller als Standard-Speicher, aber kostengünstiger als HBM ist, kann das System den Speicher vorab in die GPU „vorladen”. Dies reduziert die Leerlaufzeit des GPU-Decoders und ermöglicht bis zu fünfmal höhere Tokens pro Sekunde (TPS) bei Workloads mit langem Kontext.
Aus energetischer Sicht sind die Vorteile ebenso bedeutend. Da die Architektur den Overhead von Allzweck-Speicherprotokollen eliminiert, erreicht sie eine fünfmal bessere Energieeffizienz als herkömmliche Ansätze.
Integration der Datenebene
Die Bereitstellung dieser Architektur erfordert eine Veränderung in der Sichtweise von IT-Teams auf Speichernetzwerke. Die ICMS-Plattform basiert auf NVIDIA Spectrum-X Ethernet, um die hohe Bandbreite und geringe Jitter-Konzentration zu liefern, die erforderlich sind, um Flash-Speicher fast wie lokalen Speicher zu behandeln.
Für Infrastrukturteams in Unternehmen ist die Orchestrierungsebene der wichtigste Integrationspunkt. Frameworks wie NVIDIA Dynamo und die Inference Transfer Library (NIXL) übernehmen die Bewegung von KV-Blöcken zwischen verschiedenen Ebenen.
Diese Tools arbeiten mit der Speicherschicht zusammen, um sicherzustellen, dass der richtige Kontext genau dann in den GPU-Speicher (G1) oder den Host-Speicher (G2) geladen wird, wenn das KI-Modell ihn benötigt. Das NVIDIA DOCA-Framework unterstützt dies zusätzlich durch eine KV-Kommunikationsschicht, die den Kontext-Cache als primäre Ressource behandelt.
Führende Speicheranbieter setzen diese Architektur bereits ein. Unternehmen wie AIC, Cloudian, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage, Supermicro, VAST Data und WEKA entwickeln Plattformen mit BlueField-4. Diese Lösungen werden voraussichtlich in der zweiten Hälfte dieses Jahres verfügbar sein.
Neudefinition der Infrastruktur für die Skalierung agentenbasierter KI
Die Einführung einer dedizierten Kontext-Speicherebene hat Auswirkungen auf die Kapazitätsplanung und die Gestaltung von Rechenzentren.
- Neuklassifizierung von Daten: CIOs müssen den KV-Cache als eigenständigen Datentyp anerkennen. Er ist „temporär, aber latenzempfindlich“ und unterscheidet sich damit von „dauerhaften und kalten“ Compliance-Daten. Die G3.5-Ebene verwaltet erstere, sodass sich der dauerhafte G4-Speicher auf langfristige Protokolle und Artefakte konzentrieren kann.
- Orchestrierungsreife: Der Erfolg hängt von Software ab, die Workloads intelligent zuweisen kann. Das System verwendet topologiebewusste Orchestrierung (über NVIDIA Grove), um Jobs in der Nähe ihres zwischengespeicherten Kontexts zu positionieren und so die Datenbewegung im Netzwerk zu reduzieren.
- Leistungsdichte: Durch die Unterbringung von mehr nutzbarer Kapazität auf dem gleichen Rack-Platz können Unternehmen die Lebensdauer ihrer bestehenden Einrichtungen verlängern. Dies erhöht jedoch die Rechendichte pro Quadratmeter, was eine sorgfältige Planung der Kühlung und Stromverteilung erforderlich macht.
Der Übergang zu agentenbasierter KI erfordert eine physische Neugestaltung des Rechenzentrums. Die gängige Praxis, Rechenleistung vollständig von langsamen, persistenten Speichern zu trennen, ist für die Echtzeit-Abruf-Anforderungen von Agenten mit umfangreichen Speichern ungeeignet.
Durch die Einführung einer speziellen Kontextebene können Unternehmen das Wachstum des Modellspeichers von den Kosten für GPU-HBM trennen. Diese agentenbasierte KI-Architektur ermöglicht es mehreren Agenten, einen großen Speicherpool mit geringem Stromverbrauch gemeinsam zu nutzen, wodurch die Kosten für die Bearbeitung komplexer Abfragen gesenkt und die Skalierbarkeit durch die Unterstützung von Hochdurchsatz-Schlussfolgerungen verbessert werden.
Wenn Unternehmen sich auf ihre nächste Runde von Infrastrukturinvestitionen vorbereiten, wird die Bewertung der Effizienz der Speicherhierarchie genauso wichtig sein wie die Auswahl der GPU selbst.
Siehe auch: Der KI-Chip-Krieg 2025: Was Unternehmensleiter über die Realität der Lieferkette gelernt haben
Möchten Sie mehr über KI und Big Data von Branchenführern erfahren? Besuchen Sie die AI & Big Data Expo in Amsterdam, Kalifornien und London. Die umfassende Veranstaltung ist Teil der TechEx und findet zusammen mit anderen führenden Technologieveranstaltungen statt. Klicken Sie hier für weitere Informationen.
AI News wird von TechForge Media unterstützt. Entdecken Sie hier weitere bevorstehende Veranstaltungen und Webinare zum Thema Unternehmenstechnologie.








 Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
 MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai












